Plotly with custom aggregation and crosstalk
Chưa có ai nhận issue này.
- Ngôn ngữ chính
- R
- Star
- 2.7k
- Fork
- 641
- Chỉ số merge pull request
- Không có pull request nào được merge trong 30 ngày
Mô tả
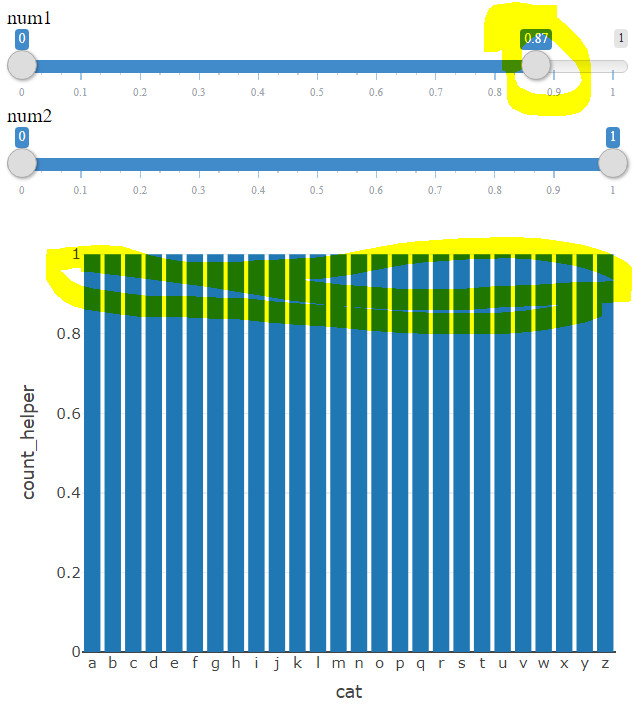
I am having trouble using plotly with custom aggregation and crosstalk. When using the crosstalk's filter, there seems to be some problem with the aggregation. When I set, for example, num1 filter to 0 - 0.87, the distribution starts to be uniform according to the plot which is not true. When using only one slider filter, the problem does not seem to be occurring. Moreover, as a rule of thumb, it seems to me that the more values I am to exclude, the more likely this issue is to happen. Here is a reprex
library(tidyverse)
library(plotly)
library(crosstalk)
library(htmltools)

dat <- tibble(
  cat = sample(letters, size = 12000, replace = T),
  num1 = runif(12000),
  num2 = runif(12000),
  count_helper = 1
)

dat_shared <- highlight_key(dat)


filters <- list(
  filter_slider("num1", "num1", dat_shared, ~num1, round = 2),
  filter_slider("num2", "num2", dat_shared, ~num2, round = 2)
)

p <- dat_shared |>
  plot_ly(
    x = ~cat,
    y = ~count_helper,
    type = 'bar',
    transforms = list(
      list(
        type = 'aggregate',
        groups = ~cat,
        aggregations = list(
          list(
            target = 'y', func = 'count', enabled = T
          )
        )
      )
    )
  )

widget_out <- tagList(
  filters,
  p
)

browsable(widget_out)
Hướng dẫn đóng góp
Bắt đầu từ đâu
- Đọc hết issue, rồi đọc hướng dẫn đóng góp của dự án.
- Bình luận trên issue rằng bạn sẽ nhận — tránh hai người làm cùng một việc.
- Fork repository và làm thay đổi trên một nhánh.
- Mở pull request có tham chiếu số hiệu của issue.
Hướng nghiên cứu
Chạy R reprex được cung cấp với cả hai điều khiển crosstalk filter_slider và phép biến đổi tổng hợp plot_ly trên cat và count_helper. Kiểm tra việc lọc ảnh hưởng đến phép tổng hợp như thế nào; hoàn thành khi các thanh sau khi lọc vẫn giữ nguyên số lượng thực tế của từng danh mục thay vì trở nên phân bố đồng đều.
Do mô hình lập chỉ mục viết ra từ nội dung của issue.
Đánh giá
- Công nghệ
- r
- Lĩnh vực
- data-visualization
- Loại issue
- Lỗi
- Độ khó
- 4/5
- Thời gian dự kiến
- 3-5 ngày
- Mức độ hoạt động
- Đình trệ
- Độ rõ ràng
- Khá rõ ràng
- Mức phù hợp với người mới
- 35/100