Plotly with custom aggregation and crosstalk
Dieses Issue hat noch niemand übernommen.
- Vorherrschende Sprache
- R
- Sterne
- 2.7k
- Forks
- 641
- PR-Merge-Kennzahlen
- Keine gemergten PRs in 30 T.
Beschreibung
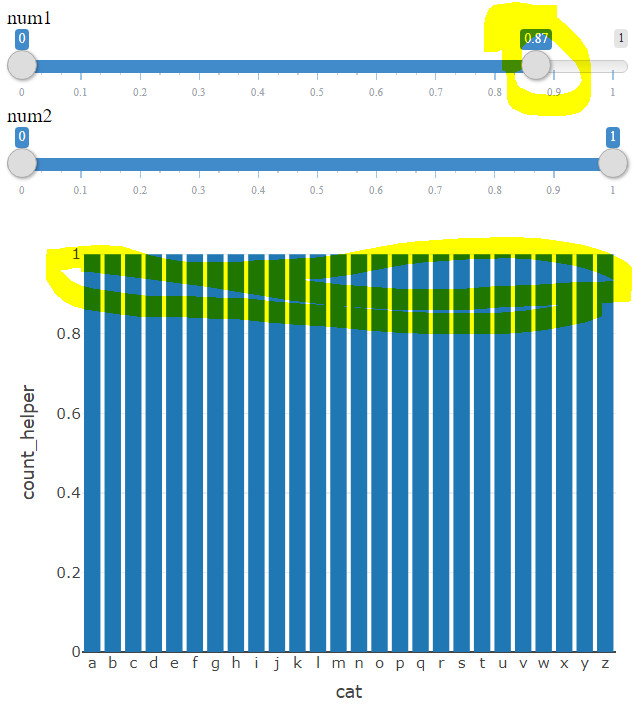
I am having trouble using plotly with custom aggregation and crosstalk. When using the crosstalk's filter, there seems to be some problem with the aggregation. When I set, for example, num1 filter to 0 - 0.87, the distribution starts to be uniform according to the plot which is not true. When using only one slider filter, the problem does not seem to be occurring. Moreover, as a rule of thumb, it seems to me that the more values I am to exclude, the more likely this issue is to happen. Here is a reprex
library(tidyverse)
library(plotly)
library(crosstalk)
library(htmltools)

dat <- tibble(
  cat = sample(letters, size = 12000, replace = T),
  num1 = runif(12000),
  num2 = runif(12000),
  count_helper = 1
)

dat_shared <- highlight_key(dat)


filters <- list(
  filter_slider("num1", "num1", dat_shared, ~num1, round = 2),
  filter_slider("num2", "num2", dat_shared, ~num2, round = 2)
)

p <- dat_shared |>
  plot_ly(
    x = ~cat,
    y = ~count_helper,
    type = 'bar',
    transforms = list(
      list(
        type = 'aggregate',
        groups = ~cat,
        aggregations = list(
          list(
            target = 'y', func = 'count', enabled = T
          )
        )
      )
    )
  )

widget_out <- tagList(
  filters,
  p
)

browsable(widget_out)
Beitragsleitfaden
Erste Schritte
- Lies das ganze Issue und danach den Beitragsleitfaden des Projekts.
- Schreib ins Issue, dass du es übernimmst — das erspart doppelte Arbeit.
- Forke das Repository und arbeite in einem Branch.
- Öffne einen Pull Request, der die Issue-Nummer nennt.
Rechercherichtung
Führe das bereitgestellte R reprex mit beiden crosstalk filter_slider-Steuerelementen und der plot_ly-Aggregatetransformation über cat und count_helper aus. Untersuche, wie sich das Filtern auf die Aggregation auswirkt; abgeschlossen ist die Aufgabe, wenn die gefilterten Balken die tatsächlichen Kategorieanzahlen beibehalten, statt gleichmäßig verteilt zu werden.
Vom Indexierungsmodell aus dem Issue-Text verfasst.
Bewertung
- Tech-Stack
- r
- Bereich
- data-visualization
- Issue-Typ
- Bug
- Schwierigkeit
- 4/5
- Geschätzter Aufwand
- 3-5 Tage
- Aktivitätsstatus
- Veraltet
- Klarheit
- Größtenteils klar
- Anfängerfreundlichkeit
- 35/100