Plotly with custom aggregation and crosstalk
Personne n'a encore pris cette issue.
- Langage dominant
- R
- Étoiles
- 2.7k
- Forks
- 641
- Métriques de merge des PR
- Aucune PR mergée en 30 j
Description
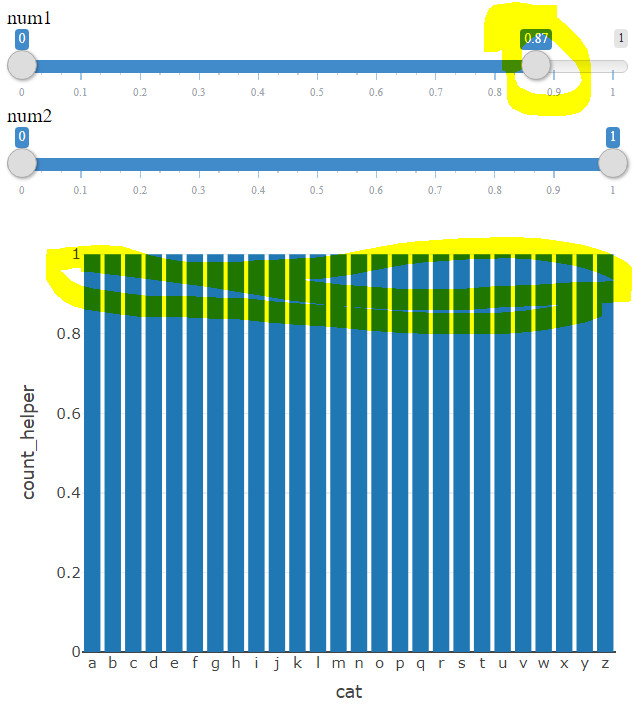
I am having trouble using plotly with custom aggregation and crosstalk. When using the crosstalk's filter, there seems to be some problem with the aggregation. When I set, for example, num1 filter to 0 - 0.87, the distribution starts to be uniform according to the plot which is not true. When using only one slider filter, the problem does not seem to be occurring. Moreover, as a rule of thumb, it seems to me that the more values I am to exclude, the more likely this issue is to happen. Here is a reprex
library(tidyverse)
library(plotly)
library(crosstalk)
library(htmltools)

dat <- tibble(
  cat = sample(letters, size = 12000, replace = T),
  num1 = runif(12000),
  num2 = runif(12000),
  count_helper = 1
)

dat_shared <- highlight_key(dat)


filters <- list(
  filter_slider("num1", "num1", dat_shared, ~num1, round = 2),
  filter_slider("num2", "num2", dat_shared, ~num2, round = 2)
)

p <- dat_shared |>
  plot_ly(
    x = ~cat,
    y = ~count_helper,
    type = 'bar',
    transforms = list(
      list(
        type = 'aggregate',
        groups = ~cat,
        aggregations = list(
          list(
            target = 'y', func = 'count', enabled = T
          )
        )
      )
    )
  )

widget_out <- tagList(
  filters,
  p
)

browsable(widget_out)
Guide de contribution
Ouvrir le guide de contribution
Par où commencer
- Lisez l'issue en entier, puis le guide de contribution du projet.
- Signalez en commentaire que vous la prenez — cela évite que deux personnes fassent le même travail.
- Forkez le dépôt et travaillez sur une branche.
- Ouvrez une pull request qui référence le numéro de l'issue.
Piste de recherche
Exécutez le R reprex fourni avec les deux contrôles crosstalk filter_slider et la transformation d’agrégation plot_ly sur cat et count_helper. Examinez l’effet du filtrage sur l’agrégation ; le travail est terminé lorsque les barres filtrées conservent les décomptes réels des catégories au lieu de devenir uniformément réparties.
Rédigé par le modèle d'indexation à partir du texte de l'issue.
Évaluation
- Stack technique
- r
- Domaine
- data-visualization
- Type d'issue
- Bug
- Difficulté
- 4/5
- Temps estimé
- 3-5 jours
- Activité
- À l'abandon
- Clarté
- Plutôt claire
- Accessibilité débutants
- 35/100