Plotly with custom aggregation and crosstalk
Nadie ha tomado este issue todavía.
- Lenguaje dominante
- R
- Estrellas
- 2.7k
- Forks
- 641
- Métricas de merge de PR
- Sin PR fusionados en 30 d
Descripción
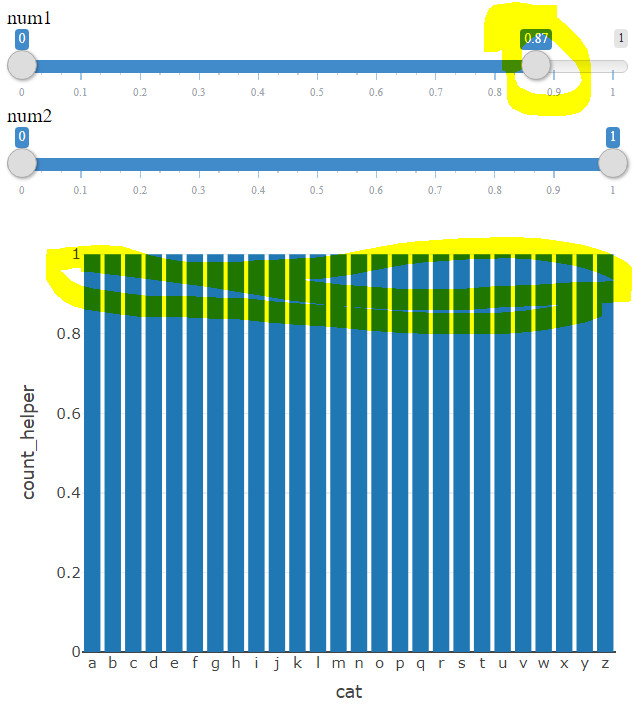
I am having trouble using plotly with custom aggregation and crosstalk. When using the crosstalk's filter, there seems to be some problem with the aggregation. When I set, for example, num1 filter to 0 - 0.87, the distribution starts to be uniform according to the plot which is not true. When using only one slider filter, the problem does not seem to be occurring. Moreover, as a rule of thumb, it seems to me that the more values I am to exclude, the more likely this issue is to happen. Here is a reprex
library(tidyverse)
library(plotly)
library(crosstalk)
library(htmltools)

dat <- tibble(
  cat = sample(letters, size = 12000, replace = T),
  num1 = runif(12000),
  num2 = runif(12000),
  count_helper = 1
)

dat_shared <- highlight_key(dat)


filters <- list(
  filter_slider("num1", "num1", dat_shared, ~num1, round = 2),
  filter_slider("num2", "num2", dat_shared, ~num2, round = 2)
)

p <- dat_shared |>
  plot_ly(
    x = ~cat,
    y = ~count_helper,
    type = 'bar',
    transforms = list(
      list(
        type = 'aggregate',
        groups = ~cat,
        aggregations = list(
          list(
            target = 'y', func = 'count', enabled = T
          )
        )
      )
    )
  )

widget_out <- tagList(
  filters,
  p
)

browsable(widget_out)
Guía de contribución
Primeros pasos
- Lee el issue completo y luego la guía de contribución del proyecto.
- Comenta en el issue que vas a ocuparte — evita que dos personas hagan lo mismo.
- Haz un fork del repositorio y trabaja en una rama.
- Abre un pull request que haga referencia al número del issue.
Línea de trabajo
Ejecuta el R reprex proporcionado con ambos controles crosstalk filter_slider y la transformación de agregación de plot_ly sobre cat y count_helper. Inspecciona cómo afecta el filtrado a la agregación; se considera terminado cuando las barras filtradas conservan los recuentos reales de las categorías en lugar de distribuirse uniformemente.
Escrito por el modelo de indexación a partir del texto del issue.
Evaluación
- Stack tecnológico
- r
- Área
- data-visualization
- Tipo de issue
- Error
- Dificultad
- 4/5
- Tiempo estimado
- 3-5 días
- Estado de actividad
- Estancado
- Claridad
- Bastante claro
- Aptitud para principiantes
- 35/100