Plotly with custom aggregation and crosstalk
Nessuno ha ancora preso questa issue.
- Lingua principale
- R
- Stelle
- 2.7k
- Fork
- 641
- Metriche di merge delle PR
- Nessuna PR unita negli ultimi 30g
Descrizione
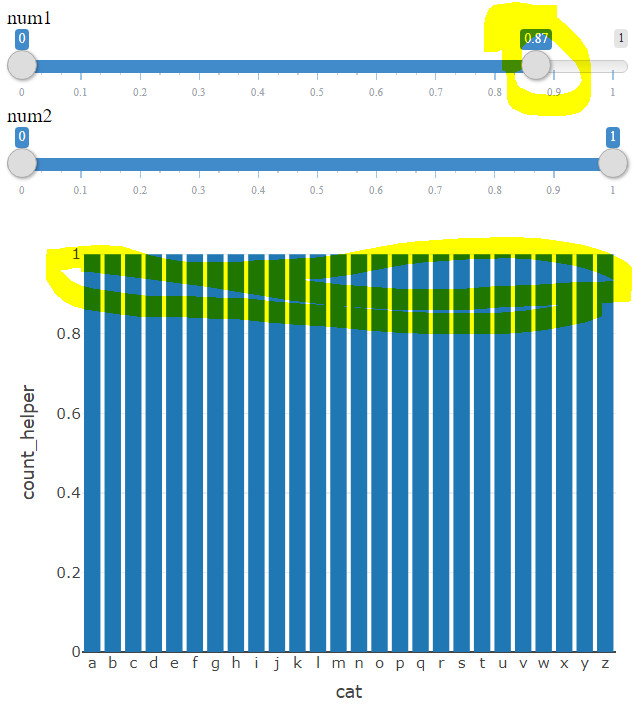
I am having trouble using plotly with custom aggregation and crosstalk. When using the crosstalk's filter, there seems to be some problem with the aggregation. When I set, for example, num1 filter to 0 - 0.87, the distribution starts to be uniform according to the plot which is not true. When using only one slider filter, the problem does not seem to be occurring. Moreover, as a rule of thumb, it seems to me that the more values I am to exclude, the more likely this issue is to happen. Here is a reprex
library(tidyverse)
library(plotly)
library(crosstalk)
library(htmltools)

dat <- tibble(
  cat = sample(letters, size = 12000, replace = T),
  num1 = runif(12000),
  num2 = runif(12000),
  count_helper = 1
)

dat_shared <- highlight_key(dat)


filters <- list(
  filter_slider("num1", "num1", dat_shared, ~num1, round = 2),
  filter_slider("num2", "num2", dat_shared, ~num2, round = 2)
)

p <- dat_shared |>
  plot_ly(
    x = ~cat,
    y = ~count_helper,
    type = 'bar',
    transforms = list(
      list(
        type = 'aggregate',
        groups = ~cat,
        aggregations = list(
          list(
            target = 'y', func = 'count', enabled = T
          )
        )
      )
    )
  )

widget_out <- tagList(
  filters,
  p
)

browsable(widget_out)
Guida per i contributori
Apri la guida per i contributori
Come iniziare
- Leggi tutta la issue e poi la guida ai contributi del progetto.
- Commenta sulla issue per dire che te ne occupi tu — evita che due persone facciano lo stesso lavoro.
- Fai un fork del repository e lavora su un branch.
- Apri una pull request che faccia riferimento al numero della issue.
Direzione di ricerca
Esegui il R reprex fornito con entrambi i controlli crosstalk filter_slider e la trasformazione di aggregazione di plot_ly su cat e count_helper. Esamina in che modo il filtraggio influisce sull’aggregazione; il lavoro è completato quando le barre filtrate mantengono i conteggi effettivi delle categorie invece di diventare distribuite uniformemente.
Scritto dal modello di indicizzazione a partire dal testo della issue.
Valutazione
- Stack tecnologico
- r
- Ambito
- data-visualization
- Tipo di issue
- Bug
- Difficoltà
- 4/5
- Tempo stimato
- 3-5 giorni
- Stato di attività
- Ferma
- Chiarezza
- Abbastanza chiara
- Idoneità per principianti
- 35/100