ClassImbalanceDataCheck should use n_folds instead of 2 * n_folds
- 主要语言
- Python
- 星标
- 850
- 派生
- 96
- PR 合并指标
- 30 天内没有已合并 PR
描述
Repro with the `abalone_trimmed.csv` dataset. I manually modified it so that the least common class has 9 instances.
```python
from evalml.automl.utils import make_data_splitter
from evalml.automl import AutoMLSearch
from evalml.data_checks import ClassImbalanceDataCheck
import pandas as pd
import pytest
X = pd.read_csv("/Users/freddy.boulton/Downloads/abalone_trimmed.csv")
y = X.pop(" rings")
assert y.value_counts().min() == 9
assert ClassImbalanceDataCheck(num_cv_folds=5).validate(X, y)['errors'][0]["code"] == 'CLASS_IMBALANCE_BELOW_FOLDS'
splitter = make_data_splitter(X, y, problem_type="multiclass", n_splits=5)
automl = AutoMLSearch(X, y, "multiclass", data_splitter=splitter, max_iterations=3)
automl.search()
assert ClassImbalanceDataCheck(num_cv_folds=10).validate(X, y)['errors'][0]["code"] == 'CLASS_IMBALANCE_BELOW_FOLDS'
splitter = make_data_splitter(X, y, problem_type="multiclass", n_splits=10)
automl = AutoMLSearch(X, y, "multiclass", data_splitter=splitter, max_iterations=3)
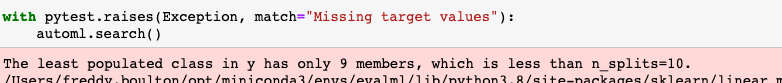
with pytest.raises(Exception, match="Missing target values"):
automl.search()
```
Note that using 5 folds does not cause an error even though we raise a data check error. Using n_splits=10 does cause an error. I think we should use `n_folds` instead of `2 * n_folds` in the `ClassImbalanceDataCheck`, sklearn also warns us about being less than `n_folds` not `2 * n_folds`
贡献指南
评估
这个 Issue 还没有评估数据。