4paradigm / 4paradigm/OpenMLDB
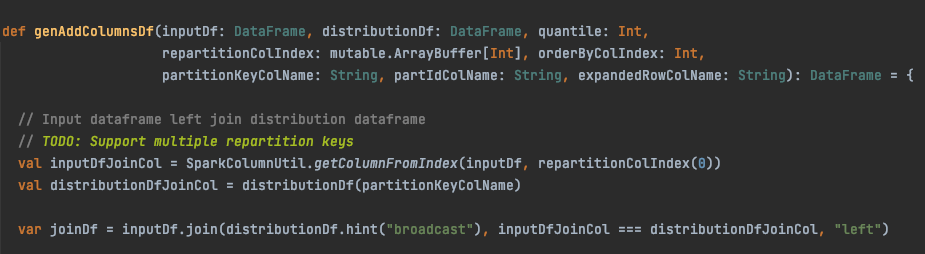
Bug: Can't use broadcast join when genAddColumnsDf
- Linguagem predominante
- C++
- Estrelas
- 1.7k
- Forks
- 331
- Merge médio
- 12d 12h
- PRs com merge (30d)
- 1
Descrição
- 
```
SELECT
sum(vendor_id) over w as w_sum_vendor_id,
max(vendor_id) over w as w_max_vendor_id,
min(vendor_id) over w as w_min_vendor_id,
avg(vendor_id) over w as w_avg_vendor_id,
sum(pickup_longitude) over w as w_sum_pickup_longitude,
max(pickup_longitude) over w as w_max_pickup_longitude,
min(pickup_longitude) over w as w_min_pickup_longitude,
avg(pickup_longitude) over w as w_avg_pickup_longitude,
sum(vendor_id) over w2 as w2_sum_vendor_id,
max(vendor_id) over w2 as w2_max_vendor_id,
min(vendor_id) over w2 as w2_min_vendor_id,
avg(vendor_id) over w2 as w2_avg_vendor_id,
sum(pickup_longitude) over w2 as w2_sum_pickup_longitude,
max(pickup_longitude) over w2 as w2_max_pickup_longitude,
min(pickup_longitude) over w2 as w2_min_pickup_longitude,
avg(pickup_longitude) over w2 as w2_avg_pickup_longitude
FROM taxi
WINDOW w as (partition by vendor_id order by pickup_datetime ROWS BETWEEN 30000 PRECEDING AND CURRENT ROW),
w2 as (partition by vendor_id order by dropoff_datetime ROWS BETWEEN 30000 PRECEDING AND CURRENT ROW)
```
- Normally, it can use broadcast join in window skew optimization, because of small broadcast join table(< 10M)
- However, when remove hint, it will use sortMerge join in window skew optimization because of inaccurate estimates of spark.
Guia de contribuição
Direção de pesquisa
The issue is about window skew optimization and join strategy selection in Spark SQL within OpenMLDB. Examine the window function logic and join hint removal in the query optimizer. Look at the code handling broadcast join estimation and window skew optimization, likely in the Spark SQL integration or query planner. A linked pull request #490 is merged, so check if it resolved the issue and what changes were made.
Escrita pelo modelo de indexação a partir do texto da issue.
Avaliação
- Stack de tecnologia
- spark, sql
- Domínio
- databases, machine-learning, performance
- Tipo de issue
- Bug
- Dificuldade
- 4/5
- Tempo estimado
- 3-5 dias
- Status de atividade
- Estagnada
- Clareza
- Razoavelmente clara
- Facilidade para iniciantes
- 30/100