Is it normal if PD leader is eating a lot of CPU resource in patrolRegions?
- Dominant language
- Go
- Stars
- 1.2k
- Forks
- 783
- Avg merge
- 5d 21h
- Merged PRs (30d)
- 36
Description
## General Question
I'm using PD v5.3.1 with the same TiDB and TiKV version. I'm experimenting with 2 different cluster and the PD leader of both cluster is taking very high CPU (>70%) while non-leader PDs were rarely in the top CPU usages list.
These are recent log of PD leader and the cluster is still working well
```
[2022/05/16 14:33:09.339 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=217.005132ms] [prev-physical=2022/05/16 14:33:09.122 +00:00] [now=2022/05/16 14:33:09.339 +00:00] [update-physical-interval=50ms]
[2022/05/16 14:33:14.153 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=337.544955ms] [prev-physical=2022/05/16 14:33:13.816 +00:00] [now=2022/05/16 14:33:14.153 +00:00] [update-physical-interval=50ms]
[2022/05/16 14:33:17.987 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=168.756395ms] [prev-physical=2022/05/16 14:33:17.818 +00:00] [now=2022/05/16 14:33:17.987 +00:00] [update-physical-interval=50ms]
[2022/05/16 14:34:04.988 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=222.556223ms] [prev-physical=2022/05/16 14:34:04.766 +00:00] [now=2022/05/16 14:34:04.988 +00:00] [update-physical-interval=50ms]
[2022/05/16 14:34:43.953 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=185.908246ms] [prev-physical=2022/05/16 14:34:43.767 +00:00] [now=2022/05/16 14:34:43.953 +00:00] [update-physical-interval=50ms]
[2022/05/16 14:35:08.229 +00:00] [INFO] [grpc_service.go:1345] ["update service GC safe point"] [service-id=gc_worker] [expire-at=9223372036854775807] [safepoint=433248300739067904]
[2022/05/16 14:36:48.413 +00:00] [INFO] [grpc_service.go:1279] ["updated gc safe point"] [safe-point=433248300739067904]
[2022/05/16 14:37:14.460 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=194.182377ms] [prev-physical=2022/05/16 14:37:14.266 +00:00] [now=2022/05/16 14:37:14.460 +00:00] [update-physical-interval=50ms]
[2022/05/16 14:38:20.833 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=214.155631ms] [prev-physical=2022/05/16 14:38:20.619 +00:00] [now=2022/05/16 14:38:20.833 +00:00] [update-physical-interval=50ms]
[2022/05/16 14:43:23.747 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=174.769084ms] [prev-physical=2022/05/16 14:43:23.573 +00:00] [now=2022/05/16 14:43:23.747 +00:00] [update-physical-interval=50ms]
[2022/05/16 14:43:32.056 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=179.763596ms] [prev-physical=2022/05/16 14:43:31.876 +00:00] [now=2022/05/16 14:43:32.056 +00:00] [update-physical-interval=50ms]
[2022/05/16 14:43:32.382 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=256.983592ms] [prev-physical=2022/05/16 14:43:32.125 +00:00] [now=2022/05/16 14:43:32.382 +00:00] [update-physical-interval=50ms]
[2022/05/16 14:43:32.576 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=160.417011ms] [prev-physical=2022/05/16 14:43:32.415 +00:00] [now=2022/05/16 14:43:32.576 +00:00] [update-physical-interval=50ms]
[2022/05/16 14:45:08.191 +00:00] [INFO] [grpc_service.go:1345] ["update service GC safe point"] [service-id=gc_worker] [expire-at=9223372036854775807] [safepoint=433248458025205760]
[2022/05/16 14:46:48.521 +00:00] [INFO] [grpc_service.go:1279] ["updated gc safe point"] [safe-point=433248458025205760]
[2022/05/16 14:48:09.757 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=191.146491ms] [prev-physical=2022/05/16 14:48:09.566 +00:00] [now=2022/05/16 14:48:09.757 +00:00] [update-physical-interval=50ms]
[2022/05/16 14:54:43.118 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=152.19005ms] [prev-physical=2022/05/16 14:54:42.966 +00:00] [now=2022/05/16 14:54:43.118 +00:00] [update-physical-interval=50ms]
[2022/05/16 14:55:08.170 +00:00] [INFO] [grpc_service.go:1345] ["update service GC safe point"] [service-id=gc_worker] [expire-at=9223372036854775807] [safepoint=433248615298498560]
[2022/05/16 14:56:48.303 +00:00] [INFO] [grpc_service.go:1279] ["updated gc safe point"] [safe-point=433248615298498560]
[2022/05/16 14:58:04.293 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=167.239101ms] [prev-physical=2022/05/16 14:58:04.126 +00:00] [now=2022/05/16 14:58:04.293 +00:00] [update-physical-interval=50ms]
[2022/05/16 14:59:46.611 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=183.30618ms] [prev-physical=2022/05/16 14:59:46.427 +00:00] [now=2022/05/16 14:59:46.611 +00:00] [update-physical-interval=50ms]
[2022/05/16 15:04:00.305 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=153.263358ms] [prev-physical=2022/05/16 15:04:00.152 +00:00] [now=2022/05/16 15:04:00.305 +00:00] [update-physical-interval=50ms]
[2022/05/16 15:05:02.290 +00:00] [WARN] [tso.go:314] ["clock offset"] [jet-lag=174.986081ms] [prev-physical=2022/05/16 15:05:02.115 +00:00] [now=2022/05/16 15:05:02.290 +00:00] [update-physical-interval=50ms]
[2022/05/16 15:05:08.189 +00:00] [INFO] [grpc_service.go:1345] ["update service GC safe point"] [service-id=gc_worker] [expire-at=9223372036854775807] [safepoint=433248772598267904]
```
The attached file is my 30s profiling
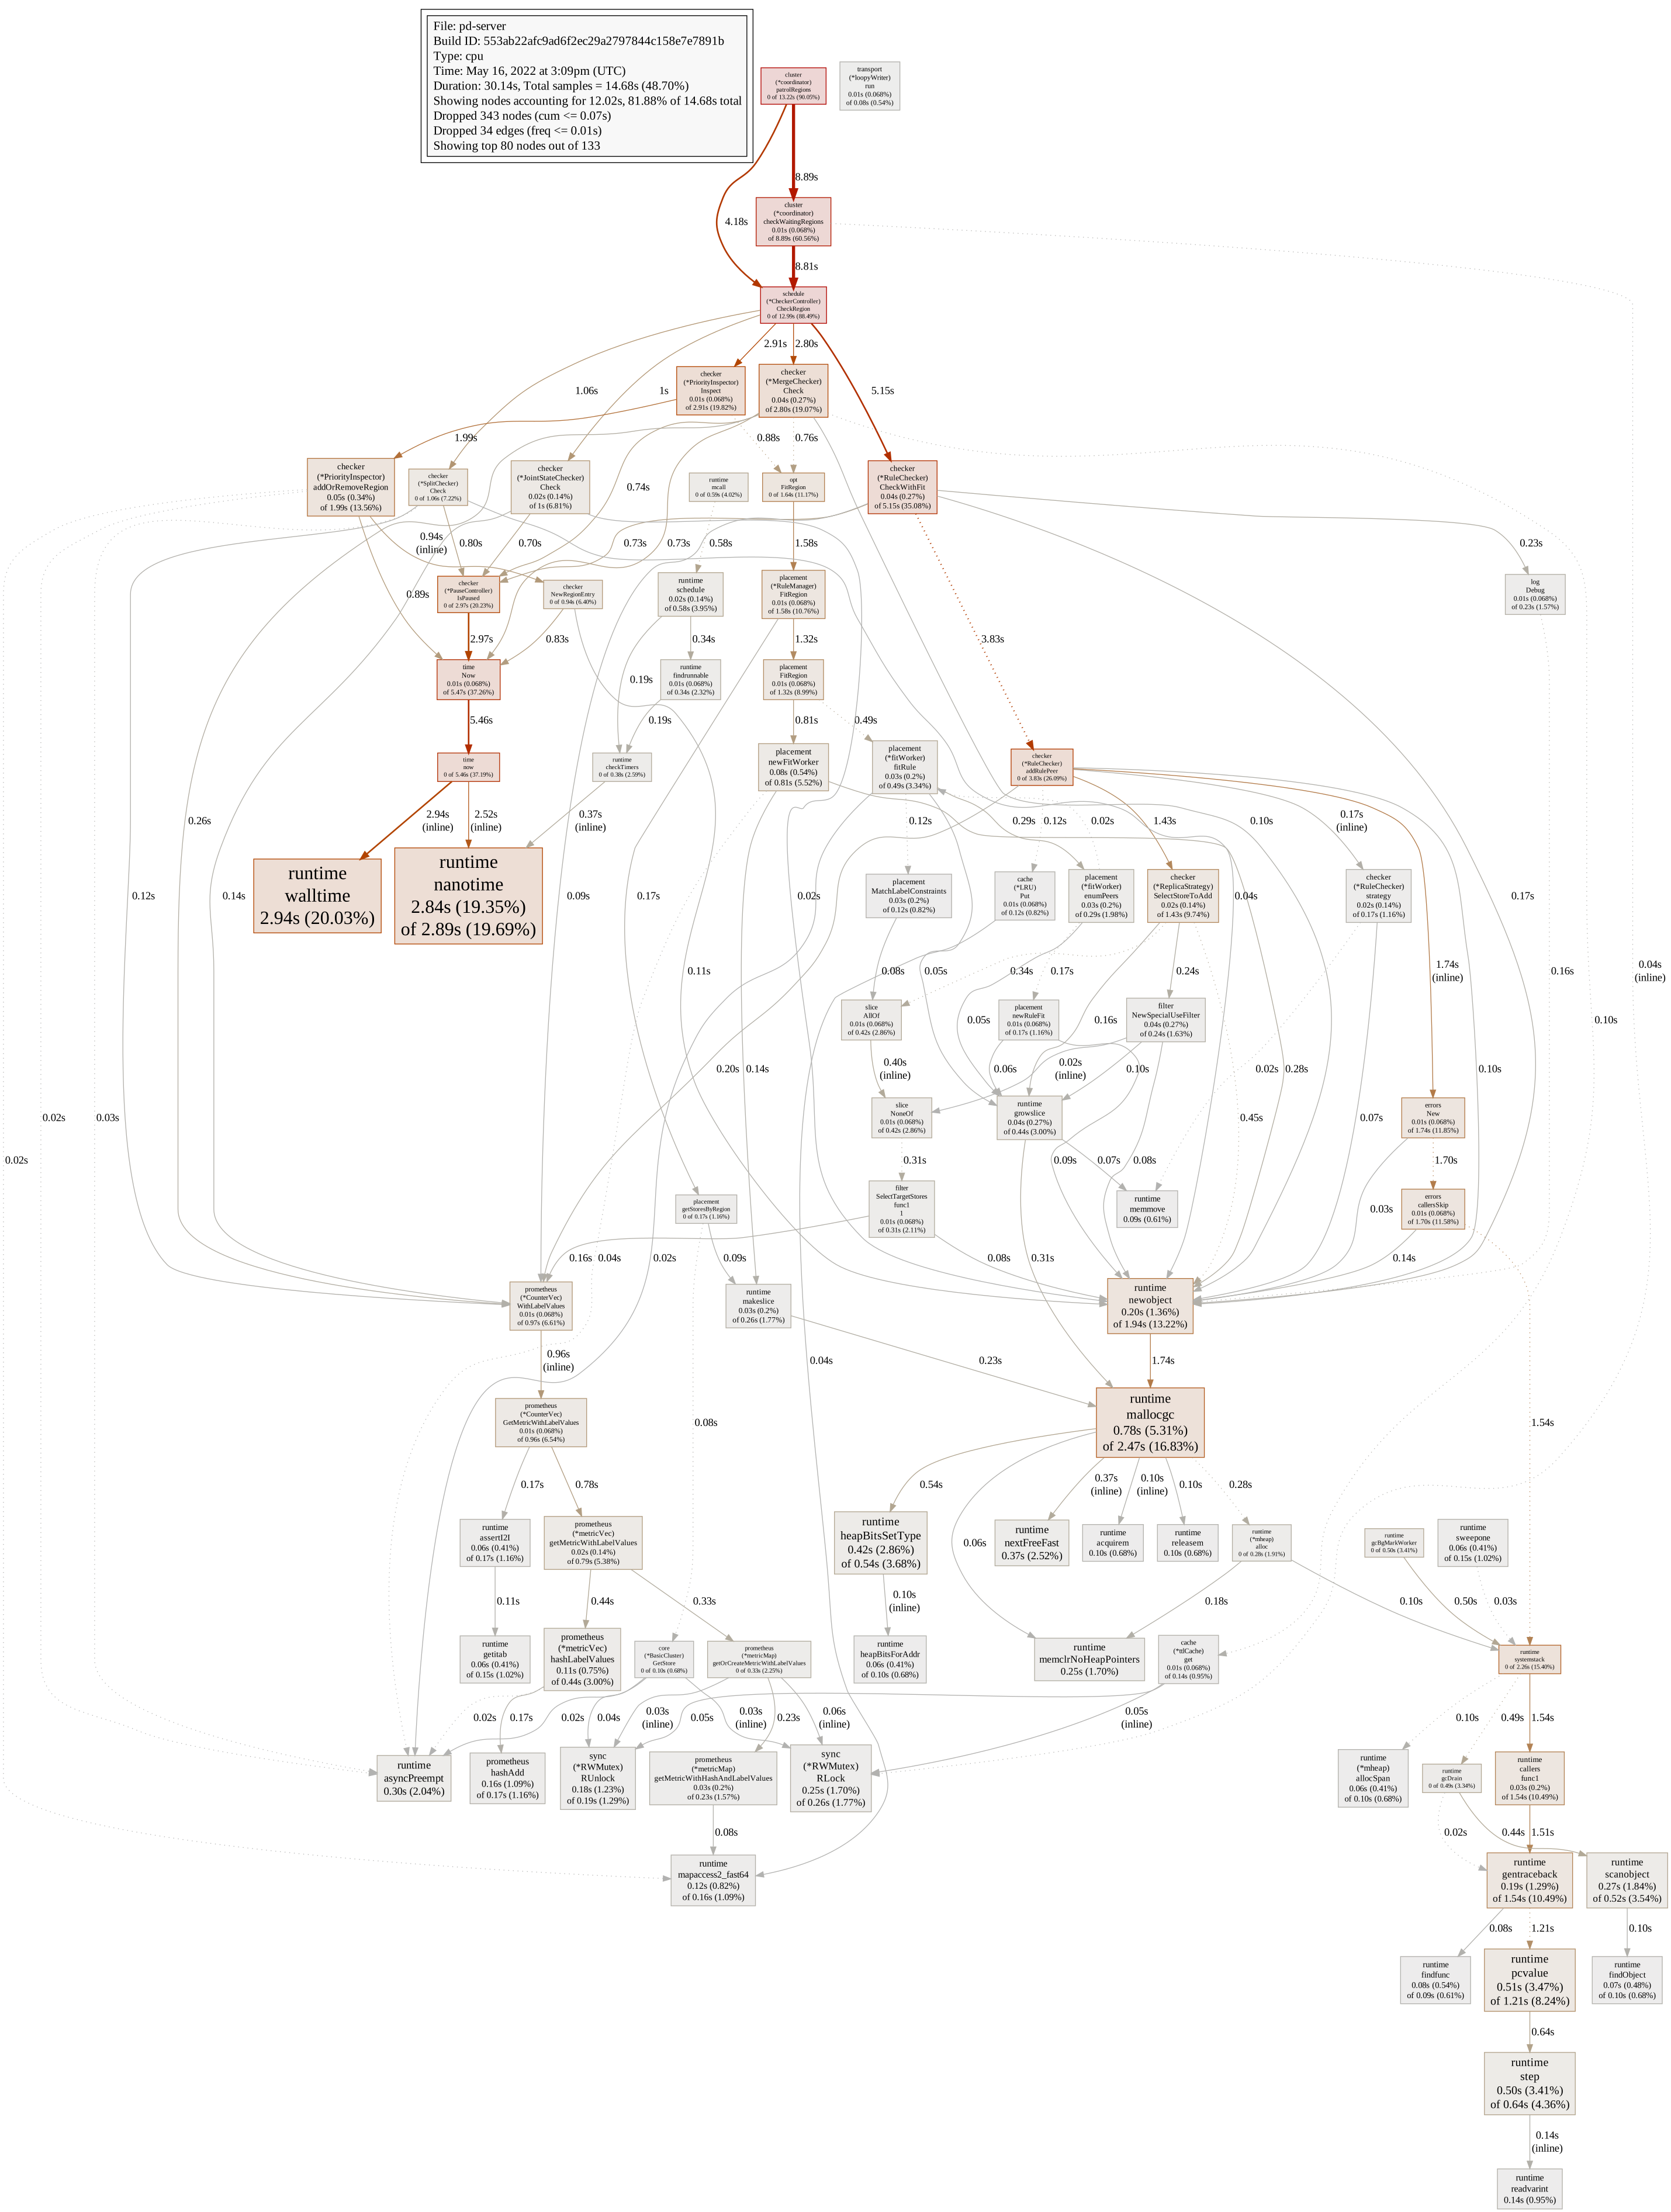
According to the profiling result above, is it safe for me if I increase the value of `patrol-region-interval` to let's say 30 seconds to reduce CPU usage?
Besides, should this task be sharded to PD followers to balance the workload?
Contributor guide
Assessment
This issue has not been assessed yet.