codestates / codestates/ds-blog
[정유태] 금융 데이터를 활용한 Feature Engineering, Data Manipuation, Visualizaiton 도전
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
### Feature Engineering, Data Manipuation, Visualizaiton이 필요한 이유
- 데이터셋을 원하는 부분만 추출하거나 데이터의 타입을 변화시키는 등 분석하기 편한 형태로 바꿀 수 있다.
- 새로운 열을 추가하거나 병합 혹은 삭제하여 풍부한 데이터셋을 만들 수 있다.
- Visualization을 통해 분석 결과를 한 눈에 이해하기 쉽게 보여줄 수 있다.
### 금융 데이터 소개
`Kospi 200 ETF` `골드 ETF` `신풍제약 주식 데이터` 를 활용했다.
**ETF란?**
Exchange Traded Fund의 약자로, 특정 주가지수를 주식처럼 거래가 가능하며, 특정 주가지수의 움직임에 따라 수익률이 결정되는 금융 상품
예를 들어, Kospi200 지수가 3% 올랐다고 가정하면, Kospi200 지수 자체를 주식처럼 거래할 수 없기 때문에 Kospi200 지수처럼 움직이는 상품을 거래할 수 있도록 만들어 놓은 것이 Kospi200 ETF이다.
### 목적
일반적으로, 코로나와 같은 경제 위기 상황에서 금과 같은 안전 자산에 대한 선호가 두드러진다고 알려져있다.
실제로, 안전 자산인 금이 우리나라 경제를 대표하는 kospi200 지수에 비해 어느정도 추이를 보이는지 알아보고자 한다.
추가적으로, 코로나 상황에서 두드러지는 의약품 주식 가격은 어떻게 변하는지도 함께 알아보고자 한다.
### 적용 과정
Kospi200 ETF를 불러와 확인한 결과, header가 잘 정리되지 않은 것을 확인했다.
```py
# kospi200 데이터 셋 불러오기
import pandas as pd
# 로컬 머신에서 데이터 셋 불러오기
from google.colab import files
uploaded = files.upload()
# 데이터 확인
kospi200 = pd.read_csv("kodex200.csv")
kospi200.head()
```
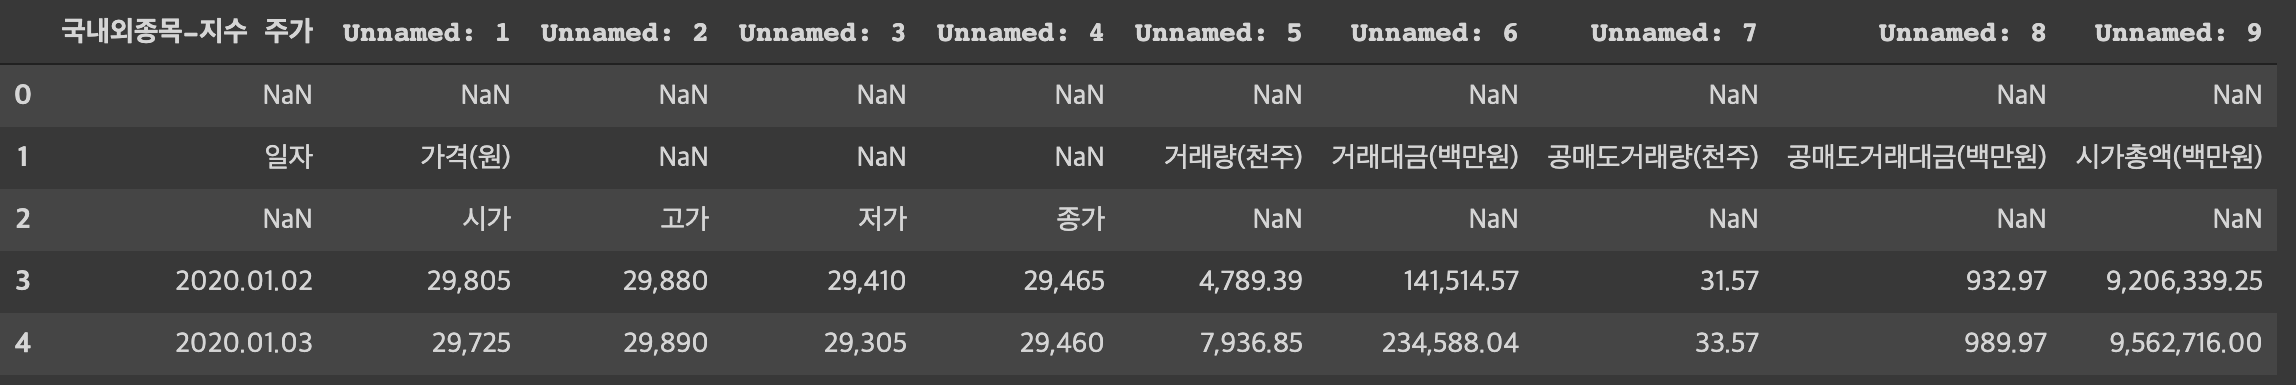
그래서 header를 잘 정리하고, 칼럼 명을 설정한 후 필요없는 column들을 삭제했다.
**간단하게 column들을 소개하자면,**
`date` 는 주식시장이 열렸던 날짜로, 주말이나 공휴일에는 개장을 하지 않기 때문에 영업일들로 구성되어 있다.
`open` 은 시가로, 주식시장이 개장했을 시점의 가격을 말한다.
`high` 는 고가로, 하루 동안의 가격 추이 중 가장 높았던 가격을 말한다.
`low` 는 저가로, 하루 동안의 가격 추이 중 가장 낮았던 가격을 말한다.
`close` 는 종가로, 주식시장이 마감했을 시점의 가격을 말한다.
`vol` 은 거래량 (volume)으로, 하루 동안 체결된 주식의 수를 말한다.
```py
# 데이터프레임 header 정리
kospi200 = pd.read_csv("kodex200.csv", skiprows = 4, engine = "python")
kospi200.head()
# 칼럼 명 설정
kospi200.columns = ["date", "open", "high", "low", "close", "vol", "", "", "", ""]
# 필요없는 columns 삭제
kospi200 = kospi200.drop([""], axis = 1)
kospi200.head()
```
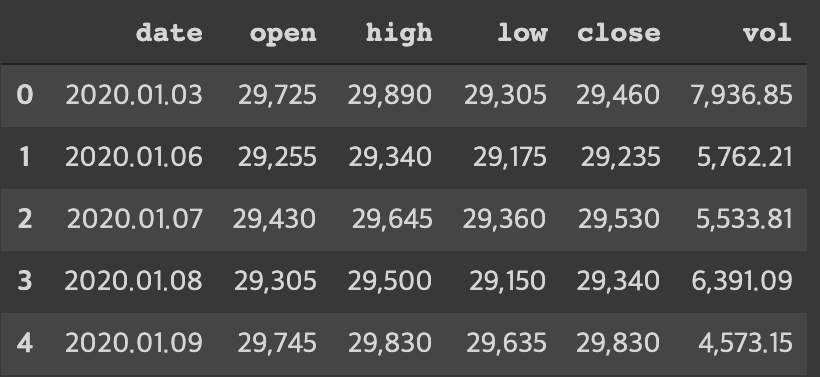
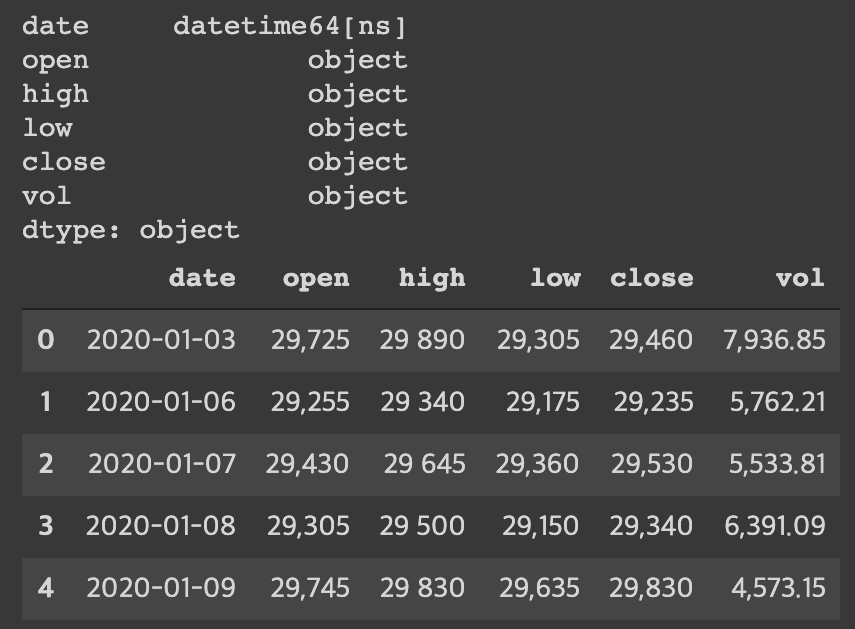
또, 데이터프레임의 column 별 형태를 확인해보니, `date` column이 object 형태인 것을 확인했고, 이를 `datetime`을 이용하여 날짜 형태로 변환했다.
```py
# datetime 형태로 날짜 변환
kospi200["date"] = pd.to_datetime(kospi200["date"], infer_datetime_format = True)
print(kospi200.dtypes)
kospi200.head()
```
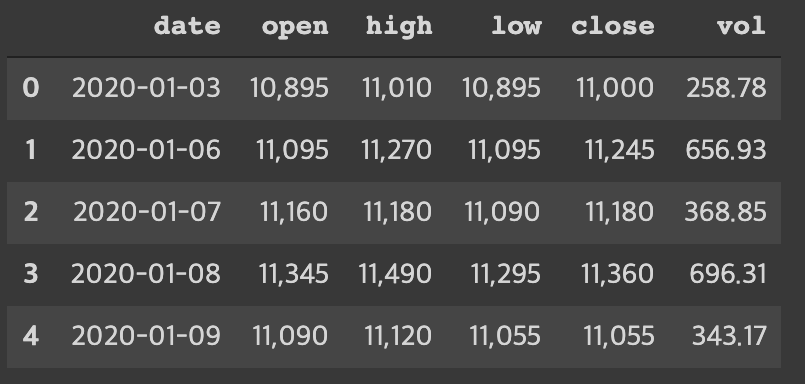
이려한 일련의 **Feature Engineering** 과정을 여러 번 반복하는 것은 굉장히 수고롭기 때문에 적용만 하면 이 과정을 한 번에 해줄 수 있는 함수를 작성하고, `골드 ETF` `신풍제약` 데이터도 불러와 적용했다.
```py
# 골드 ETF 데이터 불러오기
uploaded = files.upload()
gold = pd.read_csv("kodexGold.csv", skiprows = 4, engine = "python")
gold.head()
# 신풍제약 데이터 불러오기
uploaded = files.upload()
shinpoong = pd.read_csv("shinpoong.csv", skiprows = 4, engine = "python")
# 칼럼 명 설정과 필요없는 columns 삭제, datetime형태로 변환을 해주는 함수
def data_manip(data):
data.columns = ["date", "open", "high", "low", "close", "vol", "a", "b", "c", "d"]
data = data.drop(["a", "b", "c", "d"], axis = 1)
data["date"] = pd.to_datetime(data["date"], infer_datetime_format = True)
return data
gold = data_manip(gold)
shinpoong = data_manip(shinpoong)
```
**골드 ETF**
**신풍제약**
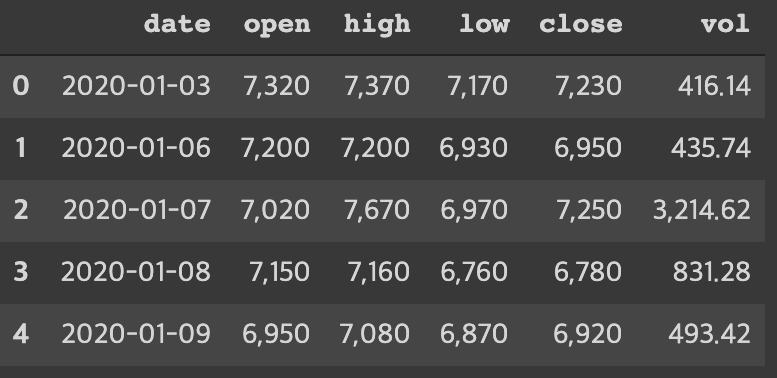
어느 정도 데이터 정리를 마무리 한 후, 각 종목의 가격 데이터를 날짜 별로 한 눈에 비교하기 위해 **inner join**을 하고자 한다. 먼저, inner join 후 혼란을 방지하고자 칼럼 명을 다음과 같이 변경했다. 이러한 과정을 거친 후, `date` 칼럼을 기준으로 inner join을 했다.
```py
# inner join을 위한 칼럼 명 변경
kospi200.rename(columns = {"close" : "close_kospi200"}, inplace = True) # inplace = True 는 원본 데이터를 변경하고 싶을 때
gold.rename(columns = {"close" : "close_gold"}, inplace = True)
shinpoong.rename(columns = {"close" : "close_shinpoong"}, inplace = True)
kospi200.head()
# date 칼럼을 기준으로 inner join
kospi200_data = kospi200[["date", "close_kospi200"]]
gold_data = gold[["date", "close_gold"]]
shinpoong_data = shinpoong[["date", "close_shinpoong"]]
every_data = pd.merge(kospi200_data, gold_data, on = "date", how = "inner")
every_data = pd.merge(every_data, shinpoong_data, on = "date", how = "inner")
every_data.head()
```
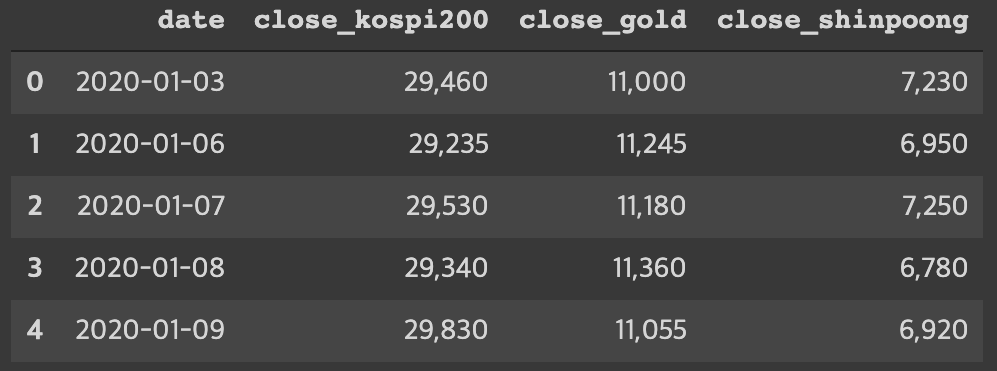
데이터프레임을 병합한 후, 그래프를 그리는 과정에서 곤란한 상황을 미리 방지하기 위해 `date` 칼럼을 제외한 모든 칼럼의 타입을 정수형으로 변경하고자 한다. `,`가 있으면 제대로 변환이 되지 않기 때문에 사전에 제거하는 과정을 거쳤다.
```py
import numpy as np
# , 삭제
every_data["close_kospi200"] = every_data["close_kospi200"].str.replace(",", "")
every_data["close_gold"] = every_data["close_gold"].str.replace(",", "")
every_data["close_shinpoong"] = every_data["close_shinpoong"].str.replace(",", "")
# date 칼럼을 제외한 모든 칼럼 정수형으로 변경
every_data["close_kospi200"] = every_data["close_kospi200"].astype(np.int64)
every_data["close_gold"] = every_data["close_gold"].astype(np.int64)
every_data["close_shinpoong"] = every_data["close_shinpoong"].astype(np.int64)
print(every_data.dtypes)
every_data.head()
```
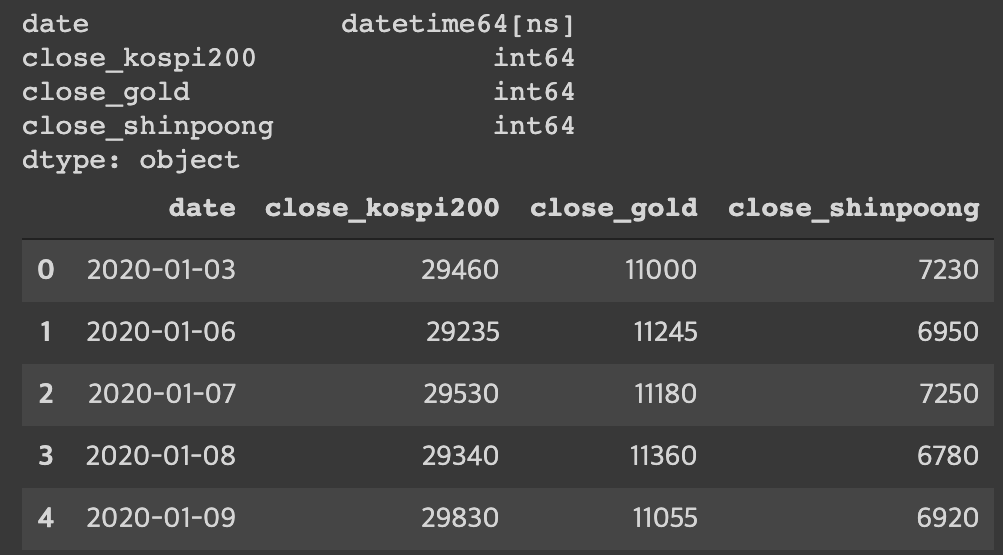
여기까지 분석하고자 하는 데이터프레임 정리가 완성됐다. 그래프를 그려 시각화 하기 전에 `seaborn`의 버전을 업데이트 해야 한다. 버전이 `0.11.0`인 경우에 지원하는 그래프들이 있기 때문에 이를 활용하기 위해서는 업데이트 과정이 필수적이다. 업데이트를 한 후, 런타임을 재시작해야 업데이트 된 버전이 적용되기 때문에 이를 꼭 숙지해야 한다.
```py
# seaborn 버전 업데이트
!pip install seaborn==0.11.0
# seaborn 버전 확인
sns.__version__
```
본격적으로 `seaborn`을 이용하여 데이터 시각화를 하고자 한다. 2가지 그래프를 그릴 건데, 첫 번째는 kospi200 ETF와 골드 ETF의 2020년 이후 가격 추이를 비교해보고자 한다. 두 번째는 kospi200 ETF와 신풍제약의 2020년 이후 가격 추이를 비교해보고자 한다.
```py
# seaborn을 활용한 데이터 시각화 (KOSPI200 vs GOLD)
import seaborn as sns
import matplotlib.pyplot as plt
sns.set_theme(style = "darkgrid")
fig, ax = plt.subplots() # 보조 축 설정
ax2 = ax.twinx()
sns.lineplot(data = every_data, x = "date", y = "close_kospi200", ax = ax, color = "r", linewidth = 3, label = "kospi")
sns.lineplot(data = every_data, x = "date", y = "close_gold", ax = ax2, color = "g", linewidth = 3, label = "gold")
plt.legend(loc=4)
plt.title("KOSPI200 vs GOLD", fontweight = "bold", loc = "center", size = 20) # 제목 설정
ax.set_xticks(ax.get_xticks()[::2]) # x축 간격 설정
```
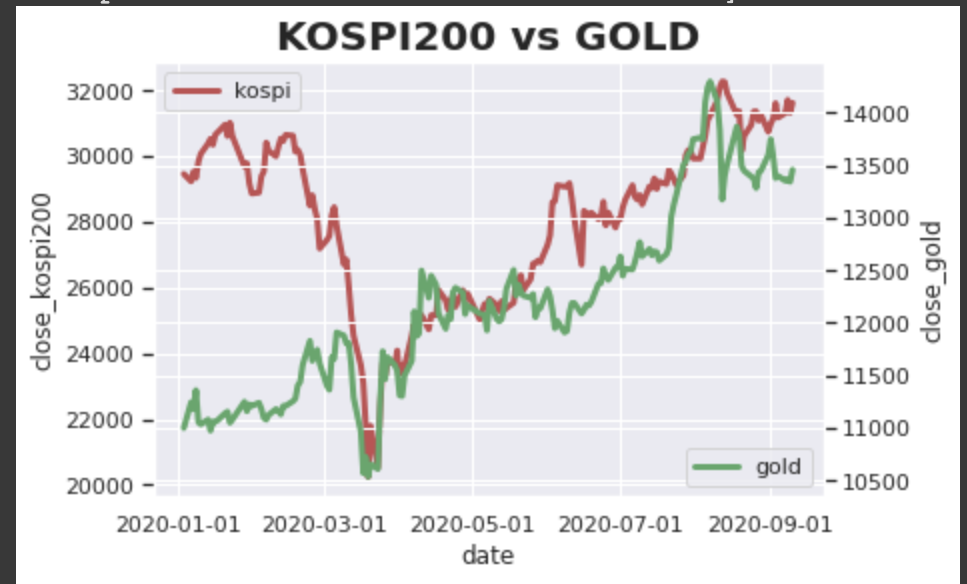
위의 **KOSPI200 vs GOLD 그래프**를 보면, 세 가지 시점으로 나누어 분석해 볼 수 있다.
1. **~2020-03**
코로나 바이러스가 대유행이 되어 급격하게 확진자가 늘어나는 시점 2020년 3월 초까지는 일반적으로 알려진 선호에 따라, 위험자산으로 분류할 수 있는 kospi200 ETF는 하락하는 반면, 안전자산으로 분류할 수 있는 골드 ETF는 점차적으로 상승하는 모습을 볼 수 있다.
2. **~2020-05**
그러나 코로나 바이러스로 인한 사태에 대해 팬데믹이 선언되면서 kospi200 ETF는 급격하게 하락했고, 마찬가지로 골드 ETF 역시 함께 급격하게 하락하는 모습을 보였다. 또, 최저점에 도달한 후 5월 중순 쯤까지 회복세를 보이는 시기에도 위험자산인 kospi200 ETF와 골드 ETF는 함께 움직이는 모습을 볼 수 있다. 이러한 현상이 나타난 이유를 2007-2008년 서브프라임모기지로 인한 경제 위기에 비추어 본다면, 극심한 경제 위기의 상황에서는 대부분의 자산의 상관관계가 1에 가까워져 전반적인 자산의 급락을 연출하기 때문에 이 시기에도 그러한 영향이 아닐까 하는 판단을 해볼 수 있다.
3. **2020-05~2020-07** / **2020-08-01~**
코로나 사태가 완벽하게 해소되지는 않았지만, 정부와 중앙은행의 유동성 공급 정책과 함께 회복의 기대감, 확진자 수와 완치자 수의 격차 완화 등으로 이 시기에 경제가 매우 빠르게 회복되는 모습을 보였다. 이 시기에는 3월 이전 시점보다 두드러지지는 않지만, kospi200 ETF가 상승하면서 반대로 골드 ETF가 하락하며 두 자산의 격차가 벌어지는 모습을 확인해볼 수 있다.
```py
# seaborn을 활용한 데이터 시각화 (KOSPI200 vs 신풍제약)
sns.set_theme(style = "darkgrid")
fig, ax = plt.subplots() # 보조 축 설정
ax2 = ax.twinx()
sns.lineplot(data = every_data, x = "date", y = "close_kospi200", ax = ax, color = "r", linewidth = 3, label = "kospi")
sns.lineplot(data = every_data, x = "date", y = "close_shinpoong", ax = ax2, color = "m", linewidth = 3, label = "shinpoong")
plt.legend(loc=4)
plt.title("KOSPI200 vs shinpoong", fontweight = "bold", loc = "center", size = 20) # 제목 설정
ax.set_xticks(ax.get_xticks()[::2]) # x축 간격 설정
```
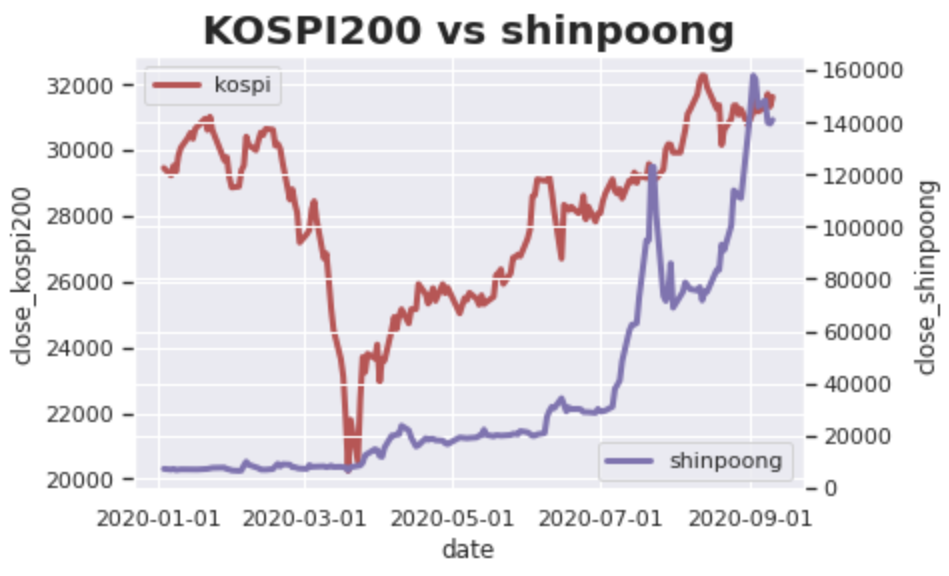
다음으로, **KOSPI200 vs 신풍제약 그래프**를 살펴보자.
1. 전반적인 추이를 살펴 보았을 때, kospi200 ETF가 급락과 회복의 흐름을 보이는 반면, 신풍제약은 전반적인 우상향의 추세를 보이고 있다. 코로나 바이러스가 경제 전반에 악영향을 미치는 반면, 치료제 개발에 대한 기대감으로 꾸준히 상승하는 모습을 보였고, 이를 통해 팬데믹의 상황에서 의약품 관련 종목 중 하나인 신풍제약은 경제 흐름의 영향을 덜 받는다는 것을 알 수 있다.
2. 7월 중순에서 8월까지 한 번 주가가 출렁인 모습을 보였다. 전문가들에 따르면, 밸류에이션 대비 주가가 과도하게 고평가 되었다는 판단으로 매도세가 이어지는 것이 원인이라고 할 수 있다. 이 역시, 경제 흐름보다는 개발에 대한 성공과 실패의 기대감의 영향이 훨씬 크다는 것을 알 수 있다.
### 결론 및 정리
**KOSPI200 vs GOLD 결론**
- 전반적으로 위험자산과 안전자산의 추이가 음의 상관관계를 보이는 것을 확인할 수 있다.
- 이러한 음의 상관관계는 경제가 하락 추세일 때가 상승 추세일 때보다 두드러진다.
- 극심한 경제 위기에 경우, 오히려 위험 자산과 안전자산이 함께 움직이는 모습을 보인다.
**KOSPI200 vs 신풍제약 결론**
- 팬데믹의 상황에서 신풍제약과 같은 의약품 관련 종목은 신약 개발 기대감으로 급격한 상승을 보인다.
- 타 산업들과는 다르게, 경제 흐름의 영향을 크게 받지 않는다.
**정리**
- 세부적인 주가 추이에 대한 이슈를 하나하나 파악한 것이 아니라 데이터의 전반적인 흐름 비교를 통한 분석이기 때문에 한계가 있을 수 있다.
- 시각화를 최대한 원하는 방향으로 해보았지만, 생각했던 것을 완벽하게 구현하기에는 아직 많이 부족하다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.