codestates / codestates/ds-blog
[조보현][beginner’s curiosity] Data Preprocess & EDA 시작하기 전 기본사항
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
~하하.. 처음 시험보고 정말 뭐가 뭔지 바로 정리를 안해서 어떤 명령어가 필요한지 찾는데 시간이 걸리는 구나 싶어서 정리합니다!~
## 해당 자료는 지속적으로 업데이트 되는 이론 요약본입니다.
### Data Preprocess & EDA **시작하기 전 기본사항**이라니?
우리는 Data Preprocess 진행하기위해 python, pandas라는 프로그램을 사용하게 되었다.
처음 아무런 사전 지식없이 데이터 처리를 진행하다보면, 이게 왜 필요한거지? 지금 내가 한 게 무슨의미이고 어떤 원리로 진행하는건지 이해가 되지 않게 된다.
그렇기 때문에, 나는 기본적인 내용에대해 정리를 해두려 한다.
``지금 이 글을 보고 있는 사람은 사전 지식없이 부랴부랴 데이터 처리를 먼저 진행 하게 된 분들을 대상으로 한다.``
### 오류발생(google + 아멘)
```py
# notebook상에서 매뉴얼을 보는 방법(help)
help(pd.read_csv)
```
## 데이터셋을 불러오기
>로컬 파일로 부터 데이터셋 불러오기 (CSV)
```py
# 방법 1: 구글 코랩 파일 업로드 패키지
from google.colab import files
uploaded = files.upload()
# 방법 2: GUI (Graphical User Interface) 사용
df = pd.read.csv('test.data') # after upload
print(df.shape)
```
>URL로 부터 데이터셋 불러오기 (CSV)
```py
변수값_URL = 'https://archive.test/ml/.test.data'
or
!curl https://archive.test/ml/.test.data
```
```py
!wget https://test.test.com/test.csv.zip # 압축파일 업로드
!unzip test.csv.zip # 압축파일 풀기
!head test.csv # 파일 확인
```
> 직접 입력
```py
#추가적으로 만약 파일에손상있으면 헤더를 채워야함
column_headers = ['A', 'B', 'C']
df = pd.read_csv(변수값_URL, names = column_headers)
# df = pd.read_csv(변수값_URL, header = None)
```
## 데이터셋 검토하기
```py
# 변수선언
import pandas as pd
df = pd.read_csv(test_url)
# pip3 install pandas
df.head()
```
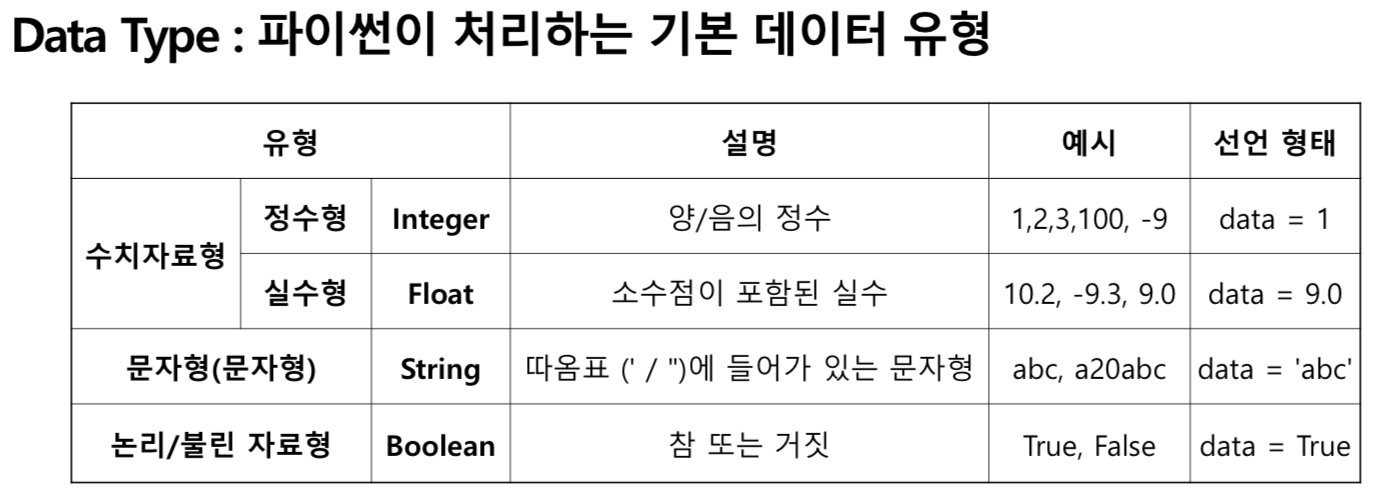
### 변수(Variable)란?
- 프로그래밍에서는 변수는 값을 저장하는 장소
- 변수는 메모리 주소를 가지고 있고 변수에 들어가는 값은 메모리 주소에 할당됨
- A = 8 의 의미는 “A는 8이다”가 아닌 **A라는 이름을 가진 메모리 주소에 8을 저장하라** 임
### 변수 이름 작명법
- 알파벳, 숫자, 언더스코어(_) 로 선언 가능
`ex) data = 0, _a12 = 2, _gg = 'afdf'`
- 변수명은 의미 있는 단어로 표기하는 것이 좋음
`ex) professor_name = 'Sungchul Choi'`
- 변수명은 대소문자가 구분됨
`ex) ABC와 Abc는 같지 않다`
- 특별한 의미가 있는 예약어는 쓰지 않는다.
`ex) for, if, else 등`
### 함수 (Function)란?
- 어떤 일을 수행하는 코드의 덩어리
- 반복적인 수행을 1회만 작성 후 호출
- 코드를 논리적인 단위로 분리
- 캡슐화: 인터페이스만 알면 타인의 코드 사용
```py
def 함수 이름 (parmaeter #1 ....):
수행문 #1(statements)
수행문 #2(statements)
return <반환값>
```
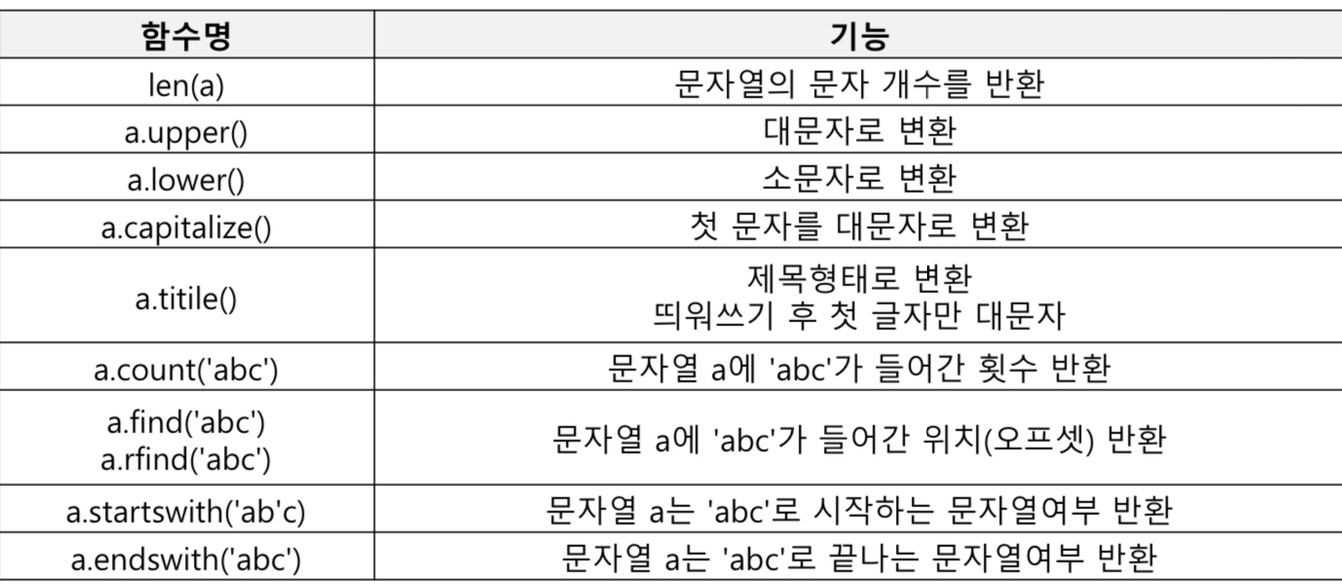
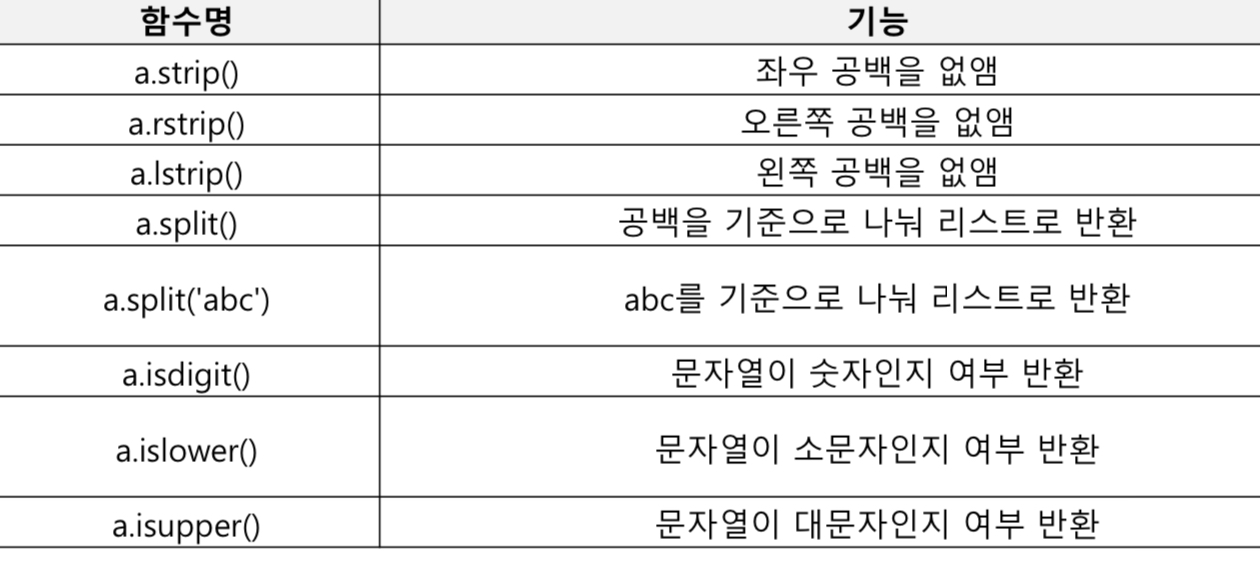
### 자주사용하는 함수 모음
### pandas를 사용한 기초 EDA (Exploratory Data Analysis)
접기/펼치기
- [df.shape](https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.shape.html)(열,행)
- [df.head()](https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.head.html)
-- DataFrame위에서 N(5)개 보여줌 → DataFrame.tail 마지막 N개 반영
- [df.dtypes](https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.dtypes.html)
-- DataFrame의 dtype을 반환 → pandas.Series 각 열의 데이터 유형
- [df.describe()](https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.describe.html)
---DataFrame.count :non-NA/null observations 수를 계산
--- DataFrame.max : 개체 값의 최대 값
--- DataFrame.min : 개체의 최소값
--- DataFrame.mean : 값의 평균.
--- DataFrame.std : 표준 편차
--- DataFrame.select_dtypes : Subset of a DataFrame including/excluding columns based on their dtype.
-- Numeric
-- Non-Numeric(categorical)
- [df['column'].value_counts()](https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.Series.value_counts.html)
--- 고유값의 개수 확인
```py
# 상위 20개의 employment titles 확인
df['test'].value_counts(dropna=False, ascending=False)[:20]
```
```py
# 얼마나 많은 종류의 항목이 있는지 확인
len(df['test'].value_counts())
```
- [df.isnull().sum()](https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.isnull.html)
--- 칼럼별 결측값 개수 구하기
```py
# NaN값 = 결측치
# 각 열 별로 null의 수를 세어 정렬합니다.
df.isnull().sum().sort_values()
```
- [df.fillna()](https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.fillna.html?highlight=fillna#pandas.DataFrame.fillna)
--- 결측값을 특정 값으로 채우기
- [df.dropna()](https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.dropna.html?highlight=dropna#pandas.DataFrame.dropna)
--- 누락된 데이터 제거
- [df.drop()](https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.drop.html?highlight=drop)
--- 특정 열,행 제거
```py
df = df.drop(['url','member_id','desc','id'], axis = 1)
```
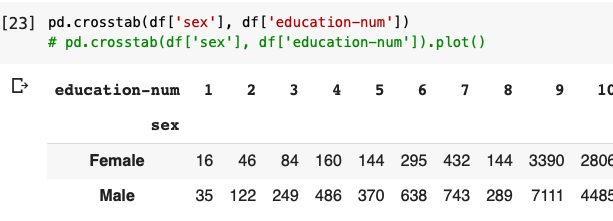
- [pd.crosstab()
](https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.crosstab.html?highlight=crosstab#pandas.crosstab)
--- 두 개 (또는 그 이상) 요인의 단순 교차 표를 계산
### Pandas를 사용한 기초 visualization (graph)
* Line Plot (기본표화면)
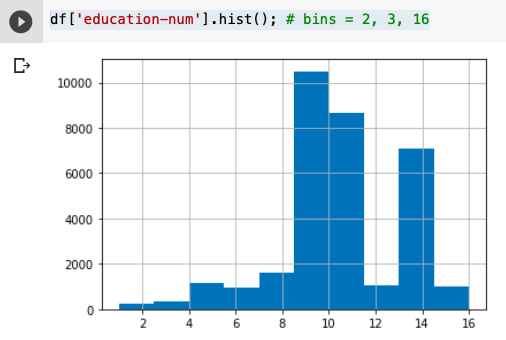
* Histogram
```py
df['education-num'].hist(); # bins = 2, 3, 16
```
* Scatter Plot
```py
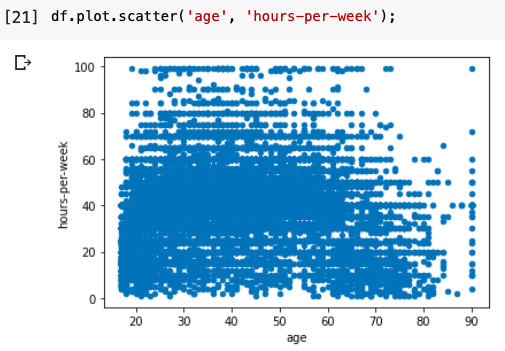
df.plot.scatter('age', 'hours-per-week');
```
* Density Plot
```py
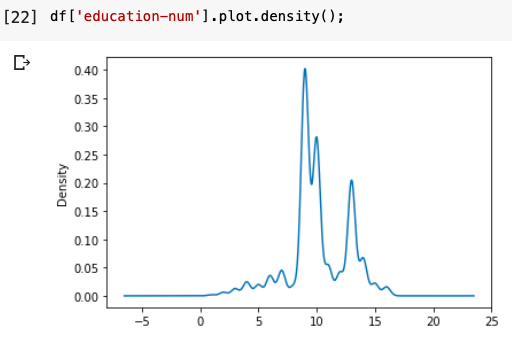
df['education-num'].plot.density();
```
* Crosstabs (Contigency table)
```py
pd.crosstab(df['sex'], df['education-num'])
# pd.crosstab(df['sex'], df['education-num']).plot()
```
### Pandas를 통해 날짜, 시간 데이터 다루기
```py
[col for col in df if col.endswith('_d')]
df['issue_d'] = pd.to_datetime(df['issue_d'], infer_datetime_format = True)
df.dtypes[:15]
df['issue_d'].iloc[0] # iloc 는 integer location을 의미합니다.
```
```py
df['issue_d'].dt.year # .dt datetime object
df['issue_d'].dt.month
df['issue_year'] = df['issue_d'].dt.year
df['issue_month'] = df['issue_d'].dt.month
```
```py
# 날짜의 차이를 구할 수 있음
df['days_from_ealiest_credit_to_issue'] = (df['issue_d'] - df['earliest_cr_line']).dt.days
```
### 알게된 다른 명령어들
접기/펼치기
```py
# **작은** 데이터 프레임을 생성
# 이는 각 column의 헤더 이름을 사용하여 할 수 있습니다.
small_df = df[['ABD','ABC','ABF','ABF']].copy()
```
```py
# [ ] 를 사용하여 새 'ABC' 열을 생성하세요.
small_df['ABC'] = small_df['ABD'] + small_df['ABC'] + small_df['ABF']
small_df['ABC'] = (small_df['ABD'] / small_df['ABC'])
```
```py
# skiprows = 첫번째 부분를 무시하고 column 진행
# skipfooter = 마지막 부분을 무시하고 진행
df = pd.read_csv('test.csv', skiprows = 1, skipfooter = 2, engine = 'python')
```
```py
# 공백없애고, %지 없애고, 무슨 타입인지 확인
type(df.strip().strip('%')) # =str
# 문자열을 실수형으로 "형변환" ("Cast")합니다.
type(float(df.strip().strip('%'))) # = float
```
```py
# 여러번 반복 할 수 있는 함수
# 입력된 문자열에 대해서 같은 작업을 하는 함수 작성
def int_rate_to_float(cell_contents):
return float(cell_contents.strip().strip('%'))
# 예시 데이터를 바탕으로 함수를 테스트
int_rate_to_float(int_rate)
# 데이터 타입을 확인하십시오
type(int_rate_to_float(int_rate))
```
```py
# 열의 모든 데이터에 함수를 적용
df['int_rate_float'] = df['int_rate'].apply(int_rate_to_float)
```
```py
# 예시 데이터 생성
examples = ['owner', 'Supervisor', 'Project Manager ', np.NaN]
# 이번 데이터 정리의 목적은 주어진 직함에 대해서 첫 글자를 대문자로 바꾸는 것입니다. (owner -> Owner)
# 함수 작성
def clean_title(title):
if isinstance(title, str):
return title.strip().title()
else:
return "Unknown"
for example in examples:
print(clean_title(example))
```
```py
# list 표현을 사용하여, list 내부의 아이템에 대해서 함수를 적용 할 수 있습니다.
[clean_title(example) for example in examples]
# 작동하는 함수를 생성했으니, 주어진 열에 대해서 적용 해보도록 합시다.
# 덮어쓰기에 주의하십시오.
df['emp_title'] = df['emp_title'].apply(clean_title)
```
### 찾아낸 python 공부하기 좋은 사이트
- 점프 투 파이썬 - https://wikidocs.net/book/1
- 코드카데미 - https://www.codecademy.com/
- 코드파이트 - https://codefights.com/
- 생활 코딩 - https://opentutorials.org/course/1750
- Cousera – python 검색
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.