codestates / codestates/ds-blog
[오예은] Tidy Data - 깔끔해서 좋다! 분석하기 좋은 데이터로 만드는 방법
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
[Medium에서 보기](https://medium.com/@dsdoris/tidy-data-in-data-analysis-adcd9677e588)
>수업시간에 Tidy data에 대해 배웠는데 내가 알고 있는 '데이터베이스 정규화' 라는 것과 비슷한 것 같아서 Tidy Data가 무엇인지 알아보게 되었다. 조사 중에 관련 Article을 찾아서 그 안에 있는 내용 일부로 Tidy data에 대한 소개를 갈음하고자 한다.
[ - Hadley Wickham (R Studio)](https://vita.had.co.nz/papers/tidy-data.pdf)
# Tidy Data
데이터 분석(데이터를 다루고 모델링하고 시각화하는 전 과정)을 쉽게 할 수 있도록 파악하기에 명확한 구조를 가지고 있는 데이터를 말한다. Tidy data는 데이터셋 구조의 표준화를 제공하므로 변수를 추출하기 쉽게 만들어준다.
데이터 분석의 80%가 데이터를 준비하고 정제하는 과정에 소요된다고 한다. 데이터 준비는 단순히 첫 단계에서 뿐만 아니라 새로운 문제가 발생하거나 새로운 데이터가 수집될 때 반복하게 되는 과정이다. (저자 또한 수집한 Dataset을 가지고 분석이 가능한 데이터로 만드는데 꽤 많은 어려움을 겪었다고 한다.) 이렇게 소모되는 과정을 줄여 분석에 최적화된 구조로 만드는 작업을 data tidyng이라고 한다.
# The principles of tidy data
관계형 데이터베이스와 Codd의 관계대수와 관련이 있지만 좀 더 통계 친화적(?)으로 만들었다고 한다. 그동안 컴퓨터 과학자들이 data cleaning과 관련된 수많은 연구들로 공헌했지만 통계학자들에게 데이터 구조화에 대한 충분한 도움을 주지 못했고 데이터 분석 툴과 연계성이 떨어지는 탓에 통계분석에 맞게 적용시킨 것이라 한다.
무엇보다 저자는 데이터의 구조와 의미가 명확하게 연결이 되어있어야 한다고 한다. 저자가 말하는 데이터 구조와 의미에 대해 살펴보자.
### data structure
- 모든 데이터셋은 rows와 columns으로 구성되어있다.
- data가 같아도 layout이 다를 수 있다. 우리는 데이터 테이블에 드러나지 않은 의미를 묘사할 수 있어야 한다.
### data semantics
- dataset은 숫자 또는 문자로 이루어진 values의 집합이다.
- value는 variable(변수/속성) 혹은 observation(관측값)에 해당된다.
### Tidy Data의 원칙
- Each variable forms a column.
- Each observation forms a row.
- Each type of observational unit forms a table.
이 원칙은 Codd의 제3 정규화 개념에서 비롯되었지만, 관계형 데이터베이스보다는 하나의 데이터 셋을 중점적으로 다루는 통계적 특성을 고려한 것이다.
# messy data set을 tidying하는 방법
데이터 분석을 위해 복잡한 데이터를 깔끔하게 만들기 위해서는 우선적으로 복잡한 데이터가 가지고 있는 문제점을 살펴보아야 한다.
### messy dataset의 일반적인 5가지 문제
- 컬럼 이름이 변수(속성)이름이 아니라 값이다.
- 여러개의 변수(속성)이 하나의 컬럼에 들어가있다.
- 변수(속성) 값이 컬럼과 로우에 모두 들어가있다.
- 여러 타입의 관측값 단위가 한 테이블에 들어가있다.
- 하나의 관측값 단위가 여러개 테이블에 나눠서 들어가있다.
위의 다섯가지 문제 모두 각 value의 의미에 맞게 구조화되지 않았을 때 생길 수 있는 문제다. 각 문제 상황에서 해당 dataset을 어떻게 tidy dataset으로 만드는지 예시를 알아보자.
### 변수(속성) 값이 컬럼과 로우에 모두 들어가 있을 때
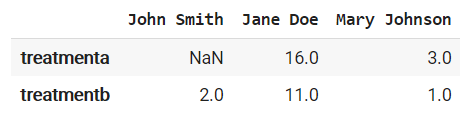
원본 데이터 (변경 전) - treatment의 값이 row, name의 값이 column
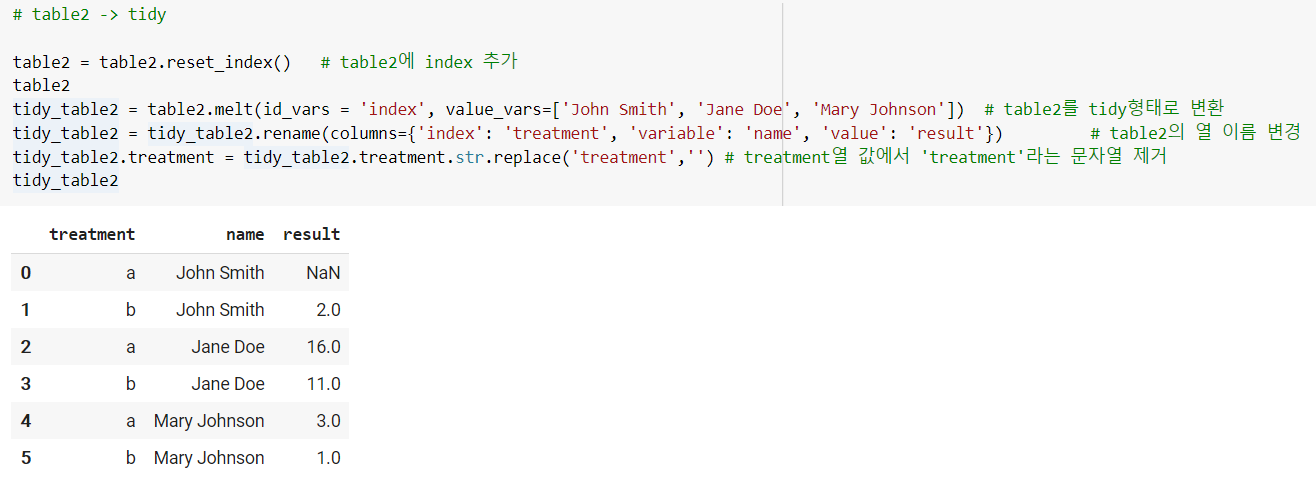
melt한 데이터(변경 후) - column 이름엔 변수 이름만, row엔 각 값만 있음
### 여러 타입의 관측값 단위가 한 테이블에 있을 때
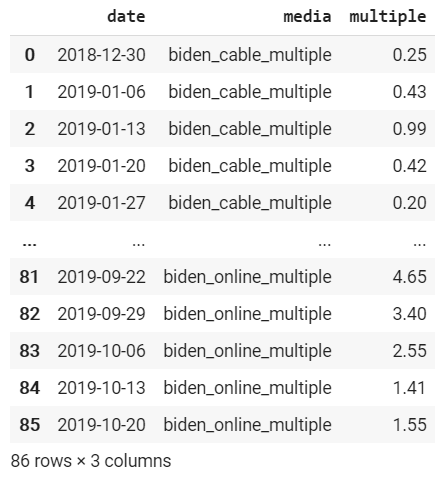
원본데이터(melted) - media column의 값이 속성값을 지니고 있다.
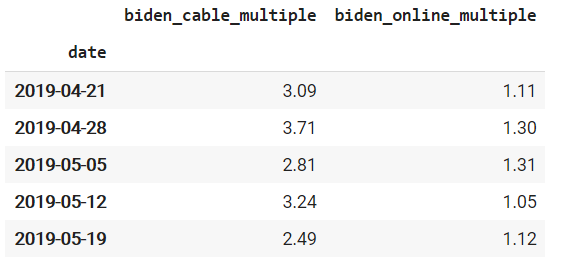
tidy data - 각 media별 값을 알 수 있다.
정리해보자면, Tidy data는 데이터의 구조를 다듬어서 데이터에 대해 보다 명확하게 파악할 수 있도록 만든 것이다.
그래서 데이터프레임의 열에는 '변수/속성' 이름만 들어가도록,
행에는 각 속성에 대한 측정값이 들어가도록 만든 dataset이라 할 수 있을 것이다.
그리고 Codd의 정규화 개념은 데이터베이스를 변경하는 과정에서의 일관성유지를 위한 것이라면,
Tidy data 개념은 데이터를 분석하기 쉽게 다듬는다는 목적면에서 차이가 있다고 할 수 있다.
다음 편에서는 위에서 말한 messy dataset의 일반적인 5가지 문제의 각 케이스별 해결 방법에 대해 Article에서 어떻게 언급했는지 알아보도록 한다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.