codestates / codestates/ds-blog
[방승진] Pandas "concat"과 "merge" 기초 이해
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
**concat vs merge**
1. 용어 정리
(1) **concat** : concatenate의 줄임말로, "결합시킨다"의 의미를 가진다.
(2) **merge** : "병합", "합병시키다"의 의미를 가진다.
2. 기초 예제
(1) **concat**
pd.concat([x, y])
```
( ) 안에 [ ]이 추가로 들어가며, [ ] 안에 결합시킬 series 또는 DataFrame(x와 y)을 넣는다.
```
```py
import pandas as pd
df1 = pd.DataFrame({'A': ['A0', 'A1', 'A2', 'A3'],
'B': ['B0', 'B1', 'B2', 'B3'],
'C': ['C0', 'C1', 'C2', 'C3'],
'D': ['D0', 'D1', 'D2', 'D3']},
index=[0, 1, 2, 3])
df2 = pd.DataFrame({'A': ['A4', 'A5', 'A6', 'A7'],
'B': ['B4', 'B5', 'B6', 'B7'],
'C': ['C4', 'C5', 'C6', 'C7'],
'D': ['D4', 'D5', 'D6', 'D7']},
index=[4, 5, 6, 7])
df3 = pd.DataFrame({'A': ['A8', 'A9', 'A10', 'A11'],
'B': ['B8', 'B9', 'B10', 'B11'],
'C': ['C8', 'C9', 'C10', 'C11'],
'D': ['D8', 'D9', 'D10', 'D11']},
index=[8, 9, 10, 11])
```
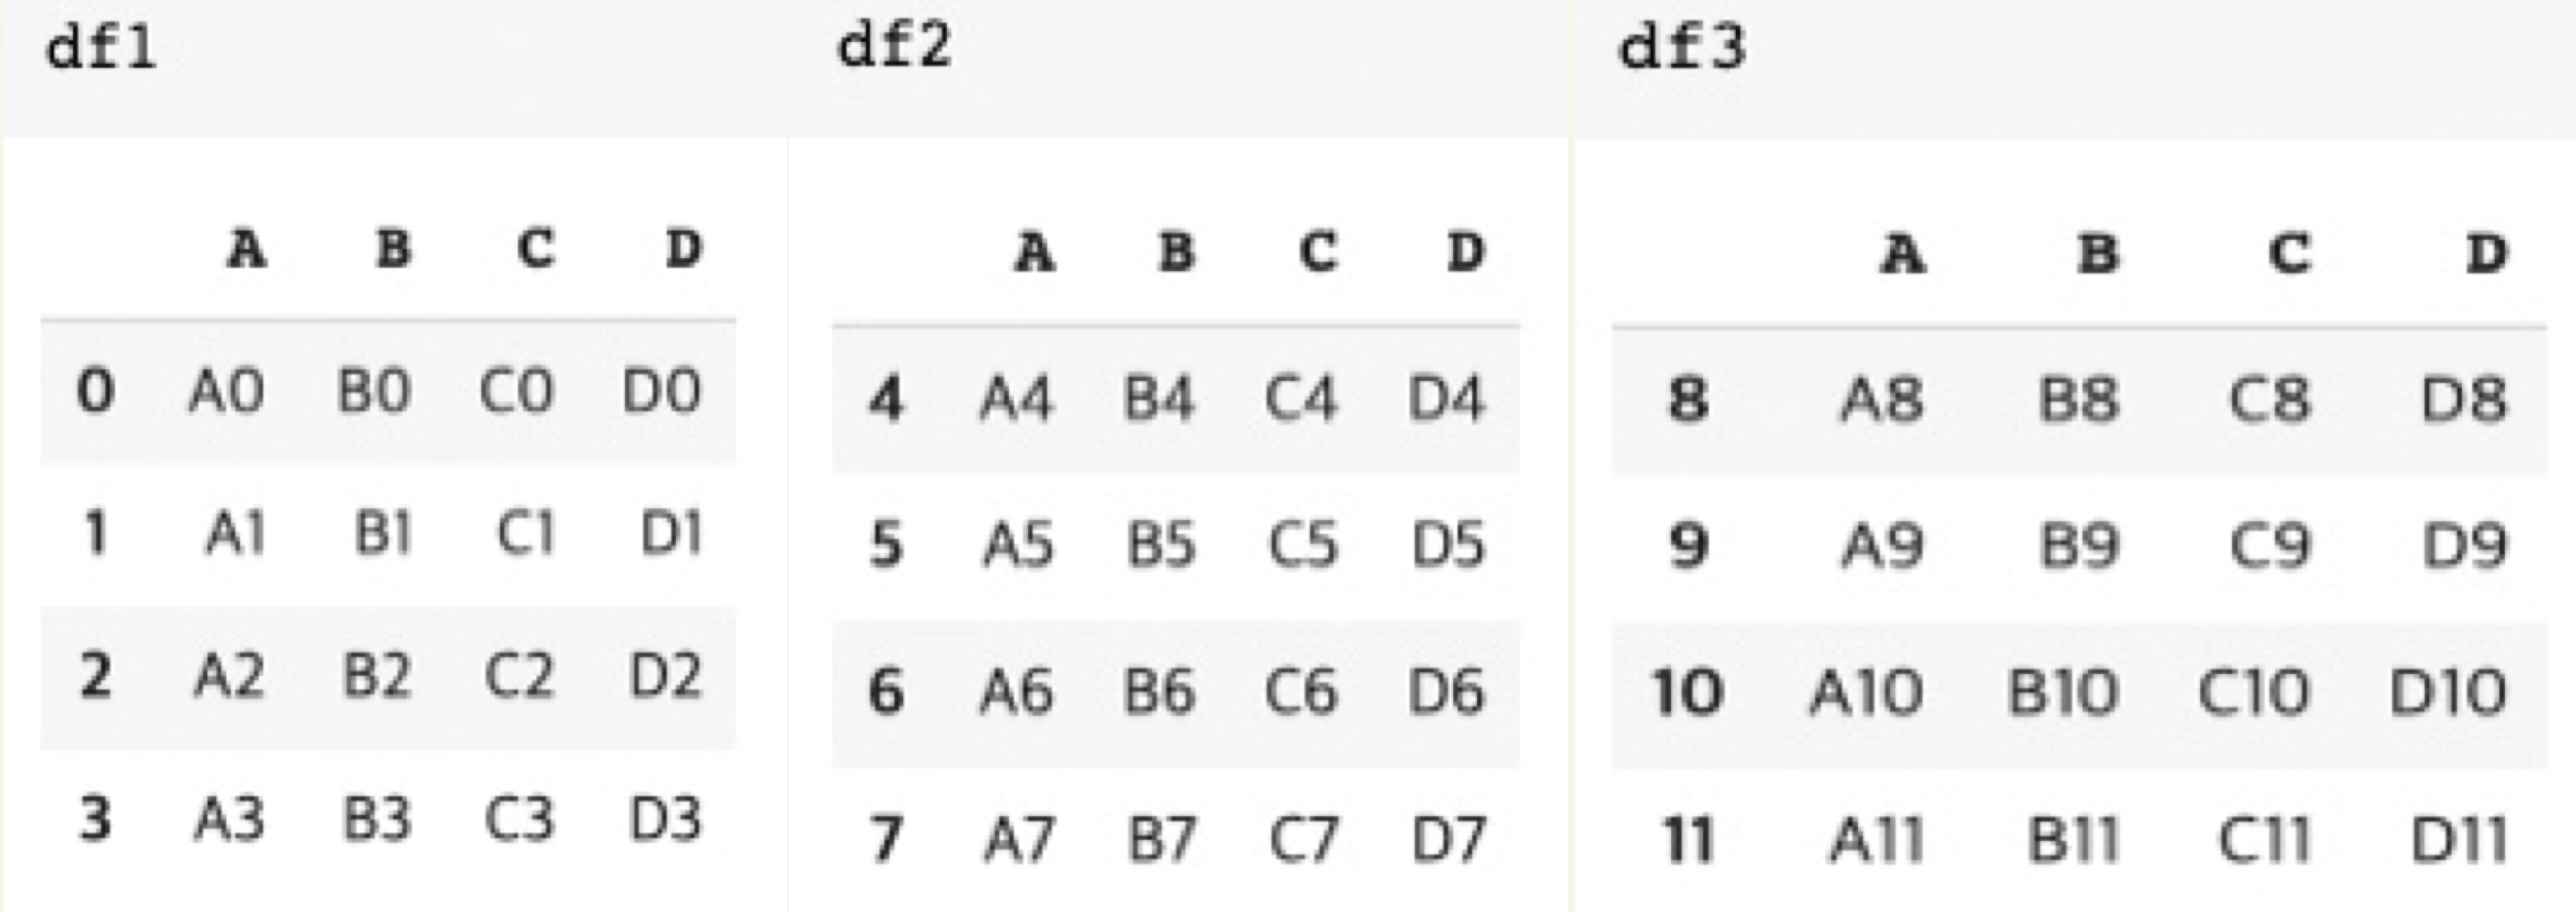
---
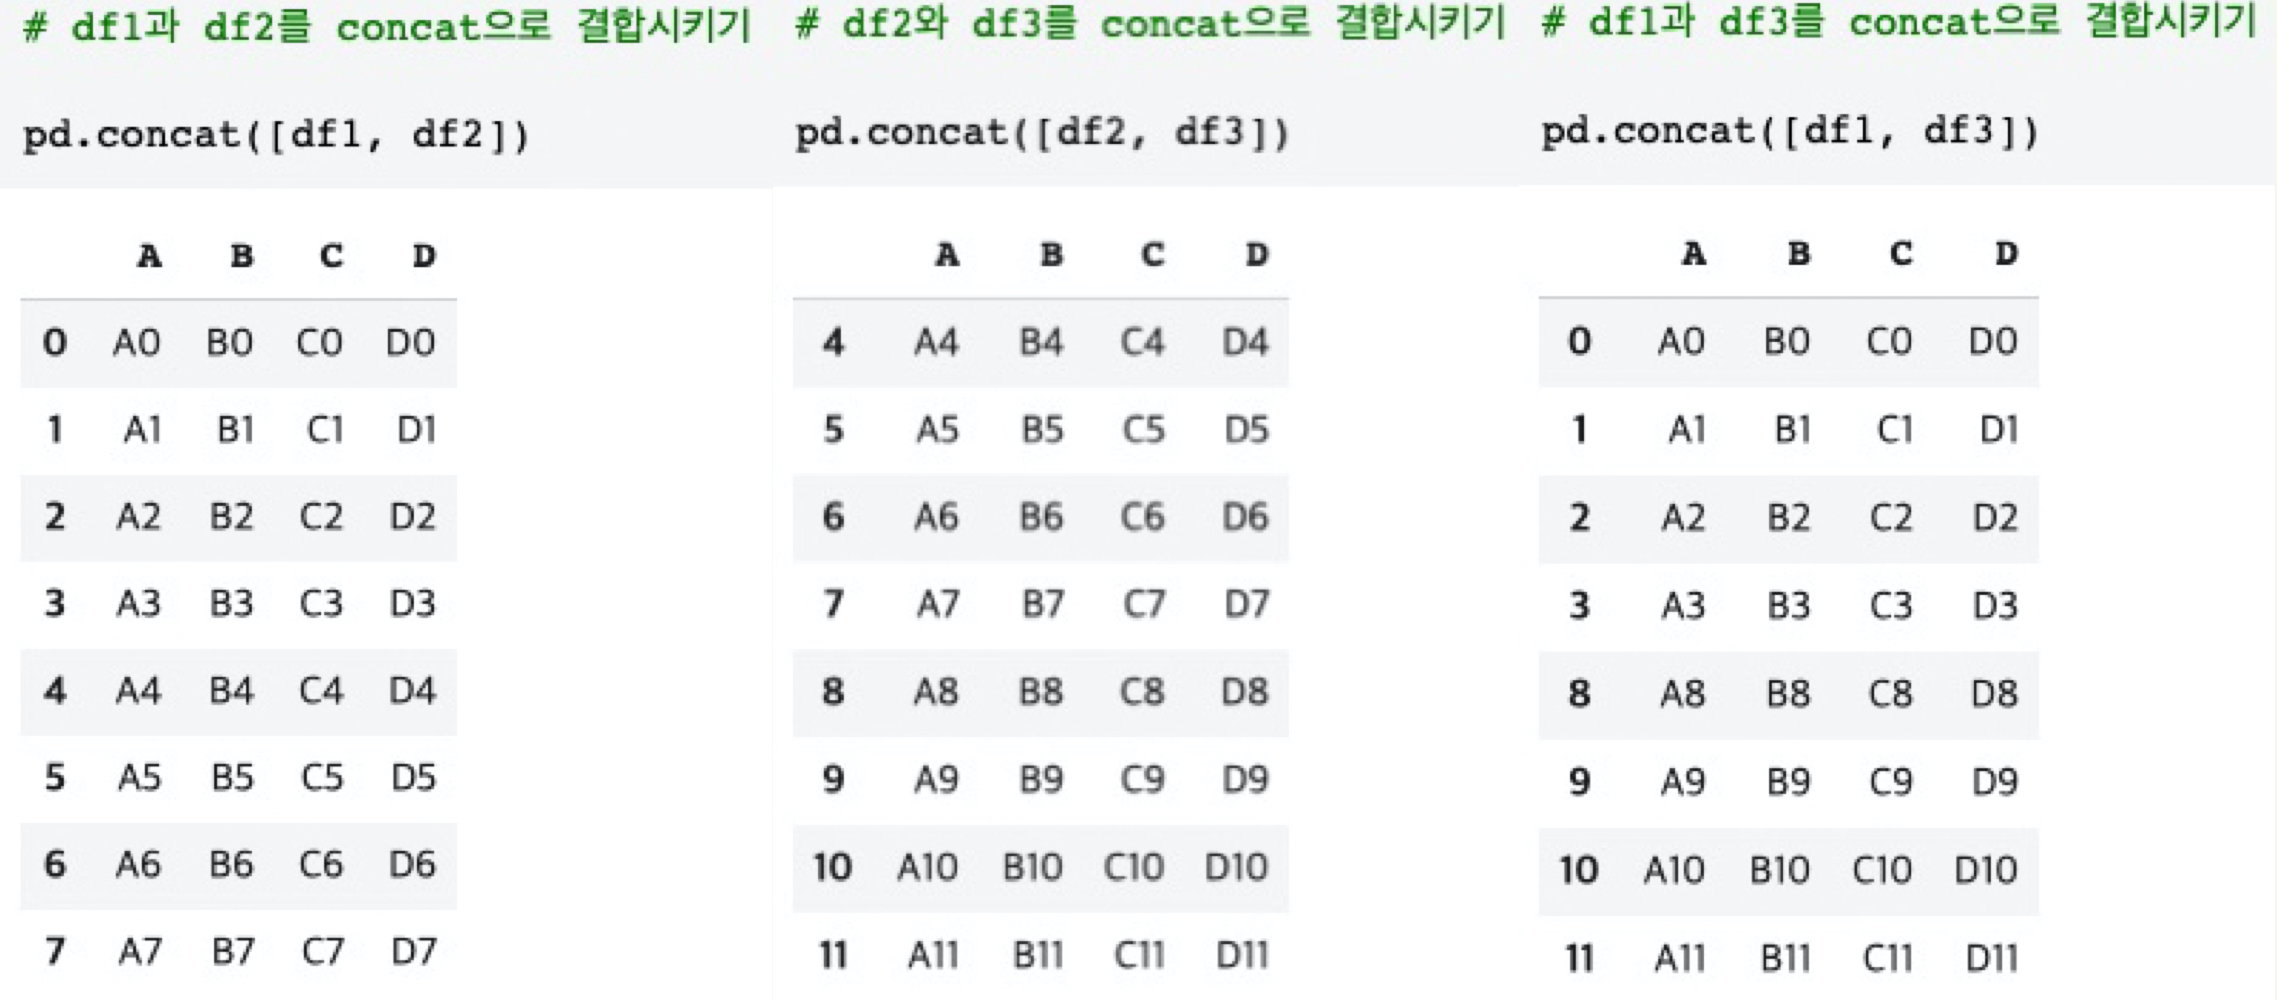
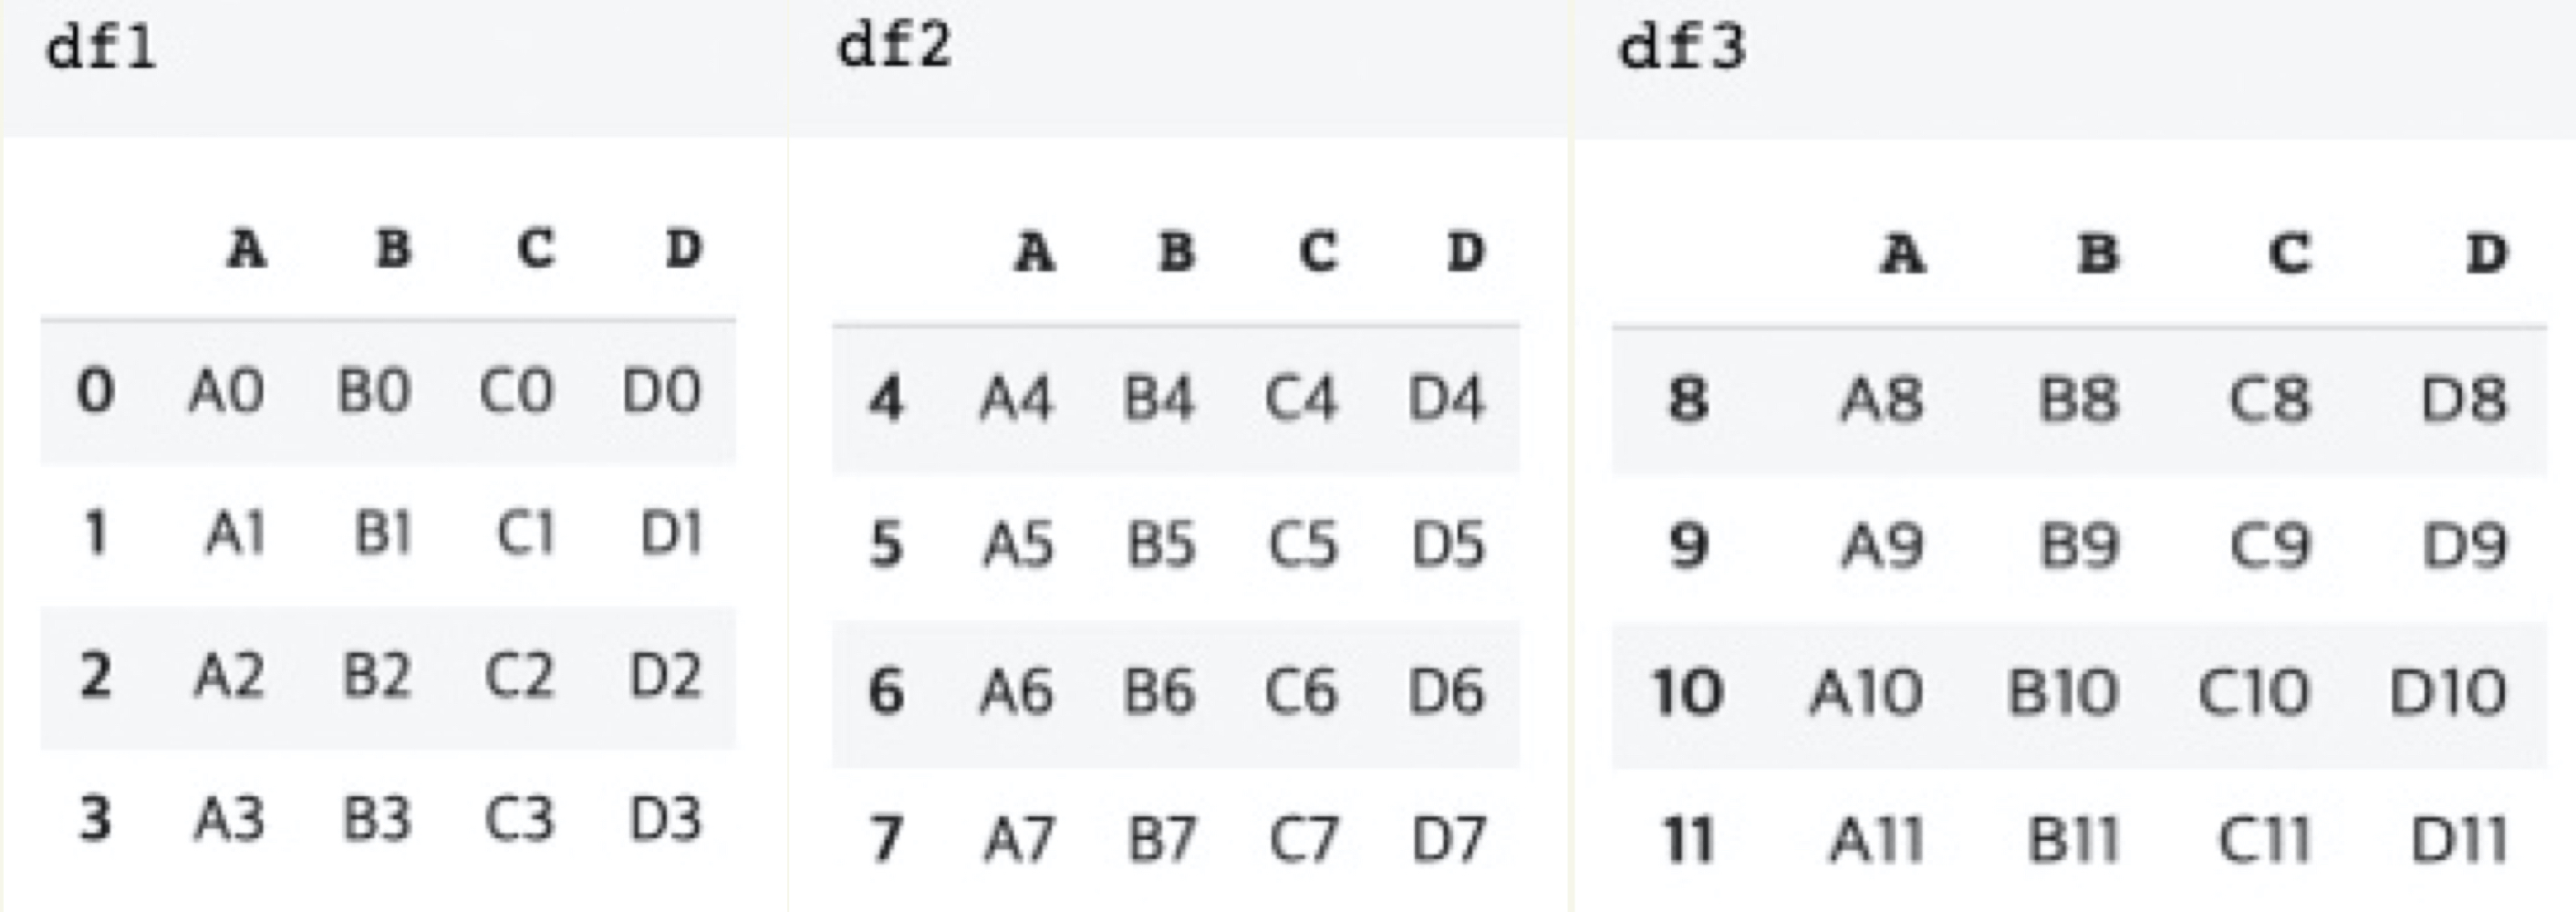
- df1 + df2 : df1의 밑면에 df2가 그대로 접붙여진 것이 보인다. (인덱스 : 0 ~ 3(df1) + 4 ~ 7(df2))
- df2 + df3 : df2의 밑면에 df3가 그대로 접붙여진 것이 보인다.(인덱스 : 4 ~ 7(df2) + 8 ~ 11(df3))
- df1 + df3 : df1의 밑면에 df3가 그대로 접붙여진 것이 보인다. (인덱스 : 0 ~ 3(df1) + 8 ~ 11(df3))
---
(2) **merge**
result = pd.merge(x, y, on='column/index name')
```
concat과는 달리,
( ) 안에 [ ]은 들어가지 않으며 merge하려는 dataframe(x, y)
또는 series를 제공하면서, 동시에 on='column/index name'이라는 기준선을 설정해야 한다.
```
```py
left = pd.DataFrame({'key': ['K0', 'K1', 'K2', 'K3'],
'A': ['A0', 'A1', 'A2', 'A3'],
'B': ['B0', 'B1', 'B2', 'B3']})
right = pd.DataFrame({'key': ['K0', 'K1', 'K2', 'K3'],
'C': ['C0', 'C1', 'C2', 'C3'],
'D': ['D0', 'D1', 'D2', 'D3']})
```
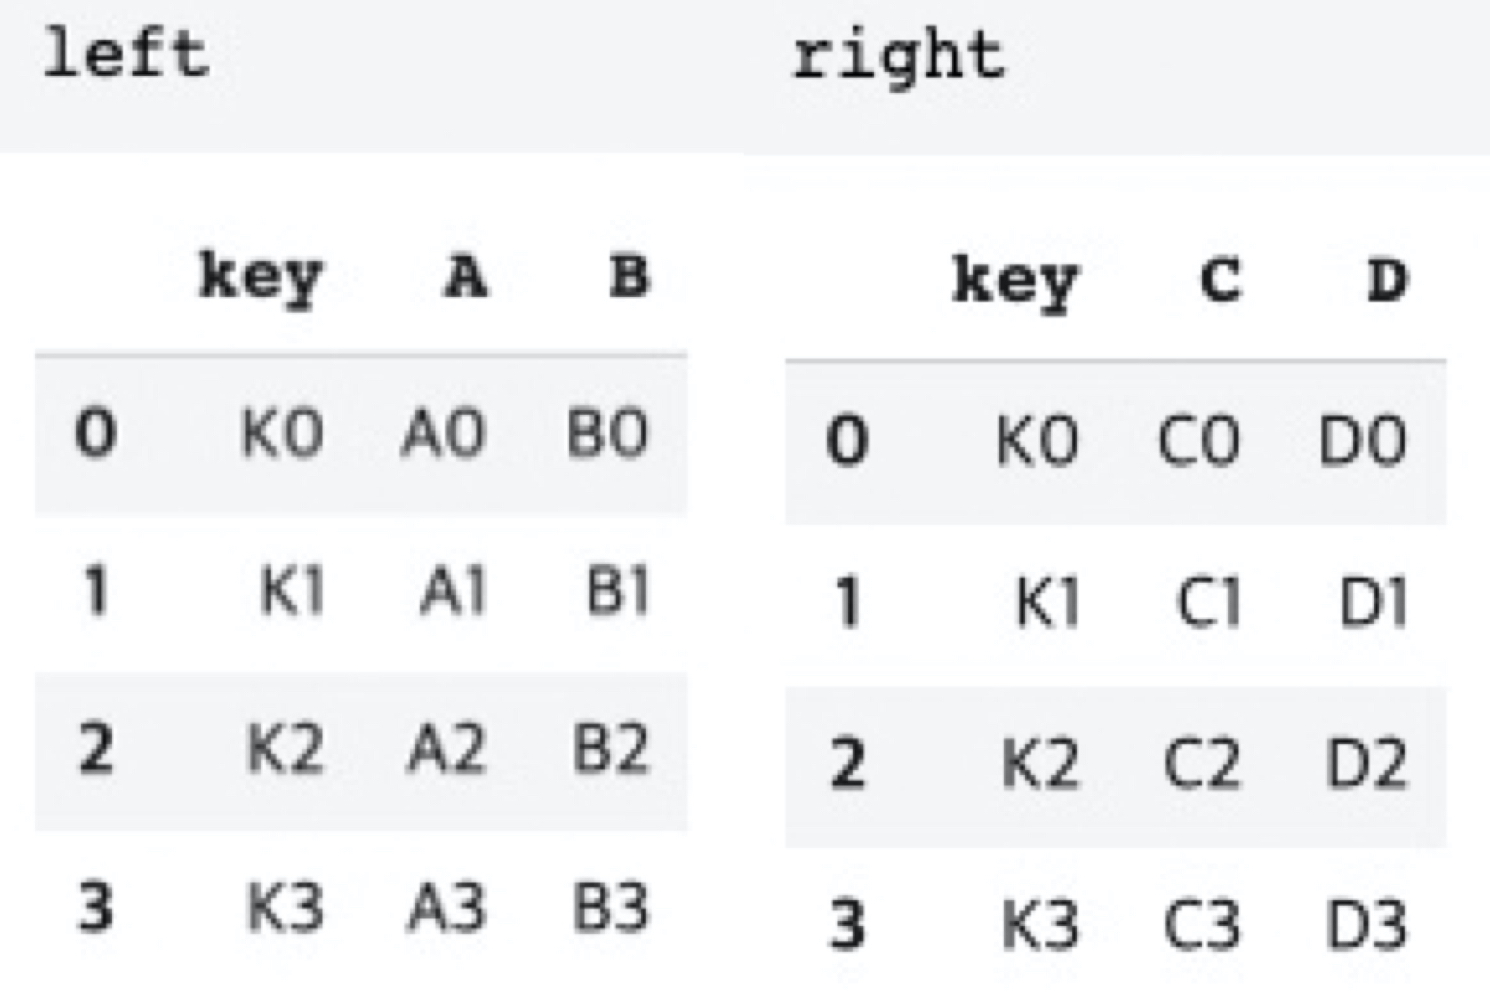
- left dataframe과 right dataframe은 'key' column을 동일한 값으로 가지고 있으며,
그 외에는 모두 다른 column 및 다른 value를 가지고 있다.
```py
# left dataframe과 right dataframe을 merge로 결합시키기
result_default = pd.merge(left, right, on='key')
result_default
```
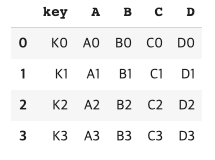
- dataframe을 merge로 결합하는 데 있어 예제에서는 key컬럼을 기준값으로 설정한다.
이 경우 위 on='key' 가 기준값을 설정하기 위해 작성된 값이다.
- left dataframe을 왼쪽에 두고, right dataframe을 오른쪽으로 접합시킨 결과가 나타난다.
3. 구성 요소 좀더 살펴보기
(1) concat
pd.concat(objs, axis=0, join='outer')
objs : 결합하고자 하는 series 또는 dataframe
axis : 연결할 축(기본값=0).
0이면 행, axis가 1이면 열을 의미한다.
join : 다른 축의 인덱스를 처리하는 방법.
단순 결합의 경우 'outer', 교차 결합의 경우 'inner'
**위 설명만으로 이해하기 매우 어렵다.**
**예시를 통해 이해해보자.**
---
```py
# concat 적용 1 : axis=0, join=outer (기본값)
pd.concat([df1, df2], axis=0, join='outer')
```
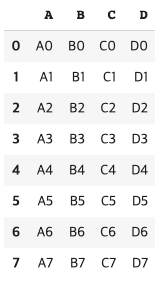
- 별다를 것 없는 기본값이다.
df1의 밑면에 df2를 붙였다고 이해하면 된다.
---
```py
# concat 적용 2 : axis=1, join=outer (column기준으로 결합, 공유불가능한 값 : NaN)
pd.concat([df1, df2], axis=1, join='outer')
```
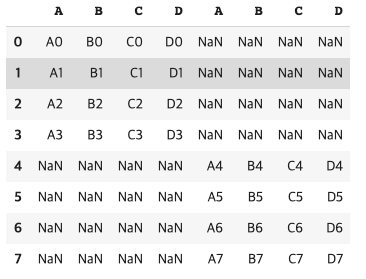
- column을 기준으로 결합시키기 위해 axis=1 을 적용한 경우이다.
df1을 그대로 둔 채, df2를 df1의 오른쪽면에 붙이려는 일환에서 나온 결과물인데,
중복되는 값이 없는 경우 NaN으로 표기된다.
---
```py
# concat 적용 3 : axis=1, join=inner
pd.concat([df1, df3], axis=1, join='inner')
```
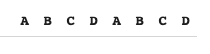
- df1과 df3의 모든 값이 중복되지 않기 때문에
결과물에서도 값이 나오지 않는다.
---
```py
# concat 적용 4 : axis=1, join=outer
pd.concat([df1, df3], axis=1, join='outer')
```
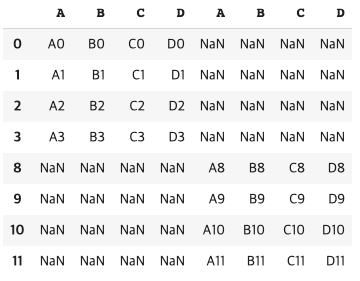
- df1과 df3의 값 중 중복되지 않는 값이 모두 결과물로 나온다.
---
(2) merge
```
pd.merge(left, right, how='inner', on='column/index name')
left : 결합하고자 하는 dataframe 1
right : 결합하고자 하는 dataframe 2
how : 'left','right','outer','inner' 중 하나의 값을 가진다(기본값='inner')
아래에서 좀더 자세히 설명할 것이다.
on : 결합하고자 하는 dataframe 1과 2에서 모두 가지고 있는 열 또는 인덱스 이름을 적는다.
```
```
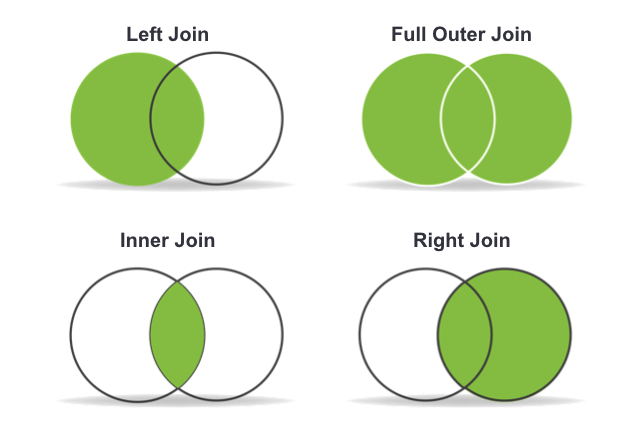
1) how : 'left'
왼쪽의 모든 요소(element)가 존재하며, 오른쪽의 요소 중 왼쪽의 요소와 공유가능할 때
추가적으로 요소가 결합되어 결과물에 반영된다.
2) how : 'right'
오른쪽의 모든 요소(element)가 존재하며, 왼쪽의 요소 중 오른쪽의 요소와 공유가능할 때
추가적으로 요소가 결합되어 결과물에 반영된다.
3) how : 'outer'
결합하고자 하는 데이터프레임의 모든 요소(element)를 결합시킨다.
각 요소가 공유가능할 때는 결합되나,
공유가 불가능한 경우에는 NaN값으로 결과물에 반영된다.
4) how : 'inner'
결합하고자 하는 dataframe의 모든 요소(element) 중,
공유가능한 요소만 결합되어 결과물에 반영된다.
```
```py
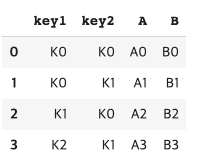
# left dataframe
left = pd.DataFrame({'key1': ['K0', 'K0', 'K1', 'K2'],
'key2': ['K0', 'K1', 'K0', 'K1'],
'A': ['A0', 'A1', 'A2', 'A3'],
'B': ['B0', 'B1', 'B2', 'B3']})
left
```
```py
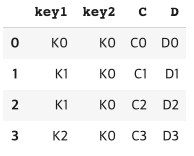
# right dataframe
right = pd.DataFrame({'key1': ['K0', 'K1', 'K1', 'K2'],
'key2': ['K0', 'K0', 'K0', 'K0'],
'C': ['C0', 'C1', 'C2', 'C3'],
'D': ['D0', 'D1', 'D2', 'D3']})
right
```
```py
# left dataframe 기준으로 merge
result_left = pd.merge(left, right, how='left', on=['key1', 'key2'])
result_left
```
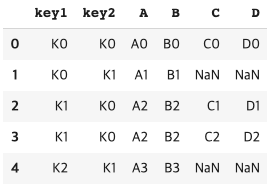
how='left'의 의미는 left에 해당하는 데이터프레임을 기준으로 한다는 의미이고,
여기에 on=['key1', 'key2']가 작성된 것을 바탕으로
left 데이터프레임에 있는 key1과 key2를 기준으로
중복되는 값이 있으면 결합시키고, 없으면 NaN 처리하는 것이다.
---
(K0, K0), (K1, K0) : 각 데이터프레임에 모두 존재함 -> 결합시킨다.
(K0, K1), (K2, K1) : left 데이터프레임에만 존재함 -> NaN 처리
---
```py
# right dataframe 기준으로 merge
result_right = pd.merge(left, right, how='right', on=['key1', 'key2'])
result_right
```
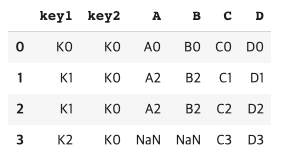
how='right'의 의미는 right에 해당하는 데이터프레임을 기준으로 한다는 의미이고,
여기에 on=['key1' ,'key2']가 작성된 것을 바탕으로
right 데이터프레임에 있는 key1과 key2를 기준으로
중복되는 값이 있으면 결합시키고, 없으면 NaN 처리하는 것이다.
---
(K0, K0), (K1, K0) : 각 데이터프레임에 모두 존재함 -> 결합시킨다.
(K2, K0) : right 데이터프레임에만 존재함 -> NaN 처리
---
```py
# 각 dataframe의 key1, key2 중 중복되는 값에 해당하는 부분만 merge
result_inner = pd.merge(left, right, how='inner', on=['key1', 'key2'])
result_inner
```
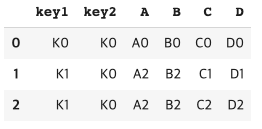
how='inner'는 각 dataframe의 기준값 중 중복되는 값에 해당하는 경우에만 결합시키는 역할을 한다.
---
left dataframe과 right dataframe이 동시에 가지고 있는 key1, key2인
(K0,K0), (K1,K0) 에 해당하는 값만 결합시킨다.
---
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.