codestates / codestates/ds-blog
[윤형준] Titanic Data Analysis (타이타닉 데이터 분석)
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
안녕하세요^^ 윤형준입니다.
태풍이 지나고 하늘이 매우 맑네요. 날씨도 선선해지니 천고마비의 계절이 어느새 다가온 듯 합니다. 날씨는 좋지만 아직 코로나 여파로 여러분들 모두 집에 계시는 시간이 많을줄 압니다. 그래서 여려분들의 따분한 시간을 덜어드리기 위해 오늘 유익한 읽을 거리를 한번 준비해 봤습니다.

모두들 1997년 영화 "타이타닉"을 아시나요? 레오나르도 디카프로오와 케이트 윈슬렛을 주연으로 한 재난 영화 입니다. 저도 어렸을때 매우 재밌게 본 영화에요. 아직까지 "타이타닉"의 아성을 버금가는 재난영화는 없다고 생각합니다.^^
자! 그래서 영화 이야기로 오늘의 블로그가 끝난다면 너무 시시하겠죠? 그리하여, 오늘은 타이타닉 데이터 가지고 분석을 한번 해보려고 합니다. 어떠신가요? ㅎㅎ 타이타닉을 영화로 또는 역사로만 접하신 분들은 생소할 수도 있지만 분석을 해본다면 좋은 인사이트를 얻어 가실수 있을거 같아요.
(타이타닉 데이터는 Data Science 입문용 데이터로써 교육용으로 활발히 사용되고 있습니다. 하지만 생소하셔도 괜찮습니다. 어려운 내용은 없으니까요. ㅎㅎ)
그럼 한번 시작해 볼까요?
먼저 데이터를 불러올게요!
```py
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import numpy as np
df = pd.read_csv('https://web.stanford.edu/class/archive/cs/cs109/cs109.1166/stuff/titanic.csv')
df
```
위에 코드들을 실행하시면 이렇게 멋진 테이블이 나타납니다. (I love Colab!) 아, 참고로 저는 이번에 Colab이라는 웹기반 에디터를 사용했구요, Colab이 생소하신 분들은 한번 사용해보시는 것을 추천드립니다. GPU도 Colab안에서 공짜로 사용할 수 있다고 하니까요!
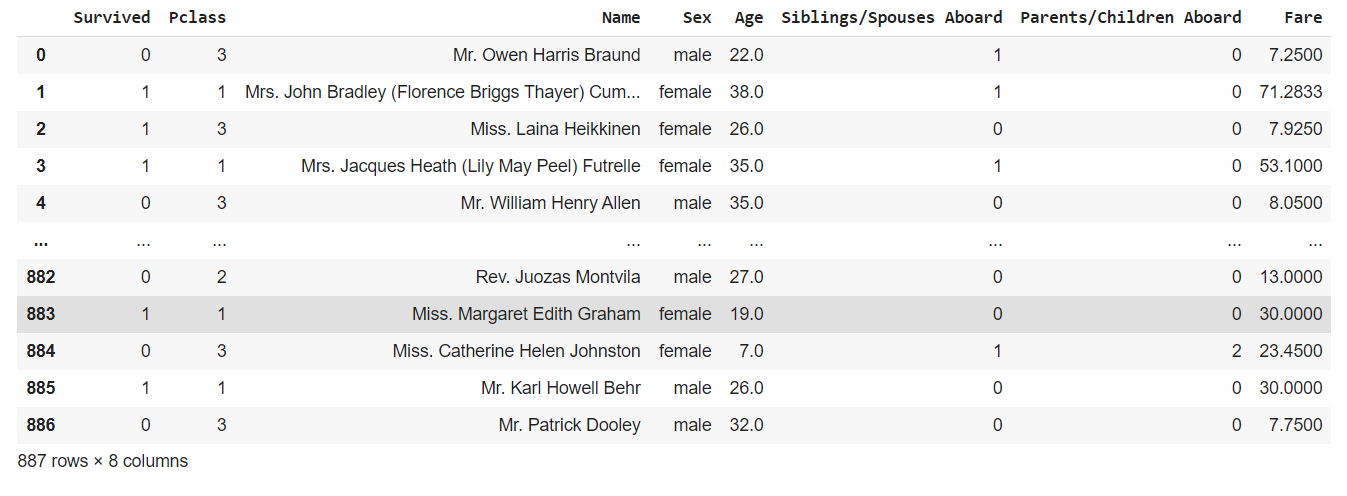
이 데이터에는 총 8가지 항목이 있네요? 이름, 성별, 나이, 그리고 Fare(요금). 이 항목들은 직관적으로 이해가 가실것 같아요. 이 사람들이 이런 이름과, 성별, 나이, 그리고 이 만큼의 요금을 내고 타이타닉에 탑승했다는 실제 역사적 데이터 입니다. 그리고 binary data 로 이루워져 있는 Survived 항목은 1일 경우 이 사람은 생존 했다는 기록이구요, 0일 경우 생존하지 못하였다는 뜻입니다.
나머지 항목들은 차차 설명을 드리도록 하겠구요, 우선 의미있는 그림들부터 보여드릴게요!
```py
sizes_D = df[df["Survived"]==0]["Sex"].value_counts().tolist()
sizes_S = df[df["Survived"]==1]["Sex"].value_counts().tolist()
labels_D = ["Male", "Female"]
labels_S = ["Female", "Male"]
fig = plt.figure(1, figsize=(10,3))
chart_1 = fig.add_subplot(121)
chart_2 = fig.add_subplot(122)
chart_1.pie(sizes_D, explode=explode, labels=labels_D, autopct='%1.1f%%', shadow=True, startangle=90)
chart_2.pie(sizes_S, explode=explode, labels=labels_S, autopct='%1.1f%%', shadow=True, startangle=90)
chart_1.set_title("Non-survivors")
chart_2.set_title("Survivors")
plt.show()
```
위에 코드들을 실행하면 아래와 같은 그림이 나온답니다 ^^
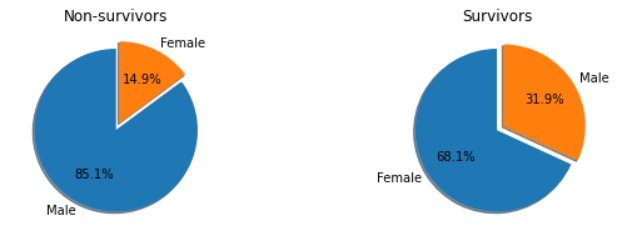
위의 그림과 같이 생존하지 못한 사람들 중에는 남성의 비율이 훨씬 크고, 생존자들 중에는 여성의 비율이 컸다는 것을 데이터 시각화를 통해 한눈에 볼수 있습니다. 만약에 성비가 차이가 많이 나지 않았다라면 우리는 성별 데이터로 부터 큰 의미를 찾지 못하는 것이 됩니다. 하지만 이러듯 큰 퍼센트로 남성이 여성보다 많이 죽었다는 것은 우리에게 생존 확률은 성별과도 큰 관계가 있었다는 것을 의미 합니다. (vice versa, 생존자 중에서도 남성보다도 여성의 비율이 더 크죠?^^)
생존 확률에 대한 다른 지표를 한번 또 보여드릴게요~ 자! 그전에 문제를 한번 내보도록 하겠습니다. 여러분들은 타이타닉에 높은 금액을 내고 탄 승객이 더 많이 살았을까요? 아니면 상관이 없을까요? 다들 나름대로 한번 생각을 해보시고 스크롤 다운 해보세요^^
```py
df = df.drop(df.loc[df["Fare"]>300].index.tolist()) #이 코드는 Fare column의 outlier 항목들을 제거합니다.
plt.figure(figsize=(5,10))
ax = sns.boxplot(x="Survived", y="Fare", data=df)
```
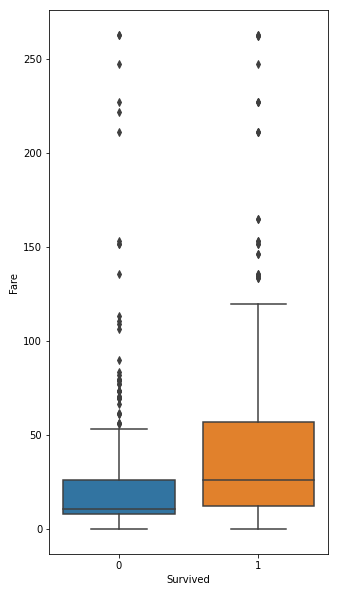
자! 위의 그림을 보시면 X 축에 Survior 와 Non-survior로 구분해 놨구요, 그들이 타이타닉에 타기 위해 낸 금액을 Y축에 표현했습니다. 위의 코드에 코멘트와 같이 extreme outlier들을 제거 했음에도 불구하고 아직 outlier들이 존재 하네요 ㅜㅜ Outlier를 제거하면 시각화 했을때 예쁜 그림이 나오지만, 너무 많은 데이터를 제거 해버리면 통계적 분석에 용이하지 않습니다.
여러분들이 어떤 logic을 가지고 예상 하셨을지 모르겠지만, 차트 상으로는 생존자들이 평균적으로 더 높은 금액을 내고 탔습니다. 이 뜻은 승객들이 낸 Fare와 생존률에도 관계가 있는 것이겠죠? 더 나아가 상상력을 발휘해보면 부자들이 높은 Fare를 냈을 테고 높은 Fare를 낸 승객들이 더 많이 살았기 때문에, ("부자" -> "High Fare" -> "Survived") 이런 logic이라면 부자들이 많이 survived 했을 것이다 라는 educated guess 를 해볼수도 있을것 같습니다.
이번에는 승객들을 연령별로 한번 나누어 볼게요!!
```py
# First create the column "Age_Group" and fill them in with zeros.
df["Age_Group"] = 0
# Assign appropriate names for each condition
for i in range(len(df["Age"])):
if df["Age"][i] < 10:
df["Age_Group"][i] = "Child"
elif (df["Age"][i] >= 10) and (df["Age"][i] < 20):
df["Age_Group"][i] = "10s"
elif (df["Age"][i] >= 20) and (df["Age"][i] < 30):
df["Age_Group"][i] = "20s"
elif (df["Age"][i] >= 30) and (df["Age"][i] < 40):
df["Age_Group"][i] = "30s"
elif (df["Age"][i] >= 40) and (df["Age"][i] < 50):
df["Age_Group"][i] = "40s"
elif (df["Age"][i] >= 50) and (df["Age"][i] < 60):
df["Age_Group"][i] = "50s"
elif (df["Age"][i] >= 60) and (df["Age"][i] < 70):
df["Age_Group"][i] = "60s"
elif (df["Age"][i] >= 70) and (df["Age"][i] < 80):
df["Age_Group"][i] = "70s"
elif (df["Age"][i] >= 80) and (df["Age"][i] < 90):
df["Age_Group"][i] = "80s"
# Create a new column, "Count"
df["Count"] = 1
```
자! 이 그림은 승객들을 연령별로 나누어, 어떤 연령대가 배가 가장 많이 타고 있었는지를 보여주는 그림입니다.
```py
# On the cruz, the 20s took up the most part of the passengers, and it followed by the 30s.
# 20대가 배에 가장 많았고 그 다음이 30대 입니다.
s = df.groupby(df["Age_Group"]).count()["Count"].sort_values(ascending=False)
plt.bar(s.index, s.values)
```
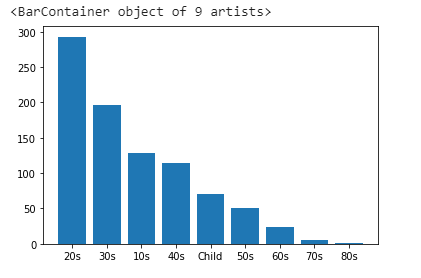
아하! 20대가 가장 많이 탔었고 그 다음이 30대 이네요! 하지만 이 그림으로만은 생존률에 대해서 아무런 이야기를 못하것입니다. 그래서 데이터를 다시 예쁘게 만져서 의미있는 결과를 한번 도출해 볼게요^^
```py
died_df = df[df["Survived"]==0].groupby("Age_Group").count()["Count"]
surv_df = df[df["Survived"]==1].groupby("Age_Group").count()["Count"]
died_df = died_df.reindex(["Child", "10s", "20s", "30s", "40s", "50s", "60s", "70s", "80s"])
surv_df = surv_df.reindex(["Child", "10s", "20s", "30s", "40s", "50s", "60s", "70s", "80s"])
width = 0.7
p1 = plt.bar(died_df.index.values, died_df, width)
p2 = plt.bar(surv_df.index.values, surv_df, width, bottom=died_df)
plt.ylabel('Total Passengers on Titatnic')
plt.xlabel('Age Group')
plt.legend((p1[0], p2[0]), ('Non-Survivors', 'Survivors'))
plt.show()
```
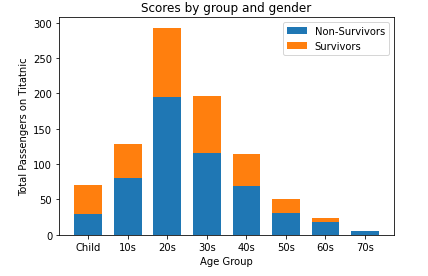
자! 이번엔 어떠신가요? Child 라는 연령대를 빼고는 모든 연령대에 산 사람보다 죽은 사람이 더 많습니다. 아무래도 10대 이전인 아이들은 되도록이면 구조 보트에 태워서 살릴려고 했었던거 같아요. 여러분도 동의 하시나요?
마지막으로 그림을 하나 더 보여 드릴게요.
```py
df_m = df[df["Sex"]=="male"]
df_f = df[df["Sex"]=="female"]
ml = df_m.groupby("Pclass").mean()["Fare"].tolist()
fl = df_f.groupby("Pclass").mean()["Fare"].tolist()
x_axis = np.array([1,2,3])
width = 0.35
plt.bar(x_axis-width/2, ml, width = width, color = "blue", label = "Male")
plt.bar(x_axis+width/2, fl, width = width, color = "orange", label = "Female")
plt.title("Pclass vs Fare")
plt.ylabel("Fare")
plt.xlabel("Pclass")
plt.xticks(range(1,4))
plt.legend()
plt.show()
```
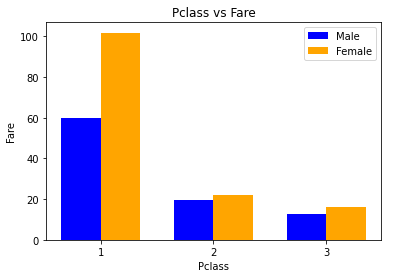
위 그림은 X축에 Pclass 라는 항목이 있습니다. 이 항목은 즉 Pclass = 1 은 일등석, Pclass = 2 는 비지니스석, Pclass = 3 은 일반석 이 정도로 생각하시면 될 것 같습니다. 자! 이 그림에서 제가 하고자 하는 이야기는 승객들을 Pclass 별로 나누었구요, Y축에 Pclass 별 평균 요금을 나타냈어요. 그래서 당연한 이야기지만 일등석이 가장 높은 평균 요금을 나타내고 있습니다.
여기서 제가 하나 더 디테일을 추가한 점은요, Pclass별 성별을 나누었다는 것입니다. 모든 Pclass가 여성들이 남성보다 더 많은 요금을 내고 탔다는 이야기 인데요. 앞서서 여성들의 생존률이 더 높다고 분석을 하였고, 또 이어서 높은 요금을 낸 승객들이 생존률이 높았습니다. 이 뜻은 생존률을 결성하는데에 두가지 factor들 즉, 여성인 점과 높은 금액을 냈다는 점이 double counting 이 될 수도 있다는 뜻입니다. (이 부분에 대해서 더 깊은 insight가 있으신 분은 코멘트로 남겨 주세요!)
이 마지막 문제에 대해서 상상력을 발휘하여 왜 여성이 더 많은 금액을 냈을까 생각해 보셔도 좋구요, 분석가 분들은 멋진 코드로 저를 한번 설득시켜 주시기 바랍니다. ^^
저는 이렇게 방콕하며 타이타닉 데이터를 분석해 보았는데요. 여러분들은 평소에 집에서 무얼 하고 지내시나요? 여러분들의 소소한 취미나 관심거리를 아래 댓글에 남겨주시면 감사하겠습니다. ^^ 여러분들의 관심과 댓글은 저에게 힘이 됩니다~ㅎㅎ 그럼 오늘도 화이팅~~!!!
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.