codestates / codestates/ds-blog
[김태헌_200904]_타이타닉 데이터. Pclass와 생존율의 관계
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
## 내 생각 & 목표
* **높은 등급의 Pclass를 사용하는 사람이 우선적으로 구조되어 생존율이 더 높지 않을까.**
* **Pclass와 생존율의 관계를 알아본다.**
---
## 시작
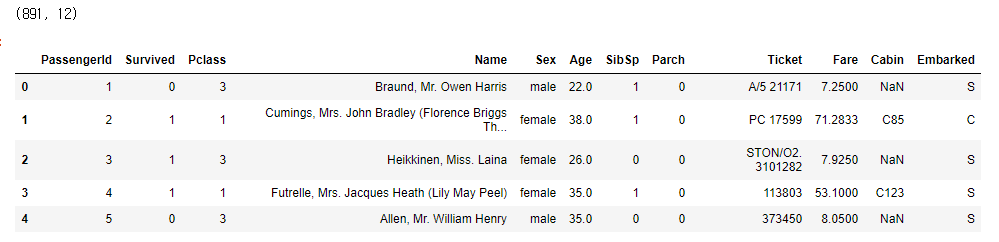
필요한 데이터셋을 불러온다.
```py
%matplotlib inline # jupyter notebook 을 사용할경우 `matplotlib` 를 이용해 시각화한 결과를 바로 보여주는 기능.
import pandas as pd #판다스 패키지를 불러온다.
import seaborn as sns # 시각화를 위해 씨본 패키지를 불러온다.
# 타이타닉 데이터를 불러온다.
train = pd.read_csv("train.csv")
print(train.shape) # 혹시몰라 shape를 사용해 row와 column 의 수를 확인한다.
train.head()
```
아웃풋 보기
---
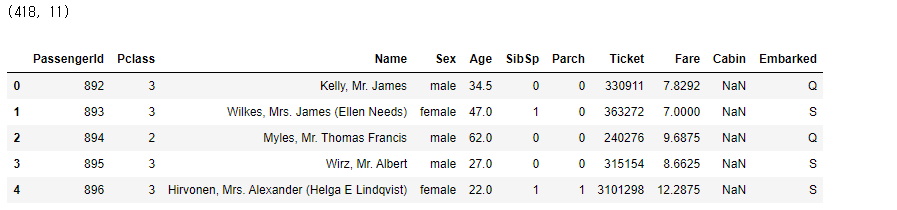
train 과 동일하게 test도 불러와준다.
```py
test = pd.read_csv("test.csv")
print(test.shape)
test.head()
```
아웃풋 보기
---
## 과정
먼저 시각화를 통해서 Pclass별 생존율을 알아보자.
```py
sns.countplot(data = train, x = "Pclass", hue = "Survived")
# hue는 데이터의 종류에 따라 다른 색으로 그래프를 표현합니다.
# x = "Pclass" 을 기반으로 hue = "Survived" 생존자와 사망자를 구분하라는 뜻.
# 0은 사망자의 수, 1은 살아남은 사람의 수.
```
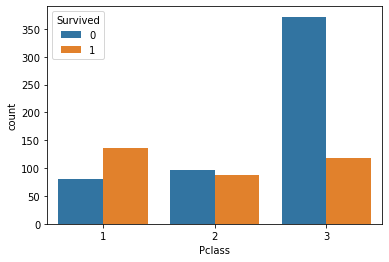
그래프를 보면 제일 높은 등급(Pclass 1)은 생존자가 사망자보다 상대적으로 월등히 높고, Pclass 2는 사망자가 조금 많고 Pclass3은 생존자 수의 비해 사망자가 매우 높은걸 알수있다. 이로써 높은 등급의 Pclass를 이용한 승객의 생존율이 높다고 유추할수있다.
하지만 정확한 수치가 나와있지 않아서 직관적이지만 대략적인 느낌이다.
**피벗테이블 사용**
피벗테이블은 어떤 데이터 안에있는 두개의 컬럼을 지정하고, 행 과 열로 인덱스 하여 데이터를 조회하여 나타내어준다.
```py
pd.pivot_table(data = train, index = "Pclass", values = "Survived")
# 피벗테이블을 사용하여 각 Pclass별 생존자가 얼마나 되는지 확인.
```
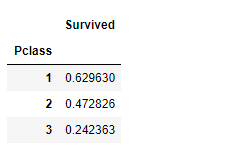
Pclass 1(제일 높은 객실등급)을 사용하는 사람의 생존율은 62%, Pclass 2(두번째로 높은 객실등급)를 사용하는 사람의 생존율은 47%, Pclass 3(제일 낮은 등급)은 24% 이므로 Pclass 1 의 생존율이 가장 높다. (역시 돈..)
단순히 퍼센테이지로만 나타내었기 때문에 정확히 몇명인지는 확인할수가 없다.
Pclass 1 이 생존율 62% 라고 해도 만약 50명중 62% 라고 한다면 오히려 생존자의 숫자는 다른 Pclass가 더 높을수도 있다는 생각을 했다.
**각각의 Pclass 등급별 인원을 알아보자**
```py
print(len(train[train["Pclass"] == 1]))
print(len(train[train["Pclass"] == 2]))
print(len(train[train["Pclass"] == 3]))
```

맨 위에 train데이터 row의 갯수는 891개. 즉 생존자 + 사망자 = 891 라는것인데 각 등급별 row의 갯수를 전부 더하면 891이 된다.누락된 데이터는 없다는 얘기!
**이제 각각의 Pclass 인원수를 가지고 생존자와 사망자의 수를 알아보자.**
먼저 Pclass를 등급별로 나누어 변수(train_p1, train_p2, train_p3) 에 대입해준다.
```py
train_p1 = train[train["Pclass"] == 1]
train_p2 = train[train["Pclass"] == 2]
train_p3 = train[train["Pclass"] == 3]
```
Pclass 등급별로 나눈 데이터를 불러와 이번에는 생존자(1) 만 추려내어 변수(train_ps1, train_ps2, train_ps3)에 대입해준다.
```py
train_ps1 = train_p1[train_p1["Survived"] == 1]
train_ps2 = train_p2[train_p2["Survived"] == 2]
train_ps3 = train_p3[train_p3["Survived"] == 3]
```
마지막으로 Pclass 등급별 생존자 데이터의 row를 print하여 몇명이 있는지 알아보자.
```py
print("Pclass1")
print(train_ps1.shape)
print(len(train_ps1))
print(" ")
print("Pclass2")
print(train_ps2.shape)
print(len(train_ps2))
print(" ")
print("Pclass3")
print(train_ps3.shape)
len(train_ps3)
print(" ")
```
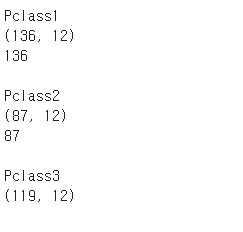
Pclass 1을 이용한 승객은 216명중 136명이 생존
Pclass 2를 이용한 승객은 184명중 87명이 생존
Pclass 3을 이용한 승객은 491명중 119명이 생존했다.
내가 한 과정 전부 보기
먼저 제일 근본인 train데이터를 살펴본다.
총 891개의 row와 12개의 column이 있다.
```py
print(train.shape)
train.head()
```
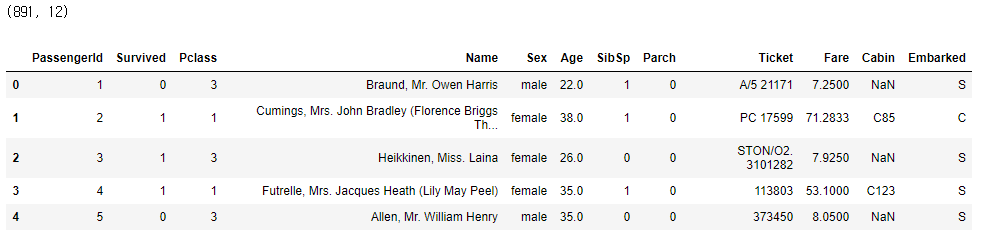
그중 Pclass 를 보면 1, 2, 3 이 있는데 이제부터 train데이터를 Pclass 1, 2, 3을 기준으로 찢을차례이다.
**빠른 이해를 위해 Pclass 1 하나로 진행**
```py
train[train["Pclass"] == 1]
```
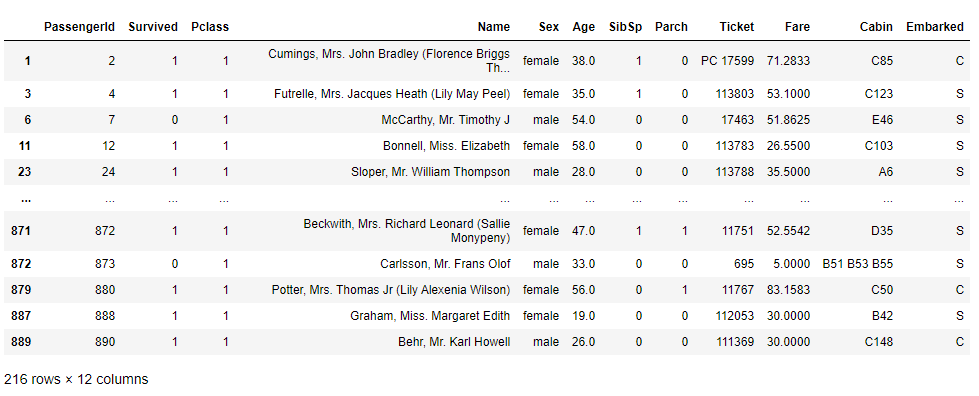
보면 Pclass 밑으로 숫자가 쭉 1(제일 높은 등급)인것을 볼수있다. 그리고 맨 밑에 보면 row가 216인것을 확인할수있다.
즉, Pclass 1 승객의 수가 총 216명인것이다.
그러면 다음으로 Survived 컬럼을 보자. 1(생존)과0(사망)이 섞여있다. 이것 역시 전부 1만 걸러내주자.
```py
train[train["Survived"] == 1]
```
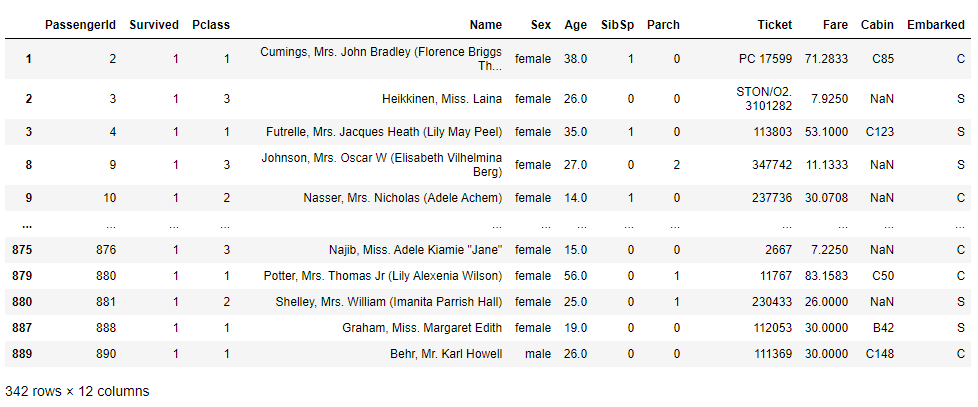
다음으로 넘어가려했는데 다시 보니까 Pclass가 다시 원점이다. 1 만 모아놨을 터인데 1, 2, 3 이 다같이 있다..
Pclass 1 의 Survived 데이터를 만지고 싶은데 막막하다..
```py
# 실패한 코드1
print((train[train["Pclass"] == 1]),(train[train["Survived"] == 1]))
```
이러면 그냥 각각의 데이터 결과값이 나온다..
```py
# 실패한 코드2
len((train[train["Pclass"] == 1]),(train[train["Survived"] == 1]))
```
이러면 에러..소괄호 대신 대괄호를 사용해도 에러..
에러명을 검색해보니 괄호를 사용할수없다고...이 외에도 셀수없이 많이 쓰고 지웠다.
그러다가 생각난것이 '변수'이다. Pclass를 변수에 넣고 Survived 를 만지면 가능하지 않을까...?
```py
train_p1 = train[train["Pclass"] == 1]
```
결과는 성공이었다. 이 뿌듯함..ㅎ
그럼 바로 train_p1을 베이스로 Survived의 1만 걸러내어보자.
```py
train_p1[train_p1["Survived"] == 1]
```
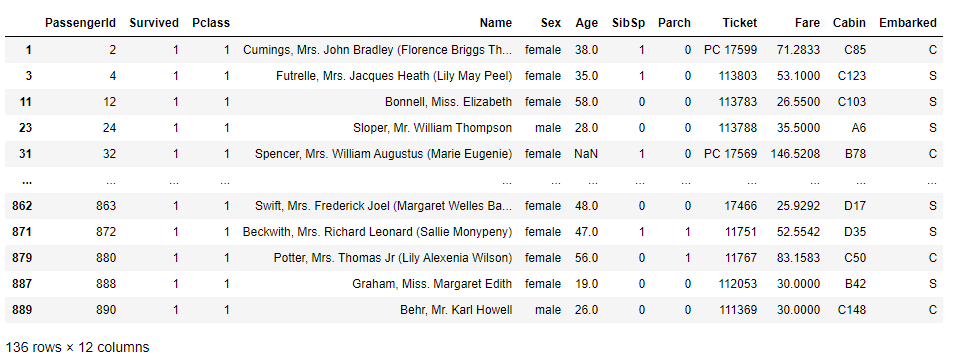
성공했다!
Pclass 의 row 를 1로, Survived 도 전부 1로 바꿔주었다. 그러면 맨아래 row가 136이니까 Pclass의 생존자는 136명이란 것이다.
## 결과
**예상했던대로 높은 객실등급을 이용한 사람들의 생존율이 다른 객실등급의 사람들보다 상대적으로 생존율이 높은것을 알수있다.**
## 후기
정말 쏟아부은 시간에 비해 끝나고 본 결과물이 너무 부끄러워서 슬프다..
최대한 다른 자료를 보지 않고(따라할거같아서..)내가 생각한 것을 도출하기위한 최소한의 자료 참고와 기본 지식으로 해보았다.
이번 글은 앞으로 코드스테이츠 부트캠프에서 배우면서 내가 얼마나 성장하는지, 얼마나 성장 했는지의 기준점이 되지 않을까 싶다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.