codestates / codestates/ds-blog
[방승진] 200904 타이타닉 데이터 분석
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
타이타닉 데이터 분석
목차
1. 개요
2. 궁금한 점
3. 데이터 분석
1. 기본적인 데이터 구성
2. 좌석 등급별 생존율
3. 좌석 등급별 어린이 생존율 비교
4. 장소별 생존율 비교
4. 결론
---
1. 개요
97년 개봉했던 영화 '타이타닉'이 생각난다.
당시엔 이 영화가 제임스 카메론 감독이 만든 영화라던가,
레오가 이렇게 성공할 것이라던가,
알 만한 나이가 아니었던 걸로 기억한다.
물론 케이트 윈슬렛을 빼놓을 순 없지...
솔직히 이 글을 쓰기 위한 검색에서 놀랐다.
여배우가 케이트 윈슬렛이었어???
새삼 알게 되었다. 이 영화가 '대작'이었음을...
아직도 이 장면은 생생하다.
너무 어렸던 때지만,
또래 친구들이 이 장면을 따라하는 모습도 종종 봤던 것 같다.
서양도 크게 다르진 않은 듯...
(갈매기에게 새우깡 대신 콧물을 주는 게 좀 다른 것 같기도?)
---
나름 재밌게 시작하려고 했지만...
사실, 대규모 인원이 희생된 안타까운 사건이었다.
총 2,224명의 인원 중 생존자는 단 706명, 생존율로 따지면 고작 31.74%라니까.
이번 글에선
Kaggle 에서 받은 891명의 일부 데이터를 토대로,
이 사건을 알게 되고 떠오른 궁금한 점 몇 가지를 토대로 기초적인 Python 수준에서 정리해보려고 한다.
이 글을 토대로 기초적인 Python 활용사례를 누군가 경험해보는 기회가 되었으면 좋겠다.
2. 궁금한 점
궁금증 1 : 여성과 아이를 먼저 구조하는 상황이 실제 벌어졌을까?
궁금증 2 : 부(wealth)에 따라 생존율에 차이가 있지 않을까?
궁금증 3 : 출발지 및 경유지가 총 3곳이던데, 장소별 생존율 차이가 있지 않을까?
크게 3 가지 궁금증이 생겼고,
주어진 자료만으로 찾아보는 기회를 가졌다.
3. 데이터 분석
**1. 기본적인 데이터 구성**
먼저 데이터 분석을 위한 기초 라이브러리인 Pandas와 Numpy를 불러왔다.
이를 통해 데이터의 기본적인 요소를 알아보고 범주형 자료에 해당하는 열을 matplotlib으로 대략적으로 그려봤다.
- Input
```py
from google.colab import drive
drive.mount('/content/drive')
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
df = pd.read_csv('/content/drive/My Drive/datasets_train.csv')
def bar_chart(feature):
Survived = df[df["Survived"] == 1][feature].value_counts()
Dead = df[df["Survived"] == 0][feature].value_counts()
df_train = pd.DataFrame([Survived, Dead])
df_train.index = ['Survived', 'Dead']
df_train.plot(kind = 'bar')
bar_chart('Sex')
bar_chart('Pclass')
bar_chart('Embarked')
bar_chart('Parch')
bar_chart('SibSp')
```
- Output
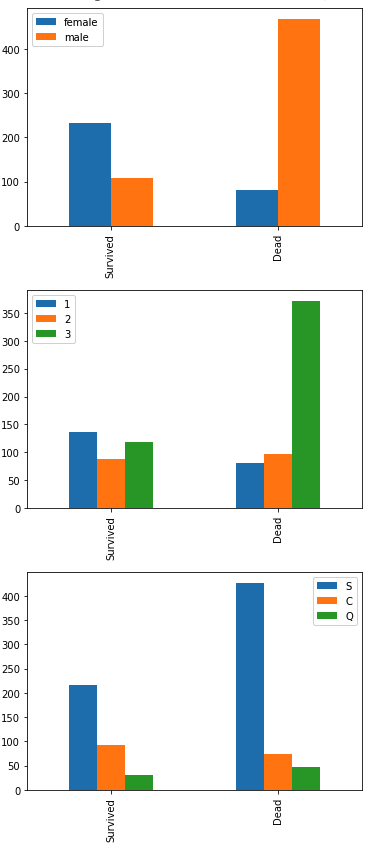
첫 번째 바 차트를 보면, 여성 생존자가 상대적으로 많은 것을 알 수 있다.
두 번째 바 차트를 보면, 1등석 승객의 생존자가 가장 많고, 3등석 승객의 사망자가 압도적으로 많은 것을 알 수 있다.
세 번째 바 차트를 보면, 사우샘스턴(S)에서 탑승한 승객의 생존 및 사망자가 많다.
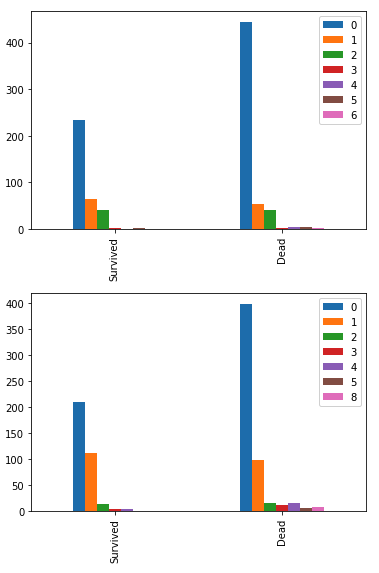
네 번째와 마지막 차트는 각각 Parch(부모와 아이 동반 인원), SibSp(형제, 자매 및 배우자 동반 인원)을 나타내는데,
추가로 알아낼 만한 것이 한 눈에 보이지 않는 것 같다.
---
먼저 궁금증 1("여성과 아이를 먼저 구조하는 상황이 실제 벌어졌을까?")을 알아보고자 했다.
위에서 보았던 바 차트를 통해 여성 생존자가 많다는 것은 이미 확인했고, 생존율을 구체적으로 알아보고자 한다.
- Input
```py
cnt_female = df[(df['Survived'] == 1) & (df['Sex'] == 'female')].shape[0]
cnt_male = df[(df['Survived'] == 1) & (df['Sex'] == 'male')].shape[0]
Total_surv = cnt_female + cnt_male
print("여성 생존자 비율 : ", np.round(cnt_female / Total_surv * 100, decimals=2), '%')
print("남성 생존자 비율 : ", np.round(cnt_male / Total_surv * 100, decimals=2), '%')
```
- Output
```
여성 생존자 비율 : 68.13 %
남성 생존자 비율 : 31.87 %
```
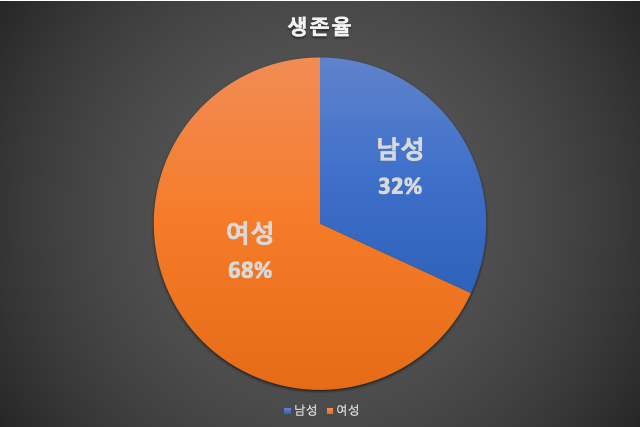
여성이 상대적으로 생존율이 높은 것으로 나타난다.
어린이(13세 미만 가정) 생존율은 어땠을까?
추후 좌석등급별 어린이 생존율 비교를 통한 항목에서 알아볼 것이다.
---
**2. 좌석 등급별 생존율**
다음으론 궁금증2("부(wealth)에 따라 생존율에 차이가 있지 않을까?")를 알아보았다.
이를 위해 좌석 등급을 부의 척도로 가정했다.
(1등석이 가장 비싸다.)
- Input
```py
# Pclass와 Survived를 가져온 후, Pclass로 묶는다. 그러면 각 Pclass마다 0, 1(Survived 값)이 count가 된다.
# 이를 통해 각 Pclass에 몇 명이 있는지 확인 가능하다.
df[['Pclass', 'Survived']].groupby(['Pclass'], as_index = True).count()
```
```py
# sum()을 통해 생존자의 합계를 알 수 있다.
df[['Pclass', 'Survived']].groupby(['Pclass'], as_index = True).sum()
```
```py
# Pclass별 생존율 구하기
# group화된 객체에 mean()을 통해 평균값(각 등급별 생존율)을 구할 수 있다.
print(np.round(df[['Pclass', 'Survived']].groupby(['Pclass'], as_index =True).mean() * 100, decimals = 2), '%')
```
```py
# by = column_set , ascending = True(오름차순) / False(내림차순)
df[['Pclass', 'Survived']].groupby(
['Pclass'], as_index = True).mean().sort_values(by = 'Survived', ascending = False
).plot.bar()
```
- Output
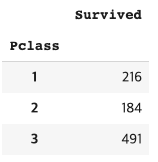
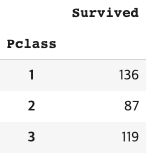
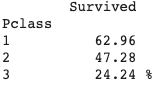
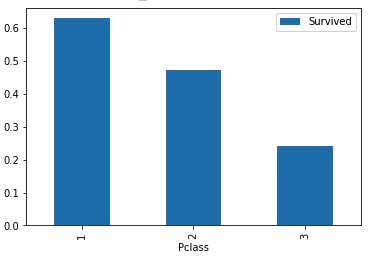
1, 2, 3등석 승객순으로 생존율이 높은 것으로 나타난다.
이를 토대로 볼 때 부가 생존율의 척도(부자일수록 생존률이 높다)가 된 것으로 추측할 수 있다.
---
**3. 좌석 등급별 어린이 생존율 비교**
- Input
```py
#좌석등급별 어린이 탑승인원
youth_1 = df[(df['Age'] < 13) & (df['Pclass'] == 1)].shape[0]
youth_2 = df[(df['Age'] < 13) & (df['Pclass'] == 2)].shape[0]
youth_3 = df[(df['Age'] < 13) & (df['Pclass'] == 3)].shape[0]
print('1등석 어린이 탑승인원 : ', youth_1)
print('2등석 어린이 탑승인원 : ', youth_2)
print('3등석 어린이 탑승인원 : ', youth_3)
#좌석등급별 어린이 생존율
surv_youth_1 = df[(df['Age'] < 13) & (df['Pclass'] == 1) & (df['Survived'] == 1)].shape[0]
surv_youth_2 = df[(df['Age'] < 13) & (df['Pclass'] == 2) & (df['Survived'] == 1)].shape[0]
surv_youth_3 = df[(df['Age'] < 13) & (df['Pclass'] == 3) & (df['Survived'] == 1)].shape[0]
print("1등석 어린이 생존율 : ", np.round(surv_youth_1 / youth_1 * 100, decimals=2), '%')
print("2등석 어린이 생존율 : ", np.round(surv_youth_2 / youth_2 * 100, decimals=2), '%')
print("3등석 어린이 생존율 : ", np.round(surv_youth_3 / youth_3 * 100, decimals=2), '%')
#좌석등급별 어린이 사망률
dead_youth_1 = df[(df['Age'] < 13) & (df['Pclass'] == 1) & (df['Survived'] == 0)].shape[0]
dead_youth_2 = df[(df['Age'] < 13) & (df['Pclass'] == 2) & (df['Survived'] == 0)].shape[0]
dead_youth_3 = df[(df['Age'] < 13) & (df['Pclass'] == 3) & (df['Survived'] == 0)].shape[0]
print("1등석 어린이 사망률 : ", np.round(dead_youth_1 / youth_1 * 100, decimals=2), "%")
print("2등석 어린이 사망률 : ", np.round(dead_youth_2 / youth_2 * 100, decimals=2), "%")
print("3등석 어린이 사망률 : ", np.round(dead_youth_3 / youth_3 * 100, decimals=2), "%")
```
- Output
```
1등석 어린이 탑승인원 : 4
2등석 어린이 탑승인원 : 17
3등석 어린이 탑승인원 : 48
1등석 어린이 생존율 : 75.0 %
2등석 어린이 생존율 : 100.0 %
3등석 어린이 생존율 : 41.67 %
1등석 어린이 사망률 : 25.0 %
2등석 어린이 사망률 : 0.0 %
3등석 어린이 사망률 : 58.33 %
```
단순히 비율로 보면 2등석 어린이 생존율이 가장 높고, 1등석 어린이 생존율이 그 다음이므로
이 경우엔 부가 생존율의 척도로 작용하지 않는 것처럼 보인다.
그러나,
각 등급별 어린이 탑승인원을 보면 3등석 어린이 탑승인원이 가시적으로 많으며,
1등석 및 2등석 어린이 탑승인원은 상대적으로 적은 것으로 확인된다.
3등석 어린이의 생존율이 41.67%로,
가장 많은 인원이 속한 범주에서 가장 낮은 생존율을 보여준다.
이를 토대로 보면,
부가 생존율의 척도로 작용되었을 가능성을 부정하기 어렵다.
---
**4. 장소별 생존율 비교**
마지막 궁금증인 "장소별 생존율 차이가 있지 않을까?"를 알아보았다.
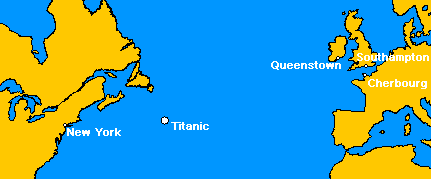
출발지는 영국의 사우샘프턴(Southampton),
경유지는 프랑스의 셰르부르(Cherbourg)와
아일랜드의 퀸즈 타운(Queens town)로,
원래대로라면 뉴욕에 도착했어야 했다.
- Input
```py
import matplotlib.pyplot as plt; plt.rcdefaults()
import numpy as np
import matplotlib.pyplot as plt
S_loca = np.round(depa_S / Total_surv * 100, decimals=2)
C_loca = np.round(depa_C / Total_surv * 100, decimals=2)
Q_loca = np.round(depa_Q / Total_surv * 100, decimals=2)
#장소별 생존율 차트
objects = ('Southampton', 'Cherbourg', 'Queenstown')
y_pos = np.arange(len(objects))
performance = [S_loca, C_loca, Q_loca]
plt.bar(y_pos, performance, align='center', alpha=0.5)
plt.xticks(y_pos, objects)
plt.ylabel('Survival rate')
plt.title('Survival rate by location')
plt.show()
```
- Output
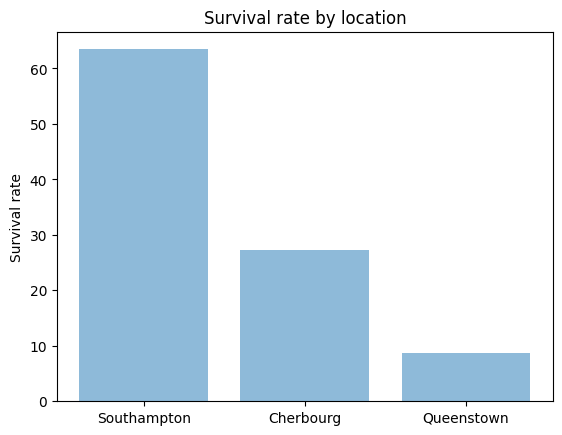
상대적으로 출발지인 사우샘프턴에서 탑승한 승객들의 생존율이 압도적으로 높았다.
사용한 데이터가 일부 자료에 불과하기 때문에,
그 원인까지 알아내긴 어려울 것 같다.
하지만 추측은 해볼 수 있다.
등급별로 좌석이 분리되어 있다고 하더라도
등급 내 좌석 선점은 비교적 자유롭지 않았을까? (ex. 선착순)
4. 결론
위의 자료를 정리해보면서,
여성이 상대적으로 높은 생존율을 보인 것을 확인했다.
이를 토대로 여성이 먼저 구조대상이 되었을 가능성이 높음을 알 수 있다.
어린이 역시 먼저 구조대상이 되었을지는 위의 자료로는 확인하기 어렵다.(보완이 필요하다.)
또한 좌석등급별 생존율을 토대로,
비교적 부유할수록 생존율이 높은 것을 알 수 있었다.
장소별 생존율은 사우샘프턴이 가장 높았는데,
해당 자료만으로 장소에 따른 생존율 차이가 나타났는지는 단정짓기 어려워보인다.
---
**개인적인 생각 추가**
이번 글에서는 데이터를 정리하는데 어려움을 많이 느꼈다.
무엇보다 1, 2, 3등석 승객별 생존율을 잘못 산출해내서 고치는데 많은 시간을 투입했다.
그 주요 원인은 Pandas를 잘 다루지 못했다는 것, 즉 실력 부족이다.
추가로 과제 제출 당시 시간이 부족해서 퇴고를 제대로 하지 못하고 제출했다는 문제도 있다.
글은 잘 쓸 수도, 못 쓸 수도 있다.
못 썼다면 못 쓴 원인을 찾아내고 수정해나가면 된다.
그런데,
이번 과제는 치명적인 오류가 많았기 때문에,
수정하면서 개인적으로 준 점수는 1점이다.
(심지어 아직도 부족한 점이 많아 보인다.)
아마 첫 과제라,
너그러이 2점으로 평가를 해주신 것 같다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.