codestates / codestates/ds-blog
[최근후] Graph Database
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
# Intro
IT 의 급속한 성장에 따라 다양한 디바이스와 서비스들이 생겨나게되고, 그로부터 만들어지는 데이터또한 각자 다른 형태를 가진다. 또한, 특정 서비스에선 실시간으로 대용량의 데이터가 쏟아져 나와 이를 활용할 수 있는 새로운 데이터베이스의 필요성이 대두되고있다.
지난 수십년간 기업들의 데이터운영에 크게 기여했던 관계형 데이터베이스는 이미 정의된 엄격한 스키마에따라 테이블형태에 객체를 저장하고, 외래키와 JOIN 문을 활용하여 각 객체간의 관계를 형성했다. 하지만, 그러한 관계형 데이터베이스의 형태로 데이터의 다양한 변화에 대응을할 수 있을까 라는 의문이 생겨났고, 그에 대한 답으로 등장한 것이 NoSQL 이다. NoSQL 에는 크게 3가지(Document DB, Key-Value DB, Graph DB)가 있는데, 그 중 여기서 알아볼 것은 그래프 데이터베이스(Graph DB)다.
# Graph Database
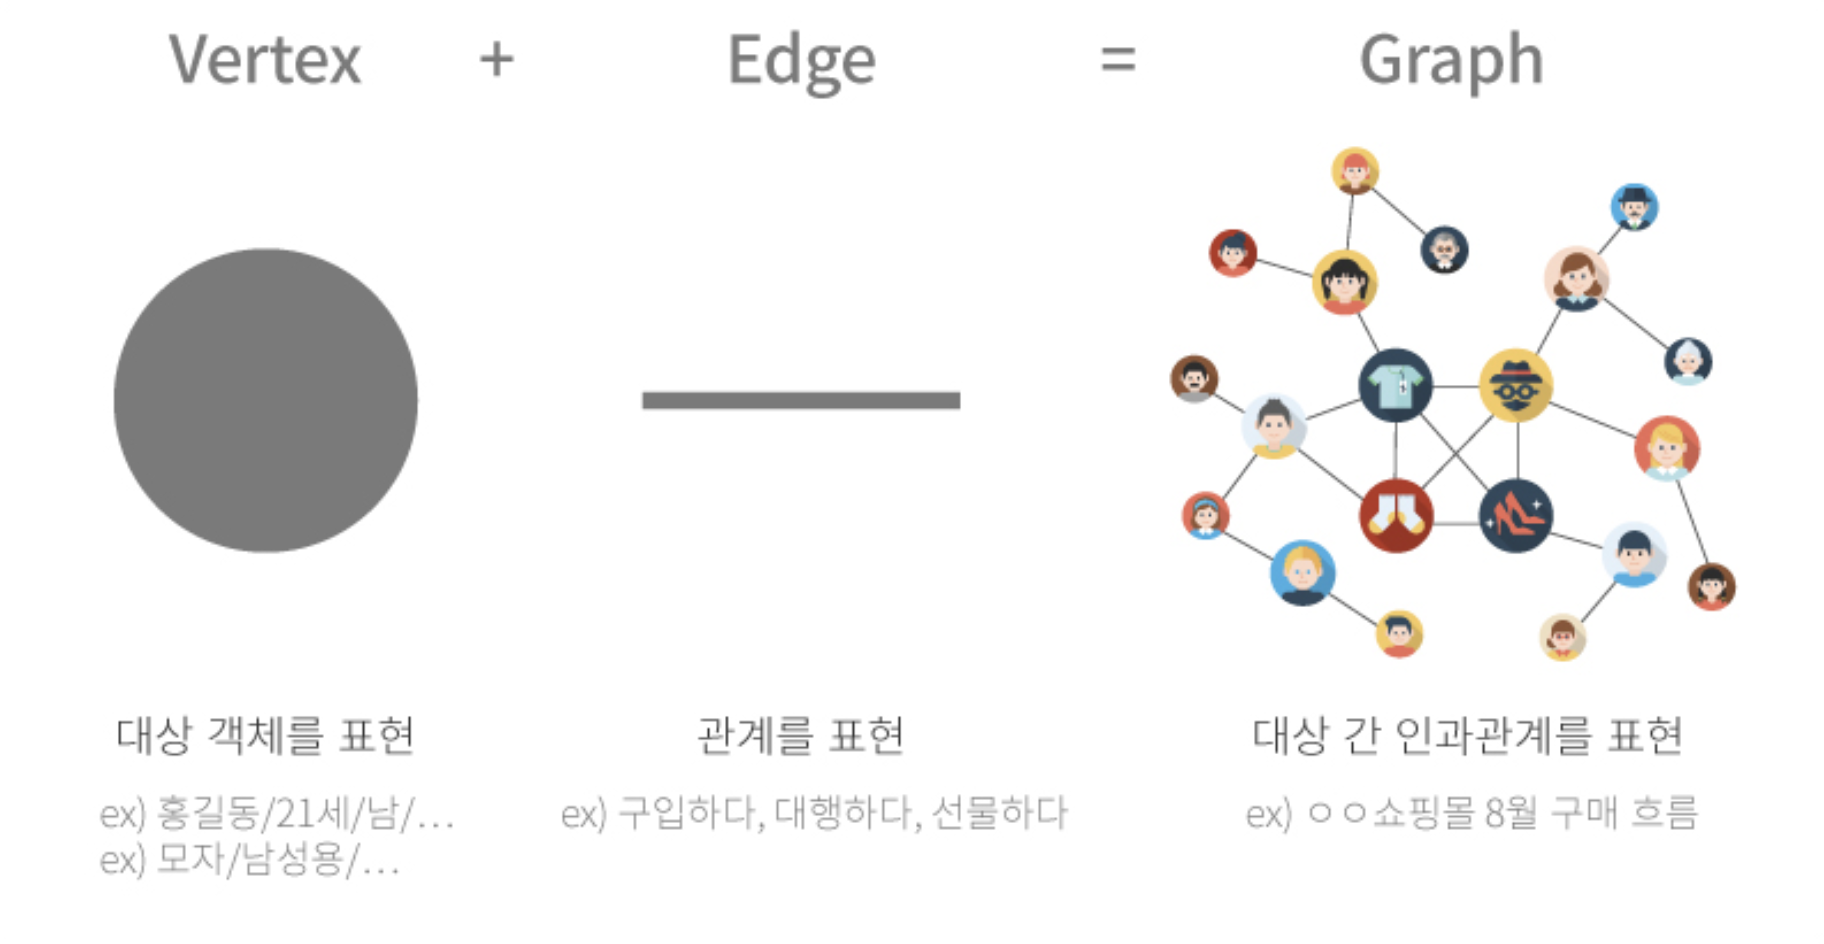
그래프 데이터베이스는 노드, 엣지, 프로퍼티와 함께 그래프 구조를 사용하여 데이터를 표현하고 저장하는 데이터베이스이다.
- 노드(Node) 혹은 정점(Vertex): 추적 대상이 되는 사람, 기업, 계정 등 의 객체를 대표한다.
- 엣지(Edge): 관계(relationship)이라고도 하며 노드를 다른 노드에 연결하는 선이다.
- 프로퍼티(Property): 노드의 정보를 말한다.
이러한 형식의 데이터 형식은 SNS, 추천 시스템, 부정 거래 탐지 같이 밀접한 상호 관계를 가지는 데이터를 다루는 서비스에 높은 효율성을 보여준다.
### 1. 직관성
그래프 데이터베이스는 각각의 객체(Entity)를 노드(Node)로 저장하고, 이를 간선(Edge)이라는 관계망으로 연결한다. 이것은 테이블 형태에 맞춰진 데이터 형식인 관계형 데이터베이스보다 훨씬 현실적인 모형에 가까운 데이터라는 느낌을 주어 데이터의 상관관계에 대한 높은 직관성을 제공한다.
### 2. 유연성
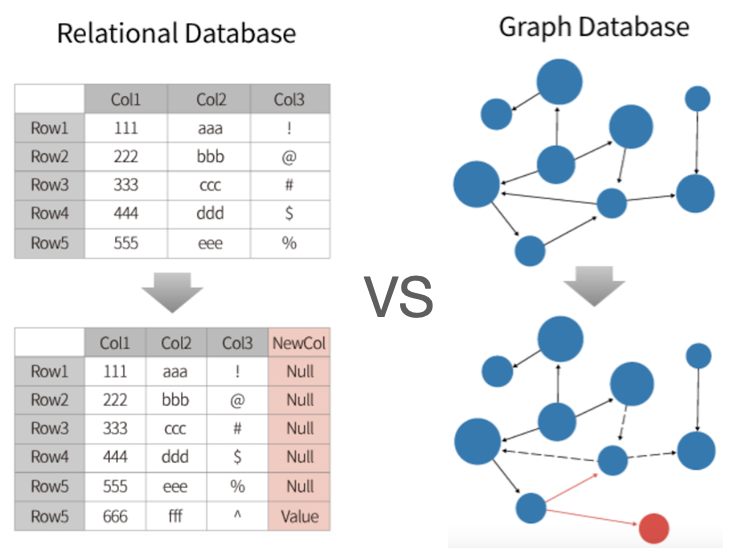
그래프 데이터베이스는 데이터를 하나의 객체로 저장하기 때문에 데이터의 변화에 유연하게 대응할 수 있다.
관계형 데이터베이스에선 새로운 속성을 가진 데이터가 등장하면 하나의 row를 위해 컬럼을 새로 만들고, 다른 row들은 불필요하게 null값으로 채우고, 외래키를 적용해야할 테이블을 확인하고, 제약도 추가해야 하는 등 많은 작업이 요구된다.
하지만, 그래프 데이터베이스에선 새로운 노드를 만들고 그것과 관련된 노드들과 엣지로 연결해주는 작업만을 요구한다. 이러한 점에서 그래프 데이터베이스는 유연하다고 볼 수 있다.
### 3. 쿼리 처리 속도
관계형 데이터베이스에선 복잡한 관계를 가진 데이터를 조회하기 위해서 JOIN문을 통해 질의(query)해야한다. 반면에, 그래프 데이터베이스에선 노드들이 엣지로 연결되어 있기에 탐색 방식으로 데이터를 조회한다. 이러한 차이점 때문에, 두 데이터베이스는 쿼리 처리 속도 측면에서 차이를 나타낸다. 예를들어, SNS에서 어떤 사용자의 친구의 친구의 친구를 검색하는 상황을 생각해보자, 그래프 데이터베이스에선 JOIN과 GROUP BY를 사용하지않기에 쿼리의 복잡도에따라 속도차이는 많게는 몇천배가 날 수 있다.
# 그래프 데이터베이스의 활용
높은 연관성을 같은 데이터를 다루는 서비스들은 그래프 데이터베이스를 사용하는 것이 기존의 관계형 데이터베이스를 사용하는 것보다 훨씬 효율적이다.
페이스북은 실제로 활동하는 사용자가 10억명 이상이다. 그 사용자들은 한번 접속 할 때마다 수백개의 데이터를 생산하는데, 이것은 페이스북의 데이터 백엔드에 엄청난 부하를 낳았다. 페이스북은 엄청나게 쏟아지는 데이터를 관계형 데이터베이스로 관리할 수 없다는 것을 깨닫고, 일찍이 자신만의 그래프 데이터베이스인 TAO를 구축하여 사용하고있다.
카카오 또한 자체적인 그래프 데이터베이스인 S2Graph를 개발했다. 그 이유는 앞서 말한 페이스북의 이유와 비슷하다. 카카오는 2억명이 넘는 사용자(Node)가 100억건의 관계(Edge)를 맺고있으며, 매일 5000만건의 관계(Edge)가 변화하고, 또 매일 30억건이 넘는 활동을 처리하기위해 자체적인 그래프 데이터베이스(S2Graph)를 개발해 사용하고있다.
그 밖에도, 인스타그램은 초창기 PostgreSQL을 사용하다가 서비스의 규모가 엄청나게 성장하면서 그래프 데이터베이스로 노선을 바꿨다. 그리고, Amazon의 Neptune, Neo4j 등 다양한 그래프 데이터베이스가 개발되고 있다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.