codestates / codestates/ds-blog
[최근후] Section 4 딥러닝 개념 정리 및 마인드맵
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
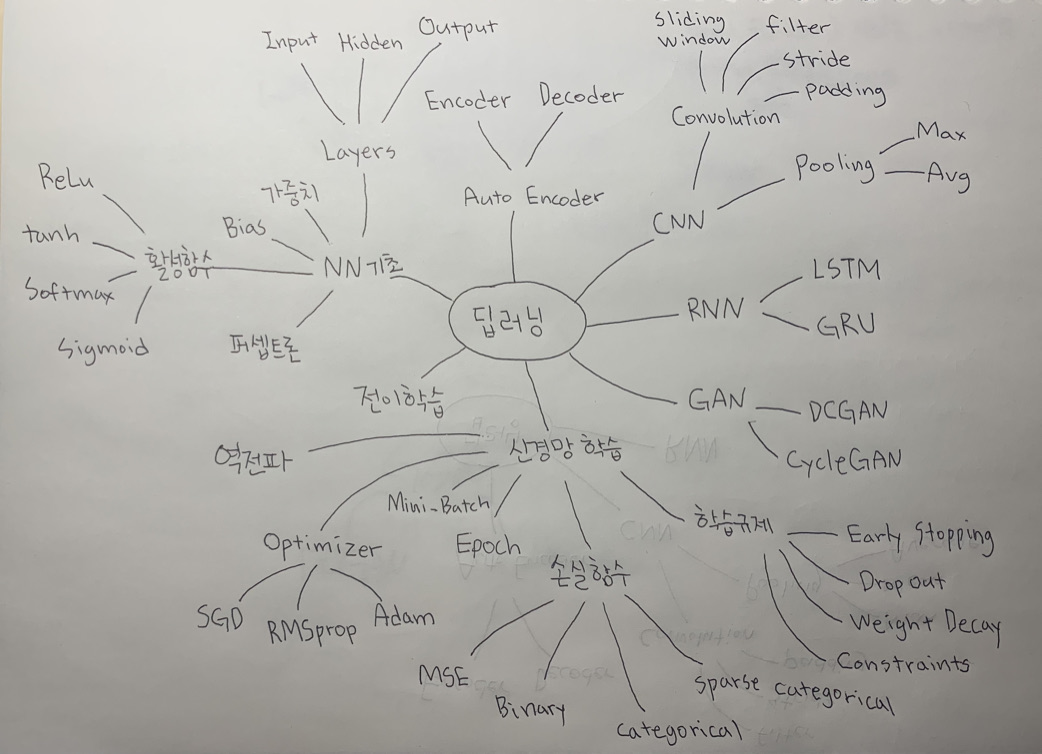
# NN 기초
- Layers
- Input Layer (입력층) : 입력층은 그 중 첫번째 노드로, 말 그대로 신호를 입력받고 다음 노드로 전달하는 역할을 한다. 입력층 노드를 제외한 그 다음 노드들은 활성화 함수를 사용한다. 즉, 입력층에선 계산을 수행하지않고, 신경망의 층수를 계산할 때 제외된다.
- Hidden Layer (은닉층) : 입력층과 출력층과는 다르게, 은닉층의 계산은 사용자가 보이지 않게 내부적으로 돌아가서 '은닉'층이라 불린다. 신경망은 은닉층의 갯수에 따라 다르게 불리는데, 은닉층이 없으면 단층 신경망, 하나가 있으면 다층 신경망, 여러개일 경우엔 심층 신경망이라고 불린다(딥 러닝).
- Output Layer (출력층) : 신경망 마지막 노드이고, 활성함수가 적용된다. 활성함수는 타겟에 따라 달라야한다.
- Weight (가중치) : 신경망의 노드들은 가중치로 연결되어 있다. 가중치는 입력값들을 다른 노드들로 전달할 때(결과값을 출력할 때) 각자 다른 비중을 두어 변화시키기 위한 것이다.
- Bias (편향) : 가중합 후에 더해지는 값이다. 가중치와 같이, 편향도 활성화에 영향을 미치는 값이다.
- Activation Function (활성함수) : 입력값을 다음층의 노드로 전달할지말지 결정하는 함수. 은닉층과 출력층에서 쓰인다.
- Sigmoid : 이진분류문제에 쓰이며, 0~1 사이의 값을 출력하는 S자형 함수.
- Tanh : 시그모이드를 재활용하여 만들어진 함수로, -1~1 사이의 값을 출력하는 함수.
- ReLU : x 값이 0보다 작을때는 0을, 0보다 클때는 기울기가 1인함수.
- Softmax : 다중분류문제에 쓰이며, 총 합이 1 이 되도록 0~1 사이의 값을 출력한다.
- Perceptron : 퍼셉트론은 실제 신경세포 뉴런을 모사하는 인공신경망이다. 이것은 여러개의 신호를 입력받아 하나의 신호를 출력한다. 퍼셉트론에서의 뉴런은 전달받은 입력값에 가중치를 곱하고 모두 더하는 계산을 하고, 활성화 함수를 사용해 그 결과를 출력함.
# 신경망 학습
- 역전파 : 예측값과 실제값의 오차가 최소가 되도록 가중치를 업데이트하기위한 방법이다. 역전파 알고리즘은 출력층 -> 은닉층 -> 입력층 방향으로 거꾸로 거슬러 올라가며 경사하강법을 사용하여 가중치를 업데이트한다.
- Mini-Batch : 모델의 가중치를 한번 업데이트시킬 때 사용되는 샘플들의 묶음을 의미한다. 10000개의 훈련 샘플이 있을때, 배치 사이즈를 100으로 설정했다면 100개의 샘플 단위마다 모델의 가중치를 한번씩 업데이트한다. 결과적으로 총 100번(10000/100) 가중치가 업데이트된다.
- Epoch: 학습의 횟수를 의미합니다. 10000개의 훈련 샘플이 있을때, 만약 Epoch 가 5이고 Mini-Batch 사이즈가 100 이라면, 가중치를 100번 업데이트하는 것을 총 5번 반복한다. 결과적으로, 가중치가 총 500번 업데이트된다. 이 값이 너무 낮으면 과소적합, 너무 높으면 과적합이 유발될 수 있다.
- Optimizer
- SGD : GD 는 학습의 반복을 통해 cost 함수 그래프에서 최소값을 찾는 것이다. 그러기 위해서 미분값을 구해 손실함수 그래프의 기울기를 찾고 이것이 0이 되는값을 찾는다. 경사하강법 에서는 학습률를 중요하게 생각해야하는데, 이것이 너무 작을땐 탐색시간이 한참걸릴수도 있고, 너무 클땐 최소 손실값을 잘못 찾을수도 있기에 (전역 최솟값을 건너뛰고 지역 최솟값을 찾는 문제) 비교적 비효율적이다. 그래서 SGD는 GD 와 다르게, 한번 학습할 때 모든 데이터에 대해 가중치를 조절하는 것이 아니라, 랜덤하게 추출한 일부 데이터에 대해 가중치를 조절한다.
- RMSprop : RMSprop 를 알기위해선 AdaGrad 를 먼저 알아야한다. AdaGrad 은 학습률을 변수들에 다르게 적용하는 방법이다. 변화가 많았던 변수들엔 학습률을 작게하고, 그렇지 않은 변수들엔 크게 하는것이다. 많은 변화가 있었다는 것은 최적값에 가깝다는 뜻이니 학습률을 작게해서 세밀하게 조정하기 위함이다. 하지만, AdaGrad 로인해 너무 극단적으로 학습률이 작아질때 생기는 학습이 멈추는 문제가 있었는데 이것을 보완한 것이 RMSprop 이다.
- Adam : Adam 을 알기위해선 먼저 Momentum 과 RMSprop 을 먼저 알아야한다. 그 이유는 Adam 이 그 둘을 섞어놓은 것이기 때문이다. RMSprop 은 위에 설명했으니 Momentum 을 설명하자면, Momentum 은 GD 의 학습률로 인한 문제를 기울기의 정도에따라 관성을 적용함으로써 완화한 것이다. Adam 은 Momentum 과 RMSprop 이 가지는 장점을 동시에 가지는 컨셉으로 생겨났다.
- 손실함수
- BinaryCrossentropy : 실제 레이블과 예측 레이블 간의 교차 엔트로피 손실을 계산한다. 이진분류에 쓰이는 손실함수. 값이 0에 가까울수록 좋음.
- CategoricalCrossentropy : BinaryCrossentropy 와 비슷하지만, 다중분류에 쓰인다는 점에서 약간 다름. 값이 0에 가까울수록 좋음. softmax 와 자주 연계됨.
- SparseCategoricalCrossentropy : CategoricalCrossentropy 와 비슷하지만, 레이블이 int 형이라는 점에서 다르다.
- MeanSquaredError : 예측한 값과 실제 값 사이의 평균 제곱 오차.
- 학습 규제 (Overfitting 을 방지하기위한 방법들)
- Early Stopping : 학습을 진행하며 더 이상 성능개선의 여지가 없을 때 학습을 종료시키는 콜백함수이다.
- Dropout : 확률적으로 노드 연결을 강제로 끊어주는 역할을 한다. 해당 뉴런없이 학습을 진행하기 때문에 과적합을 어느정도 차단할 수 있다.
- Weight Decay : Regularization의 한 종류로, 가중치를 감소시키는 기술이다. 애초에 큰 가중치를 갖지 못하게 만들어 과대적합이 될 수가 없도록 한다.
- Constraints : 물리적으로 Weight 의 크기를 제한하는 방법. 설정한 값 이상으로 Weight 가 커지지 않게한다.
# CNN
- Convoulution
- Filter: Kernel 이라고도 불리며, 가중치의 집합으로 이루어져 가장 작은 특징을 잡아내는 창. 지정된 간격(Stride)만큼 이동하면서 입력데이터와 합성곱하여 피쳐맵을 만든다.
- Stride: 필터(filter)를 얼만큼씩 움직이며 이미지를 볼 지 결정하는 수.
- Padding: Filter 와 Stride 로인해, 피쳐맵의 크기는 입력데이터 보다 작아지는데, 이것을 방지하는 방법이 패딩이다. 패딩은 데이터의 테두리에 지정된만큼 특정 값으로 채워 넣는 것을 의미한다.
- Pooling
- 풀링 레이어를 사용하여 피처맵의 차원을 줄인다. 보통 컨볼루션을 적용한 이후 레이어를 풀링하여 점점 더 작은 피쳐맵를 얻는다.
# 전이학습
- 이전에 어떤 목적을 가지고 학습된 모델을 비슷한 문제유형에 재사용 하는 것. 학습 데이터가 부족할때 용이하게 사용될 수 있다.
# RNN
- RNN : 피드포워드(Feed Forward) 신경망은 시계열 데이터의 패턴을 잡아내지 못하는데, RNN 에선 은닉층의 결과가 다시 은닉층의 입력으로 들어가도록 연결되어 있어서 시계열 데이터를 다루는 데에 좋은 성능을 낸다. 예를들어, 주가데이터, 음성데이터, 텍스트데이터 같이 앞 뒤 데이터간의 연관성이 있는 데이터셋에 사용될 수 있다.
- LSTM : RNN 은 관련 정보와 그 정보를 사용하는 지점 사이 거리가 멀 경우 역전파시 gradient 가 점차 줄어 학습능력이 크게 저하되는 vanishing gradient problem 이 있는데, 이러한 점을 극복하고자 RNN에 Gate를 추가한 모델이 LSTM 이다. Gate 종류로는, forget, input, output gate가 있다. LSTM 을 사용하면 이러한 게이트들로인해 최근 이벤트에 더 많은 비중을 둘수도 있으면서 동시에 오래된 정보를 완전히 잃지 않을 수 있다는 장점이 있다.
- GRU : LSTM 과 비슷하게, RNN 의 문제점 (vanishing gradient problem) 을 극복하기위해 만들어진 모델. LSTM 의 많고 복잡한 게이트를 간소화했다는 점에서 차이가 있다. forget 과 input 게이트는 합쳐지고 output 게이트는 없는 형태.
# Autoencoder
오토인코더는 출력을 입력처럼 만들도록 훈련 된 신경망이고, encoder와 decoder로 구성되어 있다. 오토인코더는 Input 데이터와 Decoder 의 출력으로 나온 Output 의 차이로 loss 를 구하고 가중치를 학습시킨다. 잘 학습된 가중치는 입력 데이터의 특징을 잘 표현하는 Latent 를 뽑아낼 수 있게된다.
- Encoder : 입력 데이터의 특징을 담고있는 Latent 로 데이터를 압축시키는 단계.
- Decoder : 압축된 Latent 를 입력데이터와 유사하게 출력하기위해 확장하는 단계.
- 오토인코더의 용도
- 노이즈를 제거하는 용도
- 재구성을 통한 이상값을 찾아내는 용도
- 특성을 추출하는 용도
# GAN
- DCGAN : GAN은 Generative Adversarial Network 의 약자이고, 이 이름이 말해주듯 이것은 생성(Generation) 모델이다. GAN 의 목적은 이 세상에 있을법한 가짜 이미지를 만들어내는 것이다. GAN 의 컨셉은 가짜 이미지를 만들어내는 생성자 (Generator) 를 학습시키기위해 뛰어난 감별자 (Discriminator) 를 적대적으로 (Adversarial) 사용하는 것이다.
- CycleGAN : CycleGAN 의 목적은 '한 도메인에 있는 이미지를 다른 도메인으로 해석한다'는 것이다. 즉, 이미지의 스타일을 바꾸되, 다시 원본 이미지로 복구 가능한 정도로만 바꾸는 것이다. CycleGAN 은 이미지 스타일을 변경/복구할 수 있도록 하는 2개의 생성자를 학습시키고, 2개의 감별자를 두어 그 생성자와 적대적으로 학습시킨다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.