codestates / codestates/ds-blog
[이재우] Section 4 Blogging
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
# MindMap
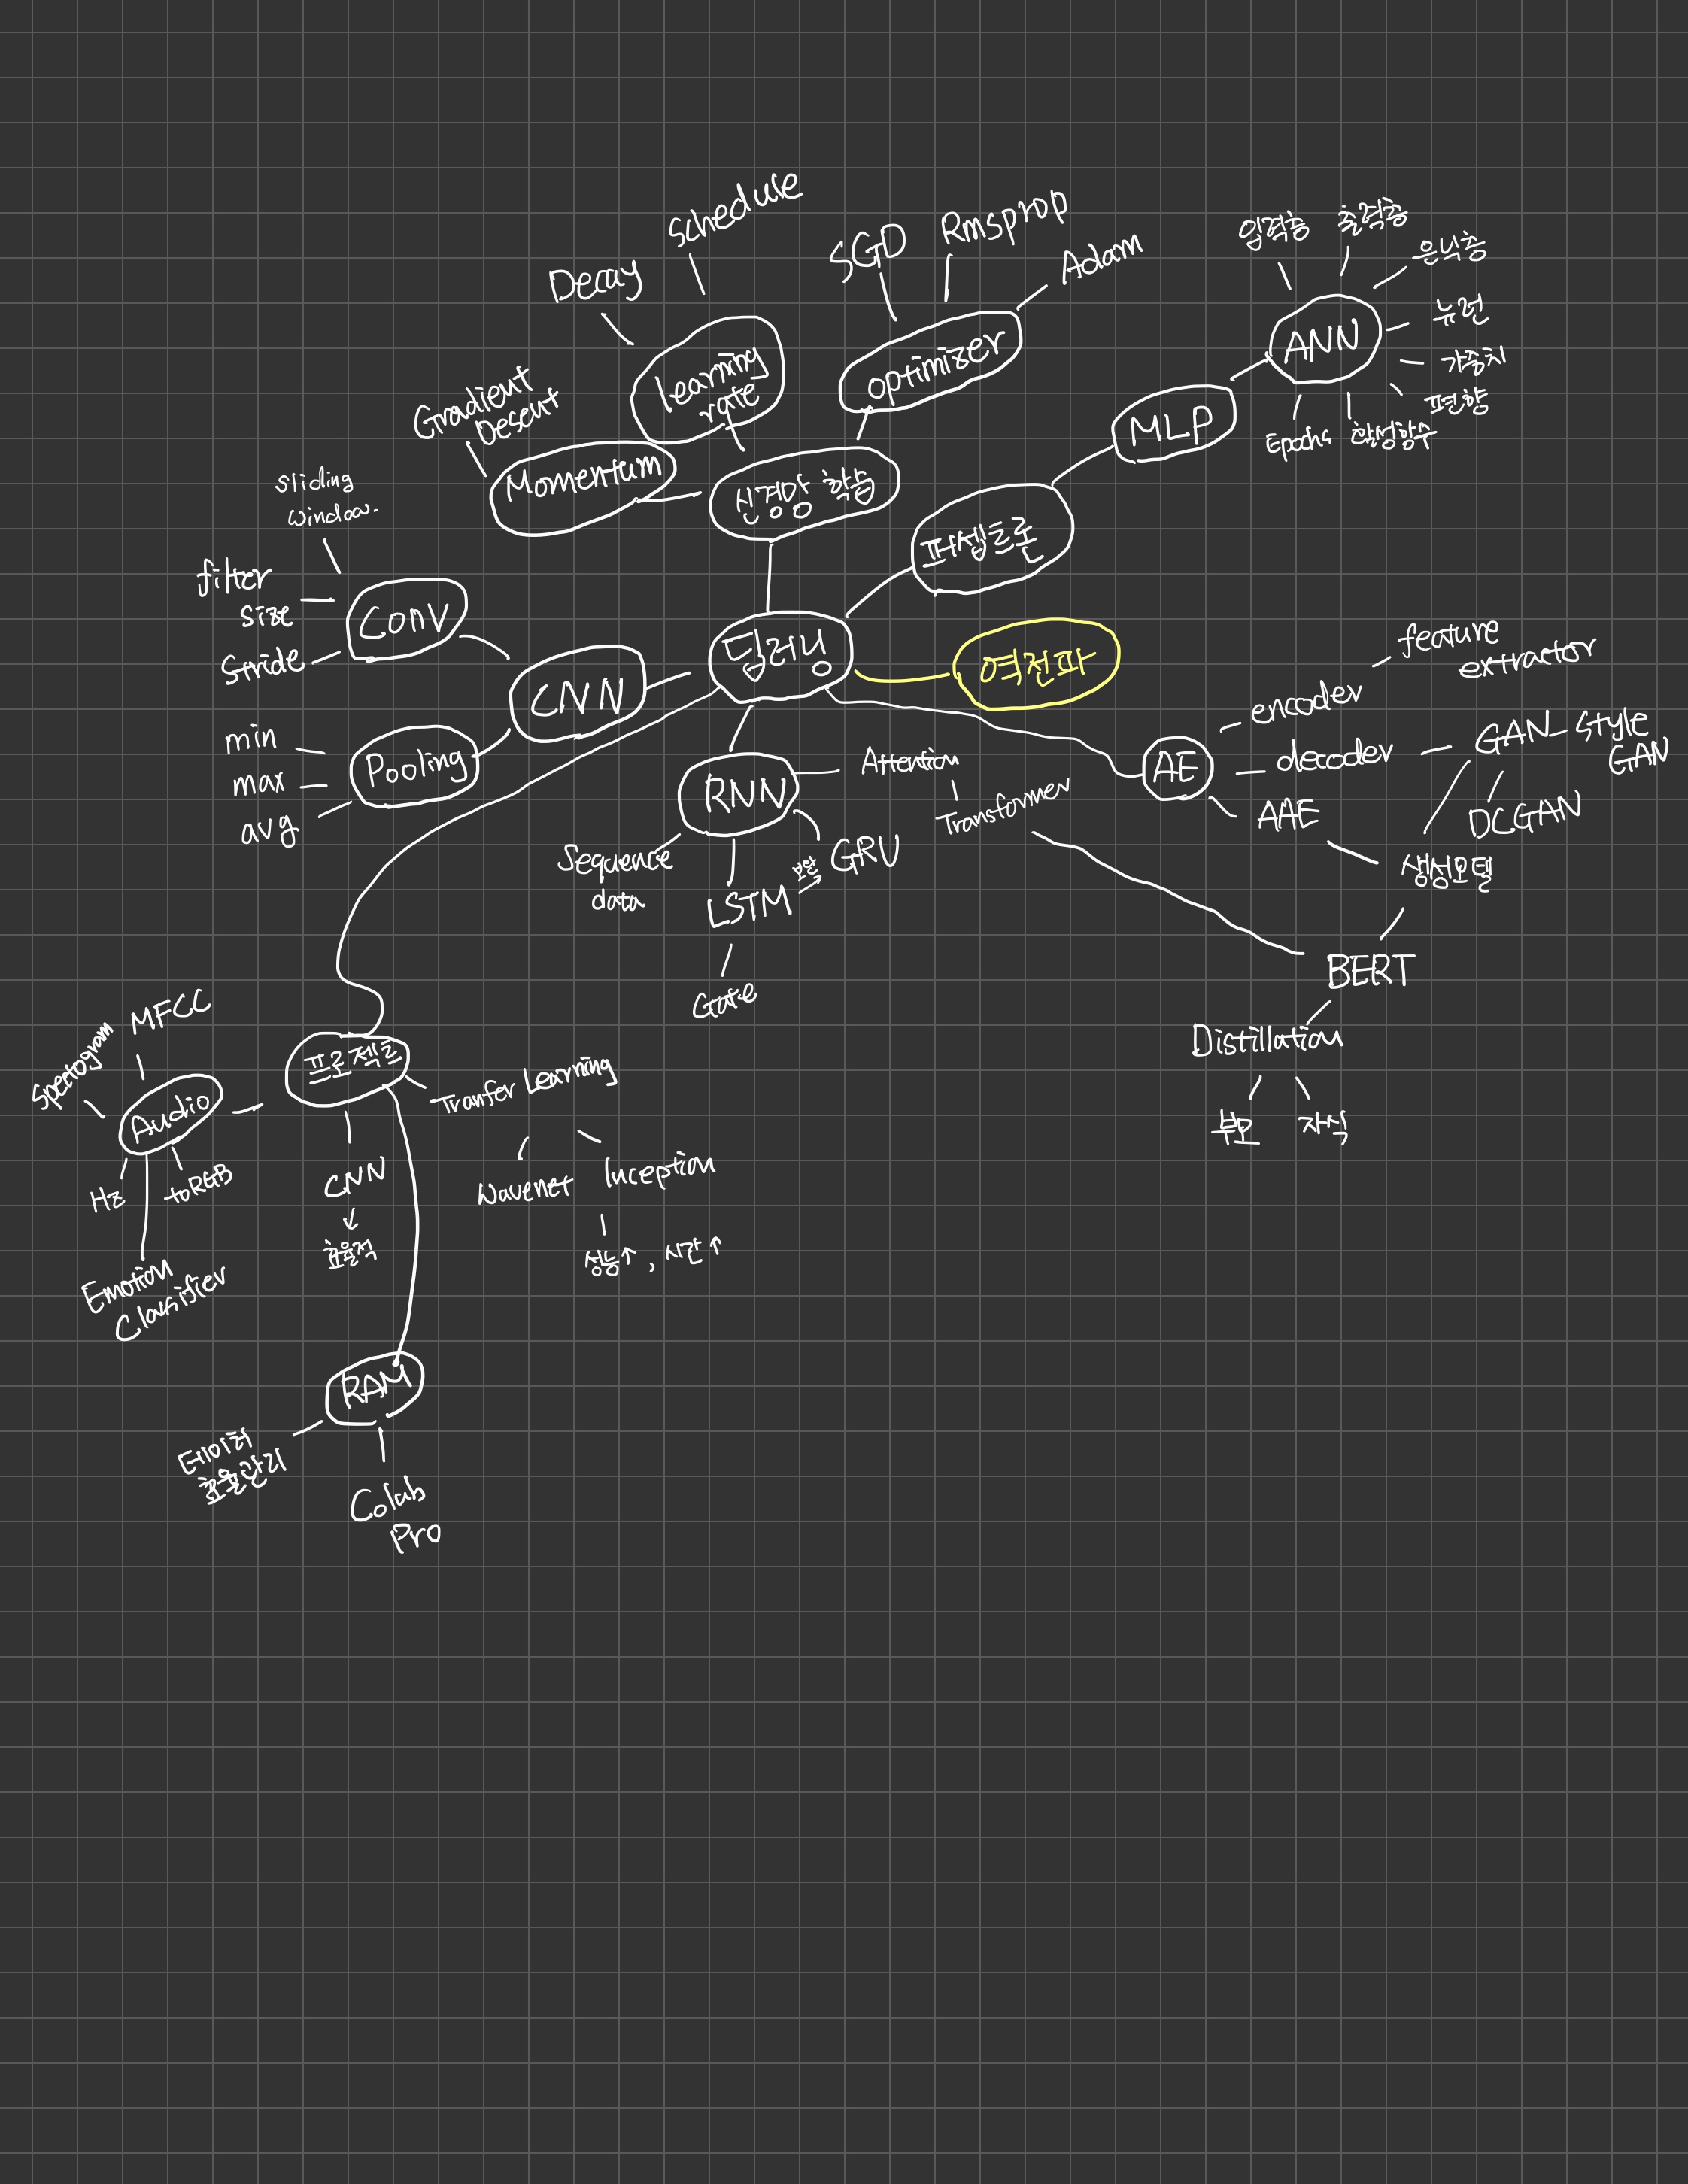
# 신경망 기초
- Input Layer:
> 입력층이라고 불리며, 신경망의 첫번째 층으로서 입력 데이터를 수신합니다. 노드의 갯수는 데이터의 크기를 바탕으로 결정이 된다.
- Hidden Layer:
> 은닉층이라고 불리며, 신경망에서 입력층과 출력층 사이에 위치하고 입력층과 출력층과 달리 여러겹으로 쌓을 수 있다. 그리고, 다양한 입력 값의 가중치와 편향에 대한 합을 활성화 함수를 적용하는 계산이 이루어진다.
- Output Layer:
>출력층으로 불리며, 신경망의 최종 레이어이다. 입력층을 통해 받은 데이터의 입력값으로 은닉층을 통과하며 계산된 값을 마지막 출력층의 활성함수를 거쳐 최종 결과를 확인할 수 있는 층이다.
- Neuron:
> 신경망에서 노드와 같으며, 여러개의 입력값을 받아 하나의 출력 값을 생성한다. 노드와 같이 입력 값의 가중 합에 활성함수를 적용하여 출력 값을 계산한다.
- Weight:
> 가중치로 해석되며 신경망에서 특성의 계수로 볼 수 있고, 일종의 필터역할을 하게 된다. 신경망의 최종 학습의 목표는 각 특성의 가장 이상적인 가중치를 결정하는 것이다. 가중치의 값은 0이 될 수 있고, 이는 모델에서의 영향을 완전히 배제하는것과 같은 뜻을 의미한다.
- Bias:
> 편향으로 해석되며 신경망에서 절편으로 볼 수 있고, 각 노드들의 특징을 나타낸다고 생각할 수 있다. 편향을 가중치의 하나의 값으로 생각할 수 있다.
- Activation Function:
> 활성함수로 해석되며, 이전 레이어의 모든 입력 값에 대한 가중 합을 취한 후 활성함수를 적용하여 값을 생성한다. 가장 일반적으로 사용되는 활성함수의 종류는 relu, sigmoid, tanh, softmax 함수가 있다.
- Node Map:
> 뉴런 구조도는 노드(뉴런)들의 구성과 각 층에 대한 구성과 그 연결관계를 그래프로 표현한 것이다. 시각적으로 비교적 간단하게 입력층과 은닉층, 출력층의 노드 갯수와 총 층의 갯수, 가중치의 연결고리등 신경망 모델을 대략적으로 볼 수 있다.
- Perceptron:
> 가장 초기 형태의 신경망이며 다수의 입력 값을 받아 하나의 출력 값을 내보내는 알고리즘이다. 단층 퍼셉트론(Single-Layer Perceptron)과 같이 오직 입력층과 출력층으로 구성되어 있다. 그리고, 다층 퍼셉트론(Multi-Layer Perceptron)과 같이 입력층과 출력층 사이에 은닉층을 추가되어 구성되어 있다.
- Epoch :
> Epoch를 그대로 번역하면 한 시대를 뜻한다. 한 Epoch란 훈련 데이터셋에 포함되어 있는 모든 데이터값들이 각각 한번씩 예측 모델에 들어온 뒤 weight 값을 갱신하는 주기를 의미한다.
# 역전파
[역전파.pptx](https://github.com/codestates/ds-blog/files/5818138/default.pptx)
# 신경망 학습
- Optimizer :
> Optimizer는 Neural Networks의 Loss를 최소화 하는 목적으로 가중치를 업데이트 하는 알고리즘 또는 방법이다.
1. SGD
> update parameters in the negative gradient direction to
2. Adam
> exponentially decaying average of past gradients
3. Rmsprop
> using a moving average of the squared gradient
- Learning Rate :
> 학습의 몇 퍼센트를 가중치 업데이트에 적용할지 말해주는 파라미터
- Momentum :
> 이전의 Gradient를 버리지 않고, 활용하는 방법
- Batch :
> Mini-batch의 줄임말으로, 데이터 전체를 한 번에 학습시키는 것이아닌 조금씩 분할하여 학습이 진행된다.
Batch의 크기가 작을 수 록 더 일반화가 잘된다는 말이 있다. 이는 왜냐하면 좀 더 완만한 Minimum을 찾기 때문이다.
# CNN
1. Conv
> 데이터 크기가 크거나, 히든층의 node수가 엄청나게 클 경우 학습되어야 하는 parameter의 갯수가 기하급수적으로 늘어난다. 이를 보완하기 위하여, 특정 filter size를 가지고 데이터의 특징을 추출하고 stride 만큼 이동하여 다시 특징을 추출한다, 이렇게 sliding window 처럼 모든 데이터를 sliding 하여 특징을 추출하여 하나로 합치게 된다.
2. Pooling
> Conv layer를 통과한 데이터를 Pooling 할 수 있게 해준다. Pooling의 방법으로는 min, max avg등이 있으며, 정해진 filter에서 min의 값 또는 max의 값 또는 평균의 값을 추출한다.
# RNN
> 순서가 중요한 즉, sequential 데이터를 다루기 위해 개발된 모델로서 이 전 학습을 반영하여 새로운 학습을 하게 된다.
1. LSTM
> Gate의 개념 input gate, forget gate, output gate를 도입하여, 가중치의 값들이 0으로 수렴하고나 무한대로 발산하는것을 보완한 모델이라고 볼 수 있다.
2. GRU
> 복잡한 LSTM의 모델에서 output gate를 제거한 모델이다. 새롭운 gate controller를 통해서 input gate와 forget gate를 조정한다.
3. Attention :
> Sequential 데이터를 하나하나 토큰화를 진행하여 하나의 토큰씩 학습이 되어지는 것이 아닌, Multi-maksed attention layer를 통해서 한 번에 학습이 진행된다.
4. BERT :
> 구글에서 개발한 언어 Transformer 모델로, 현재 가장 최신의 기술이다.
5. Distillation BERT:
> 선생 모델을 BERT로 하고, 이를 따라하도록 학습이 되어지는 모델이다. 학습되어져야 하는 파라미터의 갯수가 현저히 작기 때문에, 효율적이나 조금의 성능 저하는 존재한다.
# AE
> 가장 단순하게 원래 데이터를 잘 압축하여서, 잘 복원하도록 하는 모델이다. 그렇기 때문에 잘 압축하는 Encoder와 잘 복원하는 Decoder로 구성되어 있다. Encder는 압축이 되더라도 원 데이터의 특징을 잘 보존하도록 학습이된다. Encoder와 Decoder는 가중치를 공유한다.
1. AAE :
> AE를 생성모델로 활용한 모델이다.
# GAN
> GAN은 Generative Adversarial Networks로 말 그대로 genrative model인데 대립되는 네트워크로 구성되어 있다 볼 수 있습니다. 대립되는 네트워크로는 Generator, Discriminator로 나뉠 수 있습니다. Generator는 임의의 random latent variable을 통해서 이미지를 잘 생성하도록, Discriminator는 Generator를 통해서 생성된 이미지를 실제 이미지의 여부를 판별하는 네트워크입니다. 서로 가중치를 공유하면서, Generator는 더 좋은 latent variable을 찾아서 좋은 이미지를 만들 수 있도록, discriminator는 generator를 통해 생성된 이미지를 더 잘 판별할 수 있도록 서로 대립되는 역할이지만 윈윈이 되도록 학습이 되어져 최종적으로 좋은 이미지를 만드는 모델입니다
1. Cycle GAN:
> 사이클 GAN은 GAN과 마찬가지로 생성모델입니다. 모델은 총 2개의 Generator와 1개의 Discriminator로 구성되어 있습니다. 첫번째 generator는 입력 이미지를 원하는 이미지의 특성을 가지도록 생성하고, 실제 이미지와 discriminator를 통해서 진위여부를 판별 합니다. 마지막 하나의 generator는 첫번째 generator를 통해서 변형된 이미지를 다시 원본으로 복원생성을 도와줍니다. 따라서 첫번째 generator를 통해서 목표하는 특성이미지를 잘 입히도록 그리고 두번째 generator를 통해서 원본을 파괴하지 않도록 하여 최종적으로 원본 데이터를 잘 유지하면서 원하는 특성을 입힌 이미지를 잘 만드는것입니다.
# Project
- Audio:
> 오디오의 특징을 보여주는 Spectogram과 MFCC를 활용하여 모델에 학습시켜 특징을 추출할 수 있도록 한다.
전이 학습을 위해서는 Audio to RGB 형태로 바꾸어 주어야 할 때가 존재한다.
- CNN:
> 감정분석과 같이 간단한 오디오 데이터 분류문제에서는 그리고 데이터가 잘 전처리가 되어있는 좋은 품질의 사운드 데이터에서는 CNN을 통해서도 충분히 특징을 찾아 낼 수 있고, 더욱 효과적으로 학습이 가능하다.
- Transfer Learing:
> 최신 기술의 Encoder 부분을 활용하기 때문에 feature extractor로서 역할은 월등히 좋다. 하지만, 그 만큼 deep한 neural network를 가지고 있기 때문에 효율적이지는 못하나, 확실히 좋은 성능을 기대할 수 있다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.