codestates / codestates/ds-blog
[이재우] Solo project 4
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
# 오디오 감정분류에서 CNN 모델의 성능과 전이 학습의 성능 비교
최근 가장 활발한 딥러닝 분야중의 하나는 음성관련 데이터를 다루는 것이다. 음성 데이터 관련해서는 현재까지 계속 발전을 해오고 있고, 아직 미지의 분야가 많이 존재한다. 이번 프로젝트를 통해서 그 미지의 분야에 한 걸음 가깝게 갈 수 있으면 좋겠다. 그래서 선택한 주제는 오디오 감정 분류 문제이다. 오디오 데이터를 처음 다루는 입장에서 가장 기본적인 모델로 내가 제시한 문제를 스스로 해결하는 방향과 결론을 해석하는 과정을 보여주는것이 목적이다. 오디오 감정 분류 문제에서 가장 많은 예시 모델중의 하나는 CNN 모델이다. 하지만 전이학습을 사용한 예는 CNN 모델에 비해 많이 있지 않다. 이를 통해서 왜 사람들은 성능의 개선이 있는 최신 모델을 활용 할 수 있는 전이학습을 사용하지 않는걸까? 더 좋은 성능을 위해서, 잘 알려진 pre-trained 된 모델([Wavenet](https://deepmind.com/blog/article/wavenet-generative-model-raw-audio), [InceptionResNetV2](https://arxiv.org/abs/1602.07261))을 사용하면 성능 상승을 기대해 볼 수 있지 않을까? 그래서, 이번 프로젝트에서는 CNN 모델과 pre-trained InceptionResnetV2의 성능 비교를 해보자.
# 모델
## 1. CNN
캐글에서 정말 많은 CNN 모델의 예시중에서, 가장 [The best CNN model](https://www.kaggle.com/ejlok1/audio-emotion-part-3-baseline-model)을 베이스 라인 모델로 설정하였다. 그렇기 때문에 모델을 가져와 사용하였다. 간단히 총 11개의 층으로 이루어져 있다. 사용한 optimizer는 RMsprop이다.
## 2. InceptionResNetV2
전이 학습을 통해서, the InceptionResNetV2 model의 Encoder 부분을 가져와 사용하였다. InceptionResNetV2 모델의 default 인풋 데이터 사이즈는 (299, 299, 3) 이다. 따라서 오디오 파일을 RGB 이미지 형식으로 바꿔주어야 한다, 빨간색을 spectrogram, 초록색을 scalogram, 파란색을 MFCC(Mel-frequency Cepstral Frequency)로 하였다.
# Dataset
데이터셋은 [Kaggle](https://www.kaggle.com/uwrfkaggler/ravdess-emotional-speech-audio) 에서 다운로드 하였다. 베이스라인 모델에서는 총 [4개의 음성 데이터](https://www.kaggle.com/ejlok1/audio-emotion-part-1-explore-data)를 사용하여 학습하였고, InceptionResNetv2에서는 코랩 GPU 램 제한으로 인해 RAVDESS만 사용하였다. 감정의 종류는 다음과 같다.
1. anger
2. disgust
3. fear
4. happiness
5. neutral
6. sadness
7. surprise
1. Surrey Audio-Visual Expressed Emotion (SAVEE)
> University of Surrey의 4명의 남자학생의 7가지 감정의 오디오 파일이며, 특이점으로 여자의 오디오 파일이 없다.
2. Ryerson Audio-Visual Database of Emotional Speech and Song (RAVDESS)
> 24명의 전문 배우의 7가지 감정의 오디오 파일이고, 12명의 남자 12명의 여자로 고르게 분포 되어있다. 특이점으로 각 감정의 표현 강도가 두가지로 보통과 강함으로 나뉘어진다.
3. Toronto emotional speech set (TESS)
> 두명의 서로다른 나이대의 여자배우의 7가지 감정 오디오 파일을 담고 있다. 특이점으로 pleasant surprise가 존재하는데, 다른 데이터와의 통일성을 위해 모든 데이터셋에서 surprise는 pleasant surprise로 가정하였다.
4. Crowd-sourced Emotional Multimodal Actors Dataset (CREMA-D)
> 48명 남자 배우와, 43명 여자 배우의 6가지 감정의 오디오 파일이다. 특이점으로 surprise의 감정이 존재 하지 않는다.
4가지 데이터를 모두 합침으로서, 남자와 여자의 비유을 맞추도록 하였다. 하지만, surprise 예측 분류는 좋은 성능이 나오지 않을 수 있다. 그럴 경우, 가정을 수정하도록 한다.
Example
------------------------------------
1. Gender - Female, Emotion - Angry


> 잡음 없이 좋은 품질의 오디오 데이터 이다.
2. Gender - Male, Emotion - Angry


> 마찬가지로 없이 좋은 품질의 오디오 데이터 이다.
두가지의 예시를 통해서 두가지 음성파일 모두 좋은 품질을 제공한다. Spectogram에서 음성에 의한 파동을 제외한 노이즈는 찾아 볼 수 없고, 두 감정간의 차이도 눈으로 쉽게 볼 수 있다.
# Result
|Model|Accuracy|Precision|Recall|F1|
|------|---|---|---|---|
|CNN|0.42|0.45|0.41|0.42|
|INCEPTION|0.47|0.49|0.45|0.43|
위의 표는 두가지 모델의 평가지표값을 보여준다. 단순히 수치만 비교를 해보았을 때, InceptionResNetV2가 더 좋아 보인다. 전반적으로 아주 조금 성능 상승을 확인 할 수 있다. 하지만, 무조건 InceptionResNetV2가 더 좋다라고 얘기할 수 있을까?
## 1. CNN Model
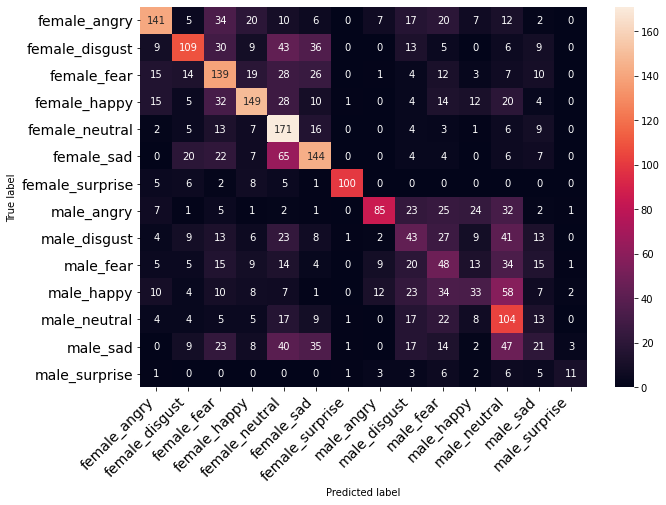
> Base-line model의 confusion matrix이다.
## 2. InceptionResNetV2

> InceptionResNetV2 모델의 confusion matrix이다.
# Conclusion
결과적으로, 코랩에서의 GPU RAM 제한에도 불구하고 InceptionResNetV2가 아주 더 좋은 성능을 보여주었다. 그렇다면 InceptionResNetV2가 더 좋은 모델인가? 먼저, 완전한 모델 비교를 위해서는 모든 다른 변수들을 제어해주어야 한다. 하지만, 이번 프로젝트에서는 그러지 못하였다. 그래서 비교를 돕기위해서 새로운 CNN 모델을 정의하였다. 이 모델은 InceptionResNetV2와 같이 동일한 데이터, 인풋 데이터 사이즈를 가진다. 그 성능은 아래와 같다.
|Model|Accuracy|Precision|Recall|F1|
|------|---|---|---|---|
|CNN(RGB Audio)|0.06|0.004|0.07|0.09|
3가지 모델의 총 성능을 비교하면, 먼저 새롭게 정의된 CNN 모델의 성능은 이상하리만큼 좋지않다. 하지만 잘 훈련이 되었다고 가정을 한다마녀, 이를 통해서 유추할 수 있는 결론은 InceptionResNetV2가 Encoder의 역할을 더 잘한다고 볼 수 있다.
그렇다고 해서 무조건 InceptionResNetV2가 CNN 보다 좋다라고 할 순 없다. InceptionResNetV2 엄청 깊은 신경망이기 때문에, 오디오 감정 분류 목적으로는 너무 과한 모델일 수 있다. 위의 성능을 보면 충분히 CNN 모델을 통해서 더 효율적으로 비슷하게 성능을 보여줄 수 있기 때문이다.
정리하면, 전이학습을 통해서 최신의 좋은 성능 모델을 가져와 사용하면 확실히 좋은 성능을 기대할 수 있다. 하지만, 많은 의문점을 야기 될 수 있다. 가장 먼저, 오디오 감정분류와 같이 단순한 분류문제에서 굳이 엄청나게 deep한 최신 모델을 가져와서 쓰는게 효율적인가? 단지 5%미만의 성능 개선을 위해서 많은 시간을 들일 필요가 있을까? 위 두가지 질문에 대한 답은 없다. 뭐가 더 좋고 나쁘다 말 할 수도 없다. 하지만 한가지 확실한 것은, 하고자 하는 목적을 이룰 수 있는 모델을 잘 선택할 필요가 있다는 것이다. 성능과 효율성 이 두가지 사이에서 목적에 부합하는 모델을 선택하는것이 좋은듯 하다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.