codestates / codestates/ds-blog
[윤현태]-solo project section4
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
# image classification과 image preprocessing의 상관관계에 대하여
## Intro
컴퓨터와 관련된 기술들이 급속하게 발전함에 따라, 우리는 전보다 더 다른 것들을 할 수 있게 되었습니다. 가장 대표적인 것이 A.I의 출현인데요, 저는 그 중에서도 컴퓨터 비전에 대해서 이야기 하고 싶습니다. 코로나 바이러스로 인한 언택트의 확산으로 인해, 굳이 보안구역이 아니더라도 비대면 상태에서 상황을 빠르게 파악하고자 하는 경우가 더 확대되고 있습니다.
예를 들자면, 도로 근처에 사람, 동물, 사물 등이 등장해 다양한 위험 상황이 발생할 수 있는데, 시간이나 날씨 등에 따라 배경이 변하는 등 외부요인이 많아 기존에 기계가 일괄적으로 판단하기 어려운 부분이 있습니다. 하지만, 카메라를 통해 얻어진 이미지를 딥러닝 소프트웨어에 학습시키면 다양한 광학 조건이나 달라지는 배경에도 쉽게 위험 요인을 자동으로 확인할 수 있게 됩니다. 이처럼 컴퓨터 비전에 대해 그 활용도와 관심이 높아지고 있고, 컴퓨터 비전을 발전시키는 것을 목표로 하는 회사들이 많이 있는데, 저는 그런 회사들 중에 저는 AI 스타트업 뉴로클에 관심이 있습니다. 이 회사의 주요 프로덕트는 pre-trained된 모델에 사용자가 이미지 데이터를 입력하기만 하면 손쉽게 이미지 분류를 시켜주는 Neuro-T & Neuro-RT이 있습니다.
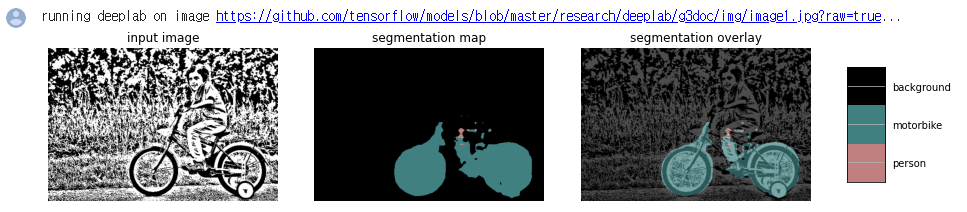
그리고 그런 이미지 분류를 위한 첫 단계가 이미지 전처리 단계인데, 저는 특정한 방법으로 전처리를 하면 이미지 분류 모델의 성능이 더 올라가지 않을까? 라는 궁금증이 생겼습니다.
## DATA 선정
이미지를 잘 분석하려면, 얼마나 이미지의 특징을 잘 잡아줄 수 있는지가 관건인데, 특징이 비슷한 오브잭트일 수록 아무래도 인공지능의 성능이 떨어지게 됩니다. Intel Image Classification(https://www.kaggle.com/puneet6060/intel-image-classification)은 그런 인공지능의 혼란을 잘 초래할 수 있게 만들어진 dataset으로, 산,바다,빙산,숲,거리 그리고 빌딩 총 6개의 카테고리로 이루어져 있습니다.
Train data set size: 9824 , val data set size: 4210 , test data set size:3000
## Model
autoencoder를 활용한 custom CNN 모델
전처리를 했을 때 데이터의 특징을 얼마나 잘 잡아내는지, 그리고 특징의 손실을 최대한 줄이기 위해 autoencoder의 encoder 부분을 사용했습니다.
```py
Model: "model_1"
__________________________________________________________________________________________________
Layer (type) Output Shape Param # Connected to
==================================================================================================
input_1 (InputLayer) (None, 150, 150, 3) 0
__________________________________________________________________________________________________
conv2d_1 (Conv2D) (None, 150, 150, 4) 112 input_1[0][0]
__________________________________________________________________________________________________
conv2d_2 (Conv2D) (None, 150, 150, 4) 52 input_1[0][0]
__________________________________________________________________________________________________
concatenate_1 (Concatenate) (None, 150, 150, 8) 0 conv2d_1[0][0]
conv2d_2[0][0]
__________________________________________________________________________________________________
max_pooling2d_1 (MaxPooling2D) (None, 75, 75, 8) 0 concatenate_1[0][0]
__________________________________________________________________________________________________
conv2d_3 (Conv2D) (None, 75, 75, 8) 584 max_pooling2d_1[0][0]
__________________________________________________________________________________________________
conv2d_4 (Conv2D) (None, 75, 75, 8) 264 max_pooling2d_1[0][0]
__________________________________________________________________________________________________
concatenate_2 (Concatenate) (None, 75, 75, 16) 0 conv2d_3[0][0]
conv2d_4[0][0]
__________________________________________________________________________________________________
max_pooling2d_2 (MaxPooling2D) (None, 38, 38, 16) 0 concatenate_2[0][0]
__________________________________________________________________________________________________
conv2d_5 (Conv2D) (None, 38, 38, 16) 2320 max_pooling2d_2[0][0]
__________________________________________________________________________________________________
conv2d_6 (Conv2D) (None, 38, 38, 16) 1040 max_pooling2d_2[0][0]
__________________________________________________________________________________________________
concatenate_3 (Concatenate) (None, 38, 38, 32) 0 conv2d_5[0][0]
conv2d_6[0][0]
__________________________________________________________________________________________________
max_pooling2d_3 (MaxPooling2D) (None, 19, 19, 32) 0 concatenate_3[0][0]
__________________________________________________________________________________________________
conv2d_7 (Conv2D) (None, 19, 19, 32) 9248 max_pooling2d_3[0][0]
__________________________________________________________________________________________________
conv2d_8 (Conv2D) (None, 19, 19, 32) 4128 max_pooling2d_3[0][0]
__________________________________________________________________________________________________
concatenate_4 (Concatenate) (None, 19, 19, 64) 0 conv2d_7[0][0]
conv2d_8[0][0]
__________________________________________________________________________________________________
max_pooling2d_4 (MaxPooling2D) (None, 10, 10, 64) 0 concatenate_4[0][0]
__________________________________________________________________________________________________
dense_1 (Dense) (None, 10, 10, 32) 2080 max_pooling2d_4[0][0]
__________________________________________________________________________________________________
flatten_1 (Flatten) (None, 3200) 0 dense_1[0][0]
__________________________________________________________________________________________________
dense_2 (Dense) (None, 64) 204864 flatten_1[0][0]
__________________________________________________________________________________________________
dense_3 (Dense) (None, 64) 4160 dense_2[0][0]
__________________________________________________________________________________________________
dense_4 (Dense) (None, 6) 390 dense_3[0][0]
==================================================================================================
Total params: 229,242
Trainable params: 229,242
Non-trainable params: 0
__________________________________________________________________________________________________
```
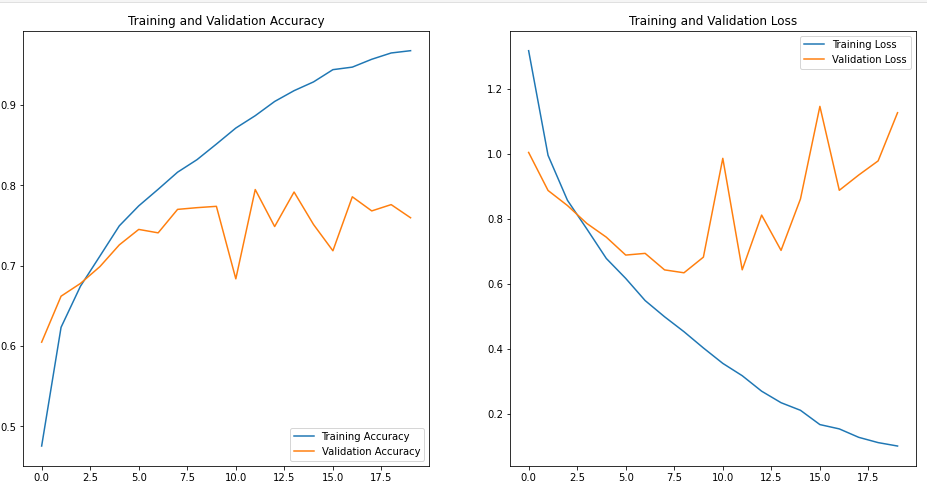
이중 가장 validtaion_loss가 낮은 모델을 baseline모델로 활용했습니다.
## 전처리 방법 설정
데이터 전처리는 다음과 같이 크게 두가지로 분류할 수 있습니다.
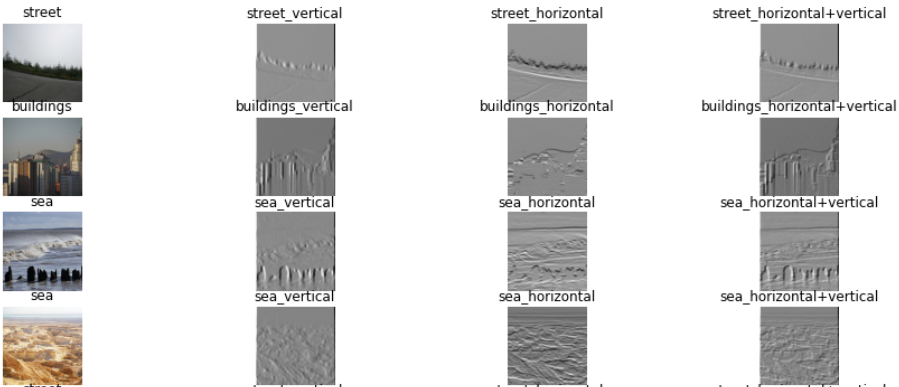
1) grayscale화 된 이미지의 수평, 수직 정보
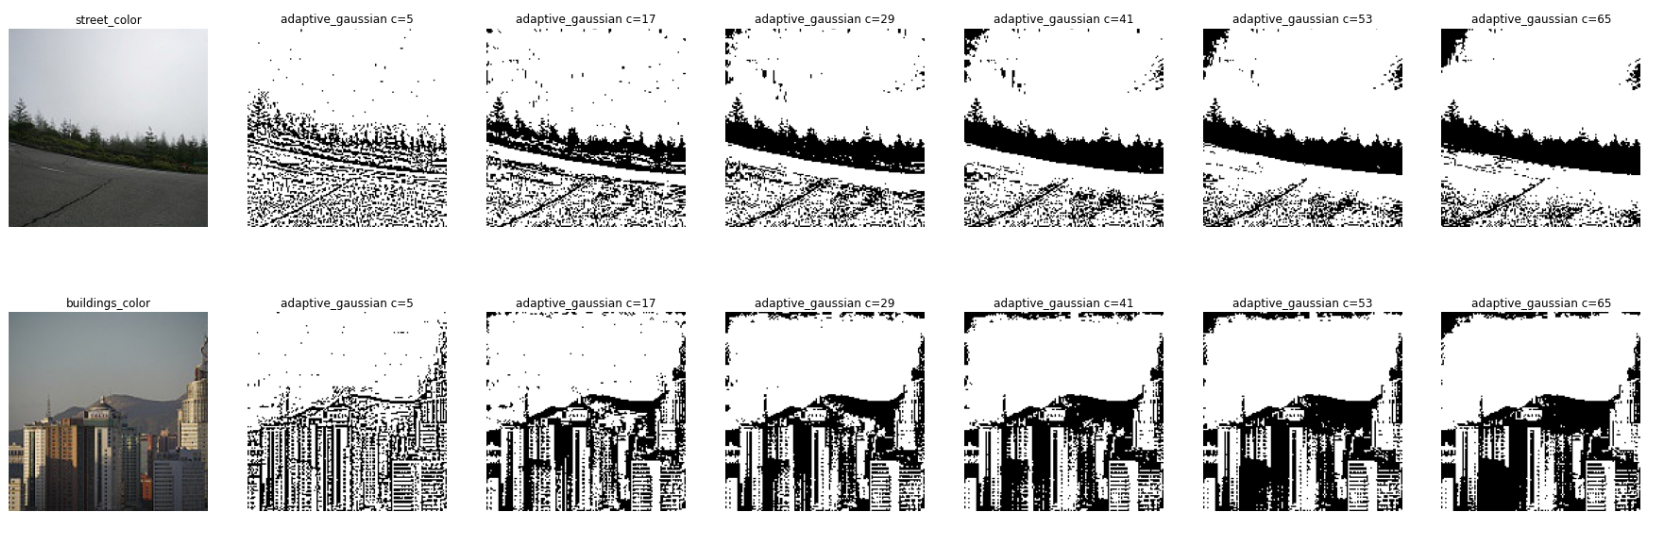
2)rgb to binay (adaptiveThreshold)
## TEST 결과 및 분석
Model | Test loss | Test accuracy
-- | -- | --
Baseline model | 0.634773359855016 | 0.7763333320617676
Horizontal feature only | 0.7999722092946371 | 0.7133333086967468
Vertical feature only | 0.7620102472305298 | 0.715666651725769
Grid feature only | 0.7611293346087138 | 0.7059999704360962
model_mean_5 | 0.7161927474339803 | 0.7239999771118164
model_mean_31 | 0.7718882913589478 | 0.7176666855812073
model_mean_65 | 0.7232322945594788 | 0.7316666841506958
model_gaussian_5 | 0.7058794659773509 | 0.7406666874885559
model_gaussian_31 | 0.7450712909698486 | 0.7326666712760925
model_gaussian_65 | 0.7812622388203939 | 0.7296666502952576
모델 테스트를 진행해본 결과, 개발자가 직접 특징을 지정해주면 학습을 더 잘할 거라는 예상과 달리, 아무런 처리도 하지 않고 원본 그대로 이미지 데이터를 넣은 Baseline model의 성능이 가장 좋았다.
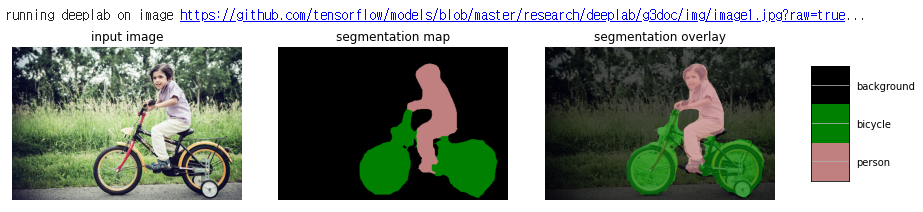
##Deep Residual Learning for Image Recognition
DRL을 사용한 모델에서도 개발자가 임의로 특징을 지정해주면 오히려 학습을 방해하는 결과가 나왔다.
##결론
이미지의 특징을 미리 추출해내는 전처리 방법은 생각보다 영향을 미치지 않았으며, 오히려 아무것도 처리하지 않았을 때 모델의 성능보다 더 떨어졌다. 위와 같은 기법들은 조금더 특수한 상황 (ex. contour)에서만 활용되어야 할 것이다.
##마치며
생각보다 이미지의 특징들을 미리 준비하는 것이 딥러닝 학습에 좋은 영향을 미치지 않는 것을 확인 했는데, 인간의 관점이 아니라 기계의 관점에서 봐야할 것 같다. 우리는 그런 식으로 특징을 잡았을 때 그게 뭔지 pre-trained 되서 잘 알지만, A.I는 처음부터 시작하기 때문에 특징만 추출하는 것은 오히려 정보의 왜곡이 될 수도 있다는 것을 알게 되었다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.