codestates / codestates/ds-blog
[김지연] section3 project "flask와 Spotify API를 이용한 음악 취향 예측 어플리케이션 만들기"
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
[github repository](https://github.com/kk00b/dsft_project03)
[web application](https://dsft-spotify-app.herokuapp.com/)
서론
---
누군가 나에게 취미를 물어볼 때마다 빠지지 않는 나의 대답은 음악 듣기이다. 어쩔 땐 재생목록을 한 곡 한 곡 골라서 만들어 들을 때도 있고 한 앨범을 처음부터 끝까지 통째로 듣기도 하고 아니면 스포티파이의 알고리즘이 추천해준 재생목록에 몸을 맡기기도 한다. 그리고 항상 새로운 음악과 아티스트를 갈구한다. 이미 알고 좋아하는 음악을 듣는 것도 꽤나 즐거운 일이지만 맘에 쏙 드는 새로운 아티스트나 음악을 찾으면 정말 짜릿하기 때문이다. 하지만 세상은 넓고 들을 음악은 많지만 나의 시간은 많지 않다. 이런 흔한 현대인의 고민을 안고 살아가다, 데이터 사이언스 부트캠프의 세 번째 프로젝트 예시로 주어진 스포티파이 API를 이용해 음악을 추천하는 어플리케이션 만들기가 내 마음 속에 들어왔다.
내가 좋아요 누른 아티스트들의 목록을 분석하여 내가 특정 아티스트를 좋아할지 예측하는 웹 어플리케이션을 만들기로 했다. 모델 성능이 충분하다면 사용자들이 재미삼아 어떤 아티스트를 좋아할지 여부를 예측해보는 재미난 어플리케이션이 될 수 있을 거라는 생각이 들었기 때문이다. 그래서 만든 웹 어플리케이션의 작동 원리는 내가 좋아하는 아티스트/싫어하는 아티스트의 가장 유명한 곡 하나의 특성을 분석한 것을 바탕으로 내가 어떠한 아티스트(정확히는 그 아티스트의 가장 유명한 곡 하나)를 좋아할지 말해준다. Spotify의 공개된 재생목록으로 좋아하는 노래와 싫어하는 노래 두 가지를 넣아 만든 재생목록의 id 혹은 제목을 넣으면 누구의 취향이든 분석할 수 있게끔 하는 것이 최종 목표이다.
하지만 웹 어플리케이션을 만들어 내기란 프로그래밍 초심자로서 쉬운 일이 아니었다. 그래서 이 블로그에 웹 어플리케이션을 만들며 고군분투한 나의 일대기를 포스팅하려고 한다. 그리고 이 포스트를 읽는 프로그래밍 초심자분들이 용기를 얻어 파이썬이든 어떤 언어로든 뭔가 만들어보고 코딩에서 재미를 찾으신다면 정말 기쁠 것 같다.
### 사용한 라이브러리
```python
import spotipy # Spotify API의 사용을 용이하게 해주는 멋진 라이브러리
import json # json 형식으로 바꿔주고 들여쓰기를 자동으로 해주는 유용한 파이썬 내장 모듈
import pandas as pd # 리스트나 딕셔너리를 데이터프레임으로 변환해주는 이젠 엑셀 보다 편한 것 같은 라이브러리
import pickle # 파이썬 코드를 바이너리 파일로 저장해주는 아직은 낯선 라이브러리
import sklearn # 회귀 분석을 하려면 꼭 필요한 라이브러리
import sqlalchemy # sql의 쿼리문 대신 파이썬 코드로 데이터베이스를 사용할 수 있게 해주는 멋진 다리와도 같은 라이브러리
import flask # 파이썬으로 간단하게 웹페이지를 만들 수 있게 해준다!
```
웹 어플리케이션 제작 과정
---
부트캠프에서 이번 프로젝트를 위해 만드는 웹 어플리케이션은 요구조건이 있다. 3개의 페이지, CRUD(Create, Read, Update, Delete) 기능, 리모트 DB 연결, 그리고 데이터를 이용한 분석이 포함되어야 한다. 이 요구조건들을 만족할 수 있는 웹 어플리케이션을 거의 나흘 만에 만들었어야 했기 때문에 이외의 기능은 따로 추가할 시간이 없었다. 그래서 웹 어플리케이션의 디자인이나 분석 기능은 추후에 업데이트 할 예정이다.
### 1. API와 라이브러리 사용법 익히기
이번에 웹 어플리케이션을 만들며 시간을 많이 들인 부분들이 있었다. 그 중 첫 번째는 Spotify API를 쉽게 사용할 수 있게 해주는 [Spotipy](https://spotipy.readthedocs.io/en/2.16.1/) 라는 라이브러리의 사용법을 익히고 API가 반환한 딕셔너리 값을 보고 필요한 내용을 찾는거였다. Spotipy의 깃헙 페이지를 보면 몇가지 사용 예를 확인할 수도 있고 문서도 꽤나 친절하게 써져 있었다. 하지만 반환된 값들을 확인하고 그걸 또 분석에 사용할 수 있게 문자열로 바꾸거나 리스트로 바꾸는 등의 일들이 나에게 좀 어려웠다. 그 이유는 굉장히 긴 딕셔너리 값을 반환하기 때문이다.
처음 그 사실을 몰랐던 나는 내가 좋아요한 곡들의 재생목록 중 100개의 곡을 한꺼번에 가져오는 실수를 저질러 버렸고
```python
results = sp.playlist_tracks(playlist_id, limit = 100)
print(results)
```
이 짧은 코드 두 줄이 가져온 딕셔너리들은 꽤나 길어서 터미널 화면에서 짤려서 보였으며 나는 터미널을 접한지 오래되지 않아 짤린 나머지 부분이 얼마나 길지 가늠도 할 수 없었다.
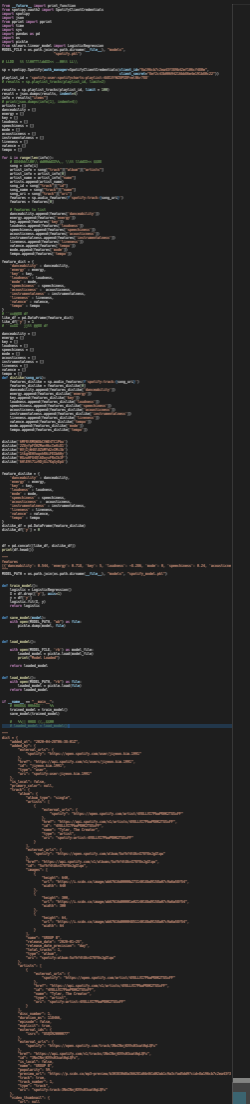
이 사진은 나의 재생목록을 가져와 Logistic Regression을 한 파이썬 코드인데 1/3정도(주황 부분)가 곡 하나를 불러오면 반환되는 딕셔너리이다.파이썬을 접한지 어언 3개월..이전에 접했던 딕셔너리들은 길어야 10줄 이었고 이런 중첩에 중첩에 중첩을 더한 긴 딕셔너리는 처음 봤다. 그래서
거북목이 되어가며 내가 필요한 아티스트id, 아티스트명, 트랙명 등이 어디 있는지 찾고 또 이 키들이 어느 딕셔너리에 또 들어가 있는지 확인하는게 정말 힘들었다. 거기다 처음 반환된 값을 봤을 땐 들여쓰기가 전혀 안되어있어서 json 모듈을 이용했다.
```python
json.dumps(results, indent=4)
```
이 간단한 코드는 나의 목과 안구를 구원해주었다. 들여쓰기를 설정할 수 있기 때문에 가독성이 훨씬 높아졌고 내가 찾는 것들이 딕셔너리의 어느 부분에 있는지 확인할 수 있었다. 또 vs code의 들여쓰기를 확인시켜주는 기능도 무척 도움이 되었다. 그래서 꽤나 오랜 시간을 들여 내가 원하는 아티스트id, 아티스트명, 트랙명 등을 찾아냈다. 그리고 분석을 위해 딕셔너리의 내용을 리스트로 바꾸는 등 뒤돌아보면 간단하지만 막상 할 때는 막막했던 과제들을 헤쳐나갔다.
### 2. 회귀 분석 후 pickle로 모델 저장하기
```python
for i in range(len(info)):
song = info[i]
artist_info = song["track"]["album"]["artists"]
artist_info = artist_info[0]
artist_name = artist_info["name"]
artists.append(artist_name)
song_id = song["track"]["id"]
song_name = song["track"]["name"]
song_uri = song["track"]["uri"]
features = sp.audio_features(f'spotify:track:{song_uri}')
features = features[0]
```
위 코드는 내가 좋아요 한 가수들의 리스트에서 아티스트 명으로 API를 이용해 반환된 기나긴 딕셔너리에서 필요한 정보를 얻는 보기엔 간단하지만 쓸 때는 꽤나 어려웠던 코드이다. 딕셔너리에 딕셔너리가 있고 또 그안에 리스트가 있고 그 안에 딕셔너리가 있어서 구조를 파악하는데 어려움을 겪어 오래 걸렸다. 이 코드로 내가 좋아요 한 가수들의 가장 유명한 곡 하나의 특성들 11가지(Spotify API에서 제공)를 얻는데까지 성공했고 이 특성들을 데이터프레임으로 저장해 로지스틱 회귀 분석을 했다.
이번 섹션에서 예측 모델의 성능은 중요하지 않기 때문에 별도의 모델 튜닝은 없었고 트레이닝 샘플도 많지 않았다. 그래서 모델을 이용해 예측을 하면 편중된 데이터 샘플(좋아요 한 가수의 데이터가 압도적으로 많다.)로 인해 내가 모든 아티스트를 좋아할 거라고 말한다. 하지만 이 부분은 모델 튜닝과 충분한 데이터가 있다면 충분히 개선할 수 있는 부분이기 때문에 시간이 남을 때 도전해보려고 한다.
그리고 이 모델을 pickle을 통해 저장해서 분석이 필요할 때 모델만 불러와서 사용을 하면 된다! 이 과정은 산님(부트캠프 코치)이 꽤나 친절하게 예시 파일을 만들어 놓으셔서 어려운 과정이 아니었다.
하지만 "wb"라던가 "rb"와 같은 것은 생소해서 찾아보니 파일을 쓰기 모드로 열 때는 "wb", 읽기 모드로 열 때는 "rb"를 써야한다고 한다. (write binary, read binary)
```python
def save_model(model):
with open(MODEL_PATH, "wb") as file:
pickle.dump(model, file)
```
초심자인 나는 짧은 코드에서도 여러 가지가 생소하고 배울게 많다.
### 3. 데이터베이스를 읽고 쓰고 업데이트하고 삭제하기(CRUD)
sqlalchemy덕분에 postgreslq에 리모트로 연결한 뒤 데이터베이스에 읽고 쓰고 삭제하는 건 그렇게 어렵지 않았다. sql 쿼리문이 아닌 파이썬 코드로 작성하다보니 좀 더 친숙해서 이용하기 편했기 때문이다. 하지만 업데이트 기능을 구현하는데 애를 먹었다. 나는 데이터베이스에 artist 테이블 하나와 그 안에 세 가지 컬럼(id, artist name, loveorhate)을 넣었는데 내가 좋아할지 여부를 예측한 결과를 저장하는 loveorhate 컬럼에 예측 결과가 업데이트 되지 않았다. 난 왜 그런걸까 생각하며 스택오버플로우에서 발굴한 여러 가지 쿼리를 이용해 봤고 부트캠프의 헬프데스크도 이용해봤다. 헬프데스크의 답변을 보고 이것저것 시도하던 중 내가 테이블을 만들 때 loveorhate 컬럼을 nullable=True로 해놓은 것이 문제였다는걸 깨달았다. 그래서 레코드를 만들 때 null값이 아니라 NA라는 문자열을 채워 넣었고 나중에 분석 결과가 나오면 NA로 채워진 값을 I will love나 I will hate으로 업데이트 되게끔 만들었다. 이렇게 CRUD(읽고 쓰고 업데이트하고 삭제하기)기능을 모두 구현했다.
### 4. flask와 html로 웹페이지 구현하기
사실 산님의 예시 템플릿이 있어 웹페이지를 구현하는게 어렵지 않을 줄 알았다. 워낙 단순한 페이지라 다른 과정보다 목과 안구를 덜 혹사시켰고 순탄한 것은 사실이었지만 마지막 결과 부분을 보여주는 페이지가 아무리 해도 하얀 화면에 I will love it 만을 보여줬기 때문이다. 나는 html의 문제인줄 알고 이것저것 수정해봤지만 돌아오는 것은 흰 화면뿐이었다. 그러다가 return 부분에서 result(=I will love it)을 뺐더니 템플릿이 정상적으로 나타났다.
```python
# return render_template('result.html', result=pred_id)
return render_template('result.html')
```
그래서 그제서야 html이 아닌 파이썬 코드를 뜯어봤다. 원인은 내가 result 페이지의 함수에 아무런 파라미터도 집어넣지 않은 것이었다. 다른 페이지의 함수 부분을 보면
```python
@app.route('/delete', methods=["GET", "POST"])
def delete_artist(artist_name=None):
```
이렇게 괄호 안에 파라미터가 있어 내가 페이지에서 입력한 값을 받는 부분이 있다. 근데 분석 결과를 보여주는 result 함수는 괄호 안이 텅텅 빈 채로 있었기 때문에 함수가 값을 받지 못하고 흰 화면에 I will love it 열한글자 만을 계속 해서 보여준거였다. 그래서 괄호 안에 result=None을 넣어주고 나서야 나의 프로젝트는 꼭 필요한 기능이 구현된 상태로 마무리 되었다.
### 5. heroku를 이용해 웹 어플리케이션 배포하기
이렇게 만든 웹 어플리케이션을 로컬에서만 돌릴 수 있다면 내가 아쉽기 때문에, 또 프로젝트의 요구조건이기 때문에 heroku로 웹 어플리케이션을 배포해야 했다. 이 부분도 산님이 친절히 과정을 보여주셨기 때문에 어렵지 않을거라고 생각했고 잘 되고 있는 줄 알았는데 code=h10, status=503 에러가 계속 났다. 로그를 살펴보니 procfile에서 지정한 앱을 찾을 수 없는 것 같아서 procfile 내용을 바꿔보고 되나 확인을 해보는데 heroku git에 업로드(push)하는데 너무 오래 걸려서 거의 눈물을 흘리며 확인하는 과정을 거쳤다.
처음에 써본 procfile 내용은 이렇다.
web: gunicorn spotify_app:app
그리고 한 다섯번쯤 수정해봤고 결국 산님이 나의 코드를 확인하시고 답을 알려주셨다.
web: gunicorn spotify_app.spotify:app (spotify_app 안, spotify.py 파일의 app을 지정해주는 내용인듯하다.)
이렇게 알고 나면 너무 당연한 일인데 몰랐던 내가 바보같고 그런 기분이 들 수도 있는데 원래 처음 뭔가 시작하면 당연한 것도 어렵고 모를 수 있기 때문에 이 글을 읽는 모두(나 포함) 용기를 가지셨으면 좋겠다.
마무리
---
짧다면 짧고 길다면 긴, 월요일부터 목요일까지 나흘 간의 웹 어플리케이션 만들기가 끝이 났다. 아직 웹 어플리케이션은 최종_진짜최종.py 인 상태라고 보긴 어렵지만 프로젝트에서 요구한 기능은 모두 갖추었기 때문에 당장은 마무리가 됐다고 할 수 있을 것 같다. 여러 가지 오류를 맞이하고 혼자서도 해결해 보고 누군가의 도움을 받아 해결하기도 했다. 근데 오류를 해결할 때 마다 새롭고 멋진 아티스트를 찾았을 때보다 더 기분이 좋았고 엔돌핀이 도는 것 같았다. 이 맛에 취미로 코딩을 하는 사람들이 있는걸까?
아직은 어플리케이션이 멋진 이름도 없고 미숙한 상태이지만 내가 처음으로 만든 어플리케이션이기때문에 왠지 정이 가고 내 역량이 좋아지면 계속해서 업데이트를 하고 싶은 마음이 든다.
Contributor guide
No contributing guide indexed for this repository
Research direction
Review the linked GitHub repository and deployed web application to understand the project described in this Korean article. Then check the repository's contribution format and determine how this article should be added; done means the article is included in the blog in the expected format with its project links preserved.
Written by the indexing model from the issue text.
Assessment
- Tech stack
- flask, postgresql, python, scikit-learn, sqlalchemy
- Domain
- backend, content, databases, documentation, machine-learning, web-dev
- Issue type
- Documentation
- Difficulty
- 2/5
- Estimated time
- 1-3 hours
- Activity status
- Stale
- Clarity
- Needs clarification
- Newbie friendliness
- 25/100