codestates / codestates/ds-blog
[오예은] sqlite3을 이용해서 인사 데이터베이스 만들어보기
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
[[미디엄에서보기]](https://dsdoris.medium.com/sqlite3%EC%9D%84-%EC%9D%B4%EC%9A%A9%ED%95%B4%EC%84%9C-%EC%9D%B8%EC%82%AC-%EB%8D%B0%EC%9D%B4%ED%84%B0%EB%B2%A0%EC%9D%B4%EC%8A%A4-%EB%A7%8C%EB%93%A4%EC%96%B4%EB%B3%B4%EA%B8%B0-e9f4fa3cda33)
최근 모 케이블방송에서 방영되는 '스타트업'이라는 드라마를 보셨나요?
주인공 '서달미'와 '남도산'이 "삼산텍"이라는 작은 회사를 키워가는 이야기가 내용 중의 일부로 나오는데요.
좋은 앱을 개발해서 투자도 받았고 해외에서도 반응이 좋으니, 곧 직원도 더 뽑아야할 것 같아요.
그래서 오늘은 제가 달미님을 도와 삼산텍의 직원을 관리하기 쉽도록 아주 간단한 **인사 관리 데이터베이스**를 만들어보려 합니다.
아직은 비용절감이 중요하니(!) 파이썬에 내장되어있는 sqlite3이라는 라이브러리를 활용해서
내 컴퓨터에서 관리할 수 있도록 만들어보겠습니다.
---
데이터베이스 구성은 아래과 같습니다.
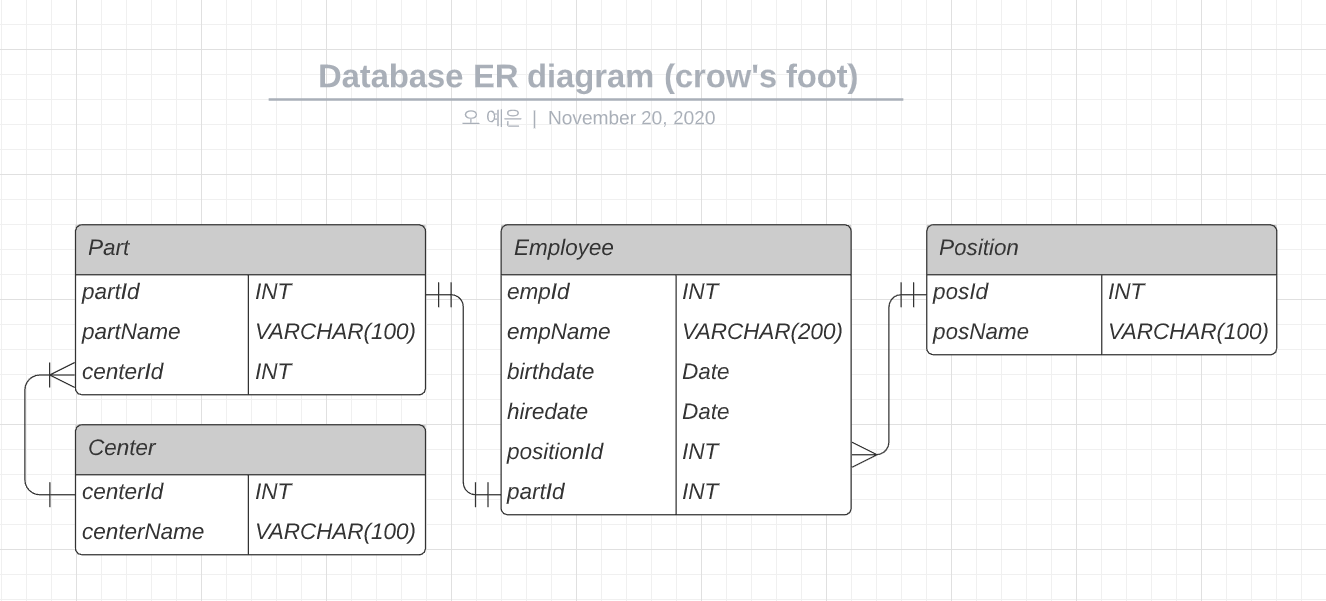
* **<직원>테이블; Employee**
- empId: 사번(직원아이디) PK
- empName: 직원이름
- birthdate: 생년월일
- hiredate: 입사일
- positionId: 직책 FK - <직책>테이블과 연결
- partId: 근무부서 FK - <근무부서 (-근무지)> 테이블과 연결
* **<직책>테이블; Position**
- posId: 직책 번호 PK FK- <직원>테이블과 연결
- posName: 직책명
* **<근무지>테이블; Center**
- centerId: 센터 번호 PK FK- <근무부서> 테이블과 연결
- centerName: 센터명
* **<근무부서>테이블; Part**
- partId: 부서 번호 PK FK- <직원> 테이블과 연결
- partName: 부서명
- centerId: 센터명(부서가 위치한 센터) FK - <센터>테이블과 연결
---
그림과 설명을 보시면 알아채셨겠지만, 우리가 만들 관계형 데이터베이스에서는
테이블 여러개를 만들어 중복을 최소화 한 상태에서 테이블 간 관계를 만들어 데이터를 관리합니다.
어떤 테이블에서 연결된 데이터를 찾아가기 위해선 두 개의 키가 필요합니다.
### PK (Primary Key; 기본키)
- 한 테이블에서 어떤 레코드(데이터)를 대표/구별할 수 있도록 고유값으로 지정된 항목(컬럼)
- 인덱스 컬럼이 될 수도 있고, 어떤 두 컬럼을 합한 것일 수도 있다.
- 각 레코드를 대표하는 값이기 때문에 한 테이블에 하나의 컬럼만 기본키로 설정할 수 있고, 값을 비워(NULL)둘 수 없다.
### FK (Foriegn Key; 외래키)
- 어떤 테이블에서 다른 테이블로 연결되는 기준이 되는 항목(컬럼)
- 어떤 테이블 A와 연결된 다른 테이블 B의 항목 값이 일치할 때 두 테이블을 연결할 수 있다.
- 한 테이블에 여러 개의 외래키가 존재할 수 있다.
.
.
.
그렇다면 본격적으로 파이썬에서 데이터베이스를 만들어보고 직접 직원을 입력하고 조회해볼까요?
첫번째로, SQLite3이라는 라이브러리를 불러와서 데이터베이스 파일을 만들고
우리가 코드를 쓰고 있는 파이썬 파일과 연결해줍니다.
```py
import os
import sqlite3
# sqlite(DB) 연결
conn = sqlite3.connect(os.path.join(os.path.dirname(__file__),
"..",
"data",
"samsantec.sqlite"))
```
그 다음 삼산텍 직원 정보를 저장할 테이블을 만들어줍니다.
SQL문은 우리가 쓰는 언어와 매우 비슷해서 만들어라(Create)! 없애라(Drop)! 하는 문장으로 간단하게 테이블을 만들 수 있습니다.
앞에 나왔던 스키마(구조)를 보면 총 4개의 테이블을 만들어야 하니 총 4개의 쿼리문이 필요합니다.
```py
def create_tables(connection):
# 커서(쿼리문을 담을 상자) 연결
cur = connection.cursor()
query = []
query1 = """
CREATE TABLE Position (
posId INT PRIMARY KEY,
posName VARCHAR(100));
"""
query2 = """
CREATE TABLE Center (
centerId INT PRIMARY KEY,
centerName VARCHAR(100));
"""
query3 = """
CREATE TABLE Part (
partId INT PRIMARY KEY,
partName VARCHAR(100),
centerId INT,
FOREIGN KEY (centerId) REFERENCES Center(centerId)
);
"""
query4 = """
CREATE TABLE Employee (
empId INT PRIMARY KEY,
empName VARCHAR(100),
birthdate TEXT,
hiredate TEXT,
positionId INT,
partId INT,
FOREIGN KEY (positionId) REFERENCES Position(posId),
FOREIGN KEY (partId) REFERENCES Part(partId)
);
"""
# 쿼리를 실행
## table이 이미 존재할 경우 삭제 후 생성
cur.execute("DROP TABLE IF EXISTS Position;")
cur.execute("DROP TABLE IF EXISTS Center")
cur.execute("DROP TABLE IF EXISTS Part")
cur.execute("DROP TABLE IF EXISTS Employee")
# 테이블 생성 쿼리 실행(executemany)
cur.execute(query1)
cur.execute(query2)
cur.execute(query3)
cur.execute(query4)
```
그럼 테이블을 만들었으니 그 안에 데이터를 넣어봅시다.
일단, 직원 정보를 설명해줄 3개의 테이블부터 데이터를 넣어주려고 합니다.
> * <직책>테이블 - { 1: CEO , 2: CTO, 3: manager, 4: staff }
> * <근무지>테이블 - { 1: 서울-sandbox , 2: 성주, 3: 부산, 4: 해외}
> * <근무부서>테이블 - { (1: "경영전략부", 1), (2: "개발부", 1), (3: "디자인부", 1), (PA4: "마케팅부", 2)}
```py
# 직책 데이터
positionlist = [(1, 'CEO'),
(2, 'CTO'),
(3, 'manager'),
(4,'staff')
]
# 근무지 데이터
centerlist = [(1, '서울_Sandbox'),
(2, '성주'),
(3, '부산'),
(4,'해외')
]
# 근무부서 데이터
partlist = [(1, '경영전략부', 1),
(2, '개발부', 1),
(3, '디자인부', 1),
(4,'마케팅부', 2)
]
cur.executemany("INSERT INTO Position VALUES (?, ?)"
, positionlist)
cur.executemany("INSERT INTO Center VALUES (?, ?)"
, centerlist)
cur.executemany("INSERT INTO Part VALUES (?, ?, ? )"
, partlist)
```
이번엔 직원 정보를 넣어주겠습니다.
삼산텍 직원은 총 다섯명입니다만, 마케팅 영상을 제작해주어 지분 1%를 가지고 있는 남천호(남도산의 사촌)씨도 넣어보겠습니다.
> 1. 서달미(CEO, 경영전략부), 1993년 3월 26일 생, 2020년 11월 1일 입사
> 2. 남도산(CTO, 개발부), 1993년 5월 7일 생, 2020년 11월 1일 입사
> 3. 김용산(manager, 개발부), 1993년 8월 23일 생, 2020년 11월 1일 입사
> 4. 이철산(manager, 개발부), 1994년 1월 9일 생, 2020년 11월 1일 입사
> 5. 정사하(manager, 디자인부), 1992년 12월 28일 생, 2020년 11월 1일 입사
> 6. 남천호(staff, 마케팅부), 1991년 11월 11일 생, 2020년 11월 1일 입사
```py
# 직원 데이터
emplist = [(1, '서달미', '1993-03-26', '2020-11-01', 1, 1),
(2, '남도산', '1993-05-07', '2020-11-01', 2, 2),
(3, '김용산', '1993-08-23', '2020-11-01', 3, 2),
(4, '이철산', '1994-01-09', '2020-11-01', 3, 2),
(5, '정사하', '1992-12-28', '2020-11-01', 3, 3),
(6, '남천호', '1991-11-11', '2020-11-01', 4, 4)
]
cur.executemany("INSERT INTO Employee VALUES (?, ?, ?, ?, ?, ? )"
, emplist)
connection.commit()
```
---
와! 드디어 데이터베이스 구성은 완료하였습니다! (짝짝짝)
그럼 데이터가 잘 들어갔는지 살펴보도록 하겠습니다.
### 삼산텍 직원 다 나와라!
```sql
SELECT * FROM Employee;
```
| empId | empName | birthdate | hiredate | positionId | partId |
|-------|---------|------------|------------|------------|--------|
| 1 | 서달미 | 1993-03-26 | 2020-11-01 | 1 | 1 |
| 2 | 남도산 | 1993-05-07 | 2020-11-01 | 2 | 2 |
| 3 | 김용산 | 1993-08-23 | 2020-11-01 | 3 | 2 |
| 4 | 이철산 | 1994-01-09 | 2020-11-01 | 3 | 2 |
| 5 | 정사하 | 1992-12-28 | 2020-11-01 | 3 | 3 |
| 6 | 남천호 | 1991-11-11 | 2020-11-01 | 4 | 4 |
> 코드에 등장한 *(와일드카드)를 사용하면 Employee 테이블에 있는 모든 데이터를 조회할 수 있습니다.
> 다만 직책과 근무부서가 숫자로 표기되는데, 이것은 그냥 <직원>테이블에 있는 데이터를 그대로 불러왔기 때문입니다.
> 실제 직책과 근무부서명을 보고 싶다면 다른 테이블과 연결(Join)이 필요합니다.
### 삼산텍 CEO는 누구인가요?
```sql
SELECT p.posName as 'Position', e.empName as 'Name' FROM Employee as e
JOIN Position as p ON e.positionId = p.posId
WHERE p.posName = 'CEO';
```
| Position | Name |
|----------|------|
| CEO | 서달미 |
> Join을 이용해 다른 테이블의 데이터도 불러오고, Where 구절로 조건을 걸어 조회할 수도 있습니다.
### 개발부 직원을 뵙고 싶습니다.
```sql
SELECT pt.partName as '부서', e.empName as '이름', p.posName as '직책' FROM Employee as e
JOIN Part as pt ON e.partId = pt.partId
JOIN Position as p ON e.positionId = p.posId
WHERE pt.partName LIKE '%개발부%';
```
| 부서 | 이름 | 직책 |
|-----|-----|---------|
| 개발부 | 남도산 | CTO |
| 개발부 | 김용산 | manager |
| 개발부 | 이철산 | manager |
> Where 조건에서 특정 내용이 포함된 데이터도 찾을 수 있죠.
### 직원 데이터 삭제하기
우리가 직원으로 등록했던 남천호님의 경우 실제 직원이 아니기 때문에 이분의 데이터를 지워보도록 하겠습니다.
```sql
DELETE FROM Employee
WHERE empName = '남천호';
COMMIT;
SELECT * FROM Employee;
```
`Query 2 OK: not an error`
| empId | empName | birthdate | hiredate | positionId | partId |
|-------|---------|------------|------------|------------|--------|
| 1 | 서달미 | 1993-03-26 | 2020-11-01 | 1 | 1 |
| 2 | 남도산 | 1993-05-07 | 2020-11-01 | 2 | 2 |
| 3 | 김용산 | 1993-08-23 | 2020-11-01 | 3 | 2 |
| 4 | 이철산 | 1994-01-09 | 2020-11-01 | 3 | 2 |
| 5 | 정사하 | 1992-12-28 | 2020-11-01 | 3 | 3 |
> Insert나 update, delete와 같이 테이블 내의 데이터를 변경하는 작업은 꼭 commit을 해주어야 합니다.
> commit은 데이터를 변경했다는 이력을 남기는 것인데, commit을 해야 변경이 완료됩니다. (데이터를 넣어줄때도 사용했어요!)
> commit 전에 혹시라도 변경이 잘못된 경우 rollback을 이용해 변경 전으로 돌릴 수도 있습니다.
> `데이터는 소중하니까요`
---
이상 삼산텍의 인사관리 데이터베이스를 살펴보았습니다.
회사가 확장된다면 각 테이블에 다른 컬럼을 추가하거나 (근무지나 부서 추가, 직원 추가 등) 다른 테이블과 연결해서 사용할 수도 있겠지요.
그럼 삼산텍의 해피엔딩을 기원하며 글을 마치겠습니다.
`본 게시글에 등장한 인물은 드라마 '스타트업'에 나온 가상의 인물을 바탕으로 하였습니다.`
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.