codestates / codestates/ds-blog
[김태헌]_Project 자동차보험 권유대상 예측
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
# 자동차보험 권유대상 예측
어떤 보험회사에서 본 회사를 이용해주고있는 고객을 대상으로 이번에 새롭게 시작한 자동차 보험을 권유하려한다. 하지만 모든 고객에게 무작정 권유를 할수없으니, 고객 데이터를 보고 자동차보험에 관심을 가지고있는 사람을 예측하려한다.
### 데이터에 포함된 특성들
- id : 고객 고유번호
- Gender : 성별
- Age : 나이
- Driving_License :
- 0 : 면허를 보유하지 않음
- 1 : 면허를 보유중
- Region_Code : 고객 지역 고유코드
- Previously_Insured :
- 1 : 이미 자동차보험 보유
- 0 : 아직 자동차보험 미보유
- Vehicle_Age : 자동차 연식
- Vehicle_Damage :
- 1 : 과거에 자동차에 손상을 입힌적이 있음
- 0 : 과거에 자동차에 손상을 입힌적이 없음
- Annual_Premium : 보험료
- PolicySalesChannel : 보험을 구매하게 된 경로
- Vintage : 본 회사를 이용한 날짜
- Response :
- 1 : 관심있음
- 0 : 관심없음
# 데이터 불러오기 & 확인하기
```py
# 타겟 지정 - 자동차 보험에 관심이 있는지 없는지 여부 응답 특성
target = "Response"
train = pd.read_csv("train.csv")
test = pd.read_csv("test.csv")
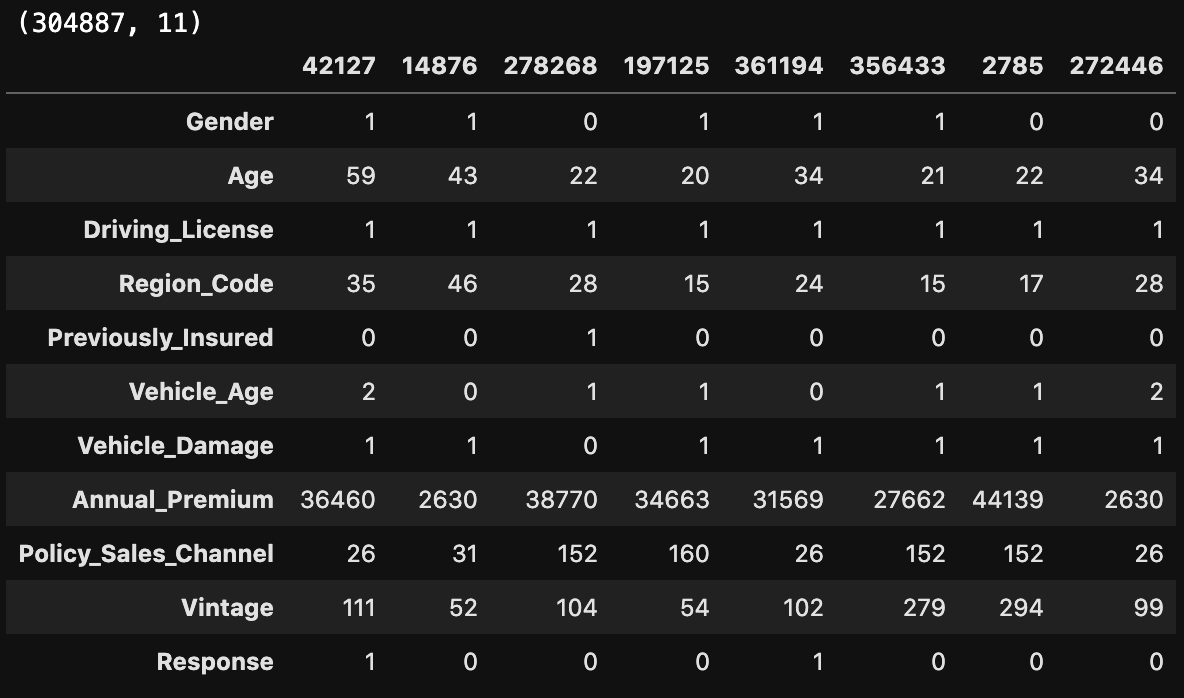
print(train.shape)
train.head(8).T
```
```py
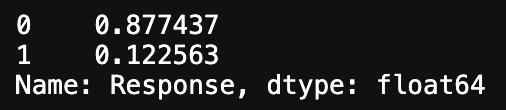
# 타겟의 비율 - imbalance
train[target].value_counts(normalize = True)
```
```py
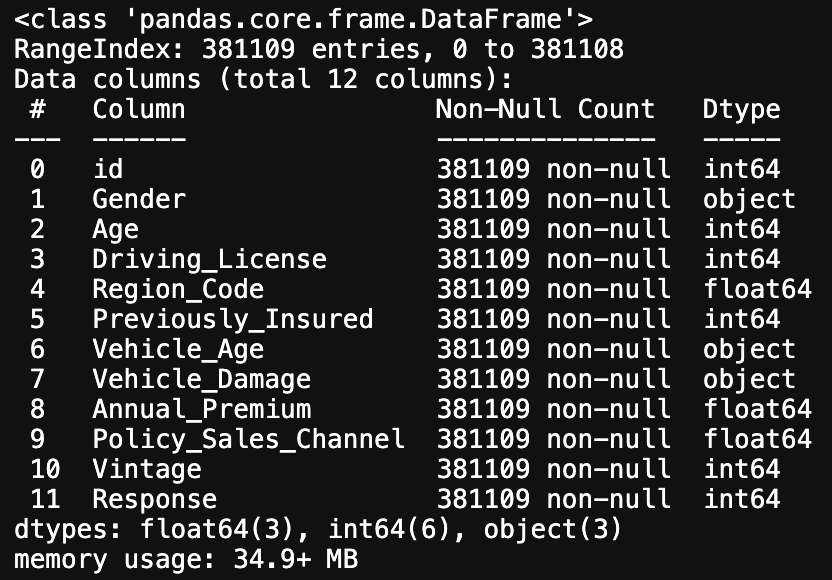
# 결측치와 타입 확인
train.info()
```
```py
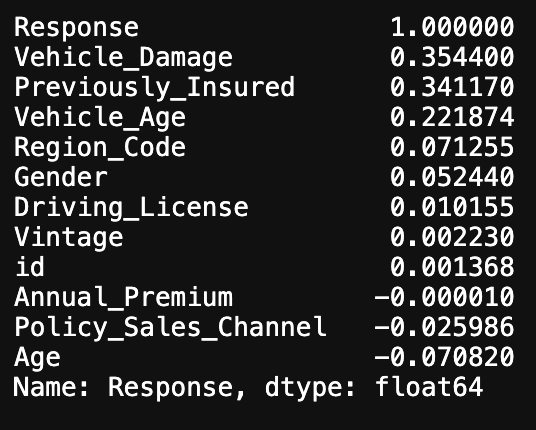
# 타겟과 피쳐의 상관관계
train.apply(lambda x : pd.factorize(x)[0]).corr().sort_values(by='Response',
ascending=False)['Response']
```
## 시각화로 각 특성 살펴보기
### 1. Response(관심이 있는지 없는지에대한 응답)
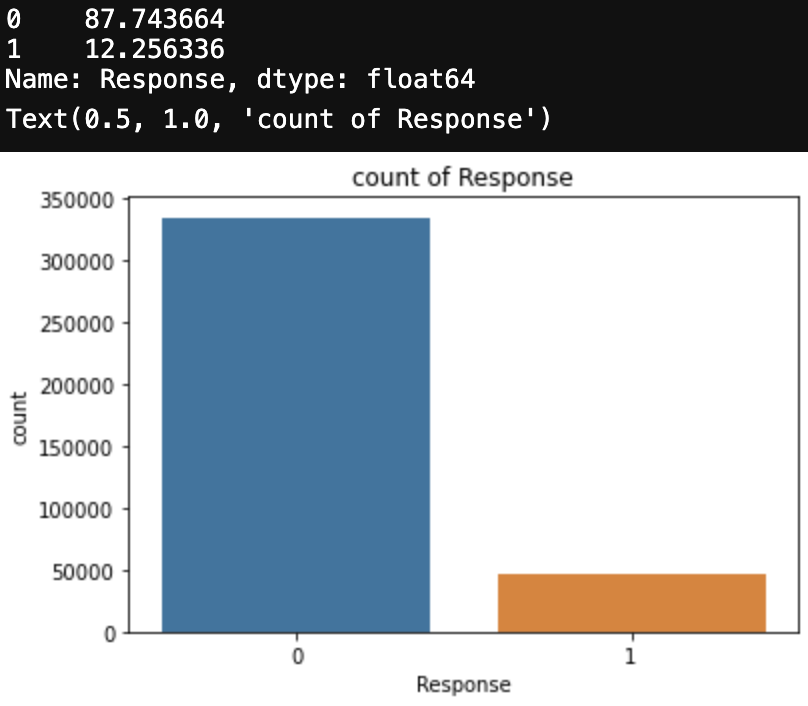
관심이 없는(0)쪽이 앞도적으로 높고 관심이 있는(1)이 매우 적은것을 알수있다.
### 2. Vehicle_Damage(과거 차량손상 여부)
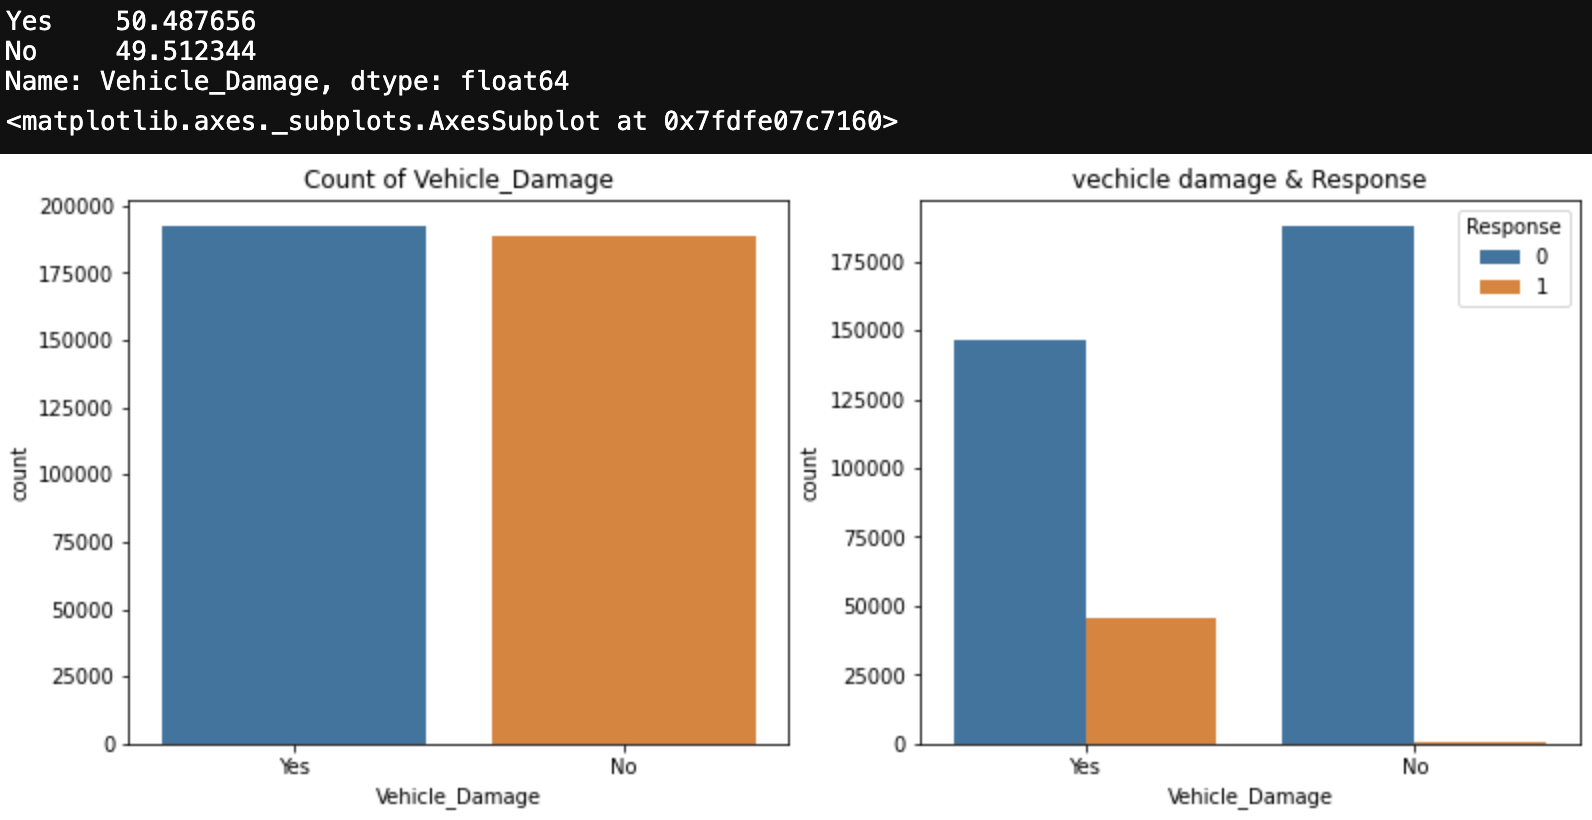
과거 차량 손상 여부는 있는사람과 없는 사람이 비슷한 비율로 있지만, 차량보험에 관심을 보이는쪽은 대부분 과거에 차량을 손상시킨 경험이 있는 사람들이다.
### 3. Previously_Insured(자동차 보험 가입 여부)
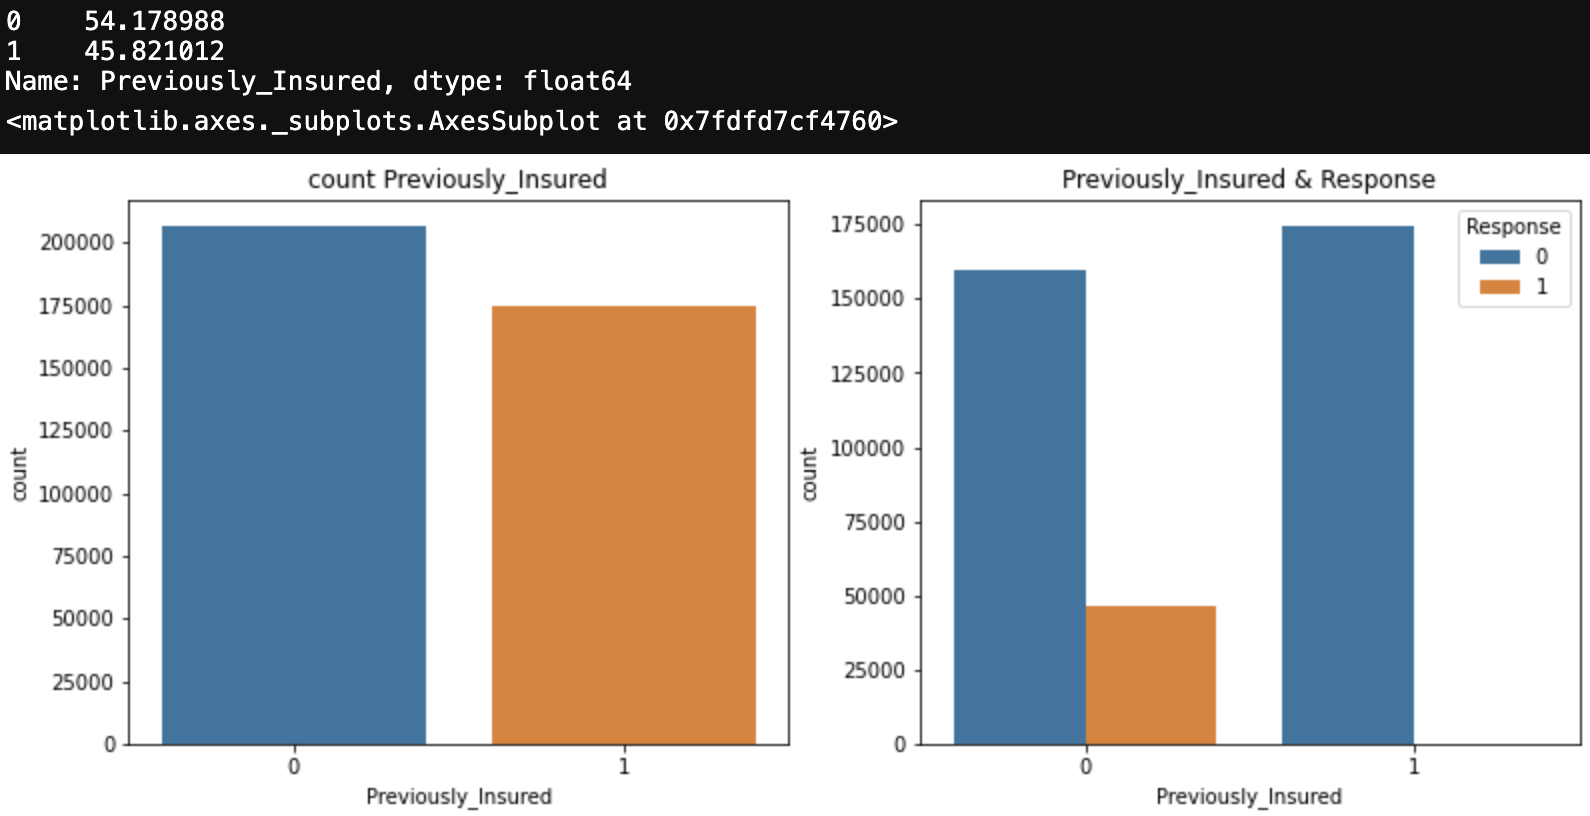
자동차 보험 가입여부는 미가입 고객이 조금더 많고, 당연하지만 자동차보험 미가입 고객만이 자동차 보험에 관심을 가지고있다.
### 4. Vehicle_Age(자동차 연식)
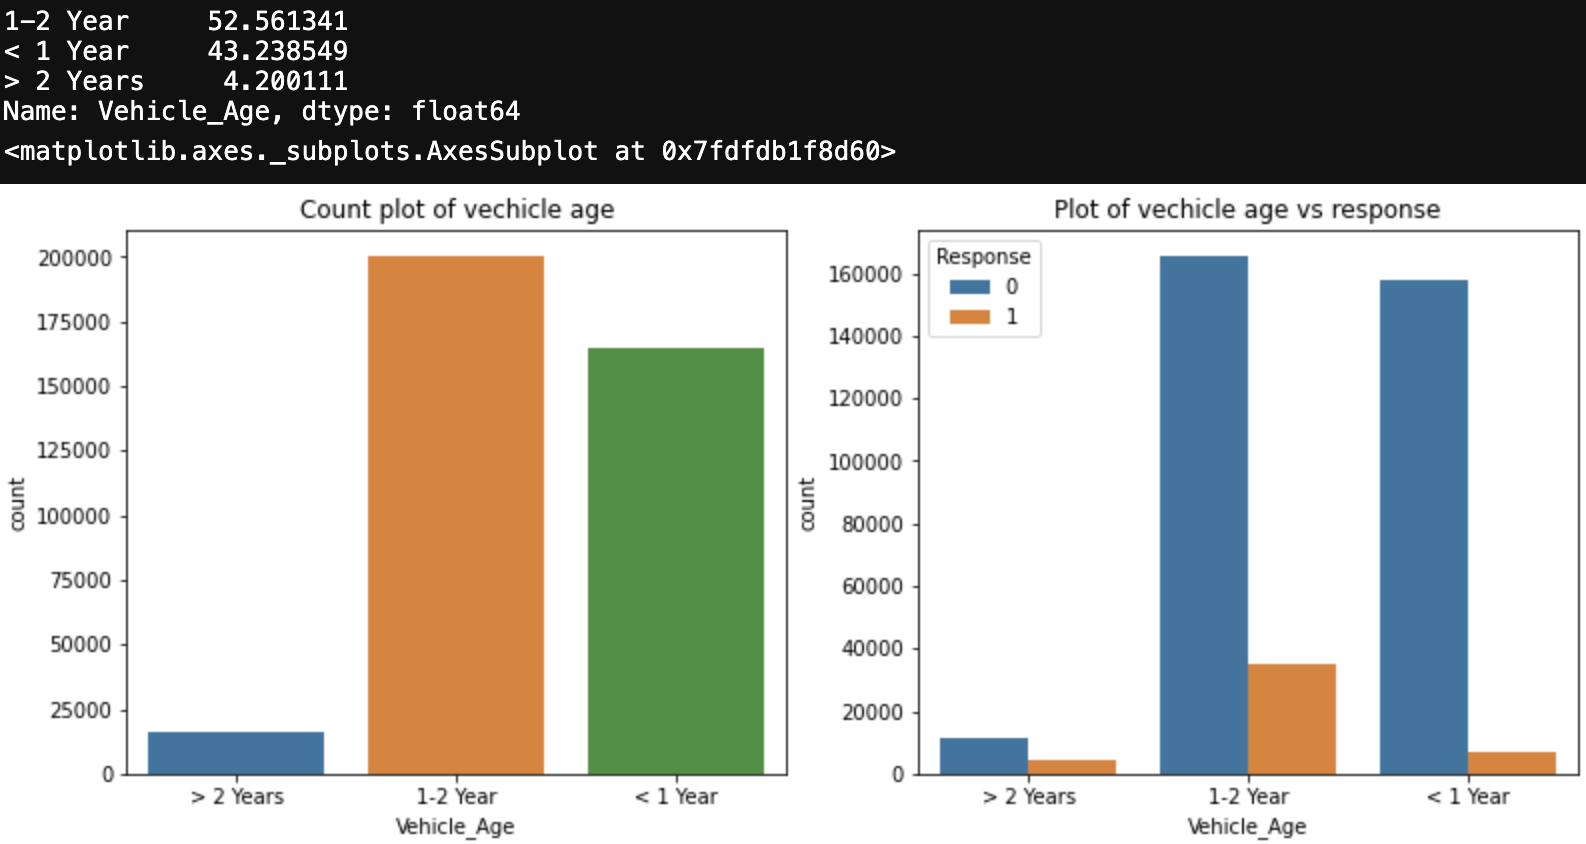
자동차 연식이 오래 될수록 보험에 관심이 많을줄 알았지만 의외로 1년이상2년이하 연식의 자동차 보유고객이 가장 큰 관심을 보인다. 아마도 2년 이상 연식의 자동차보유 고객은 이미 보험에 가입해서이지 않을까 예상해본다.
### 5. Region_Code(고객의 지역 고유코드)
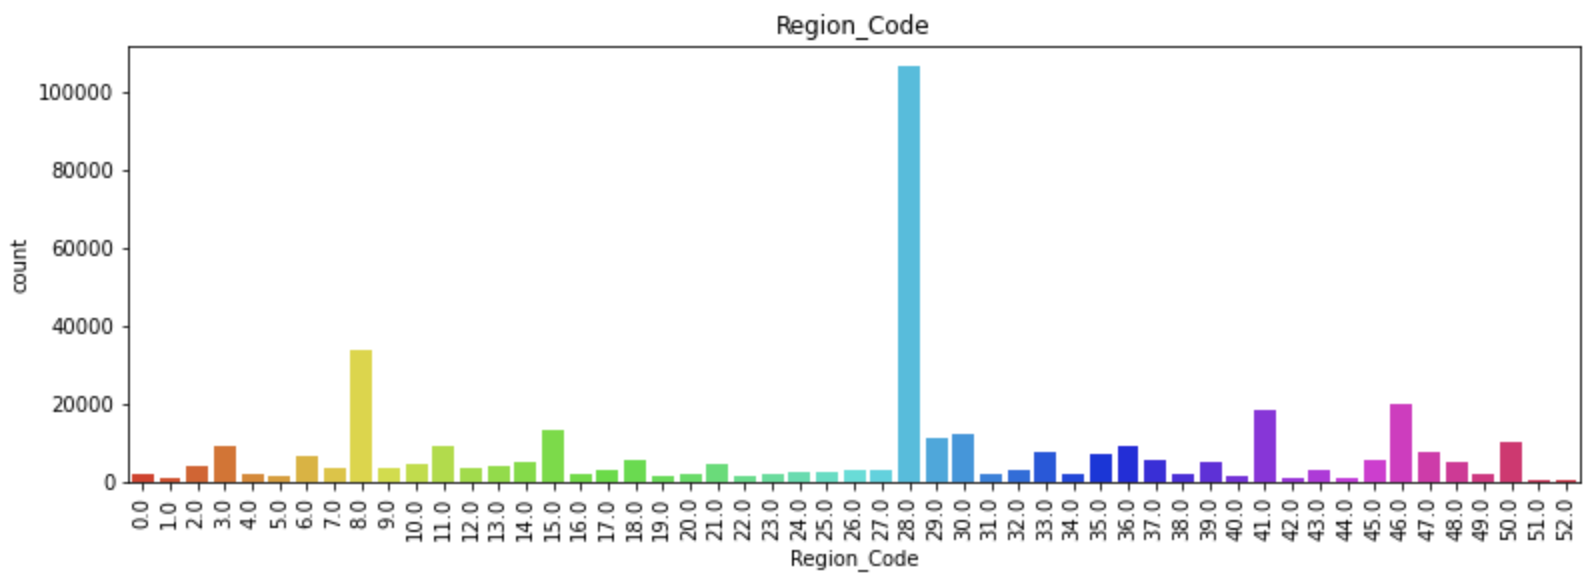
28번 지역에 고객이 가장 많다.
### 6. Gender(성별)
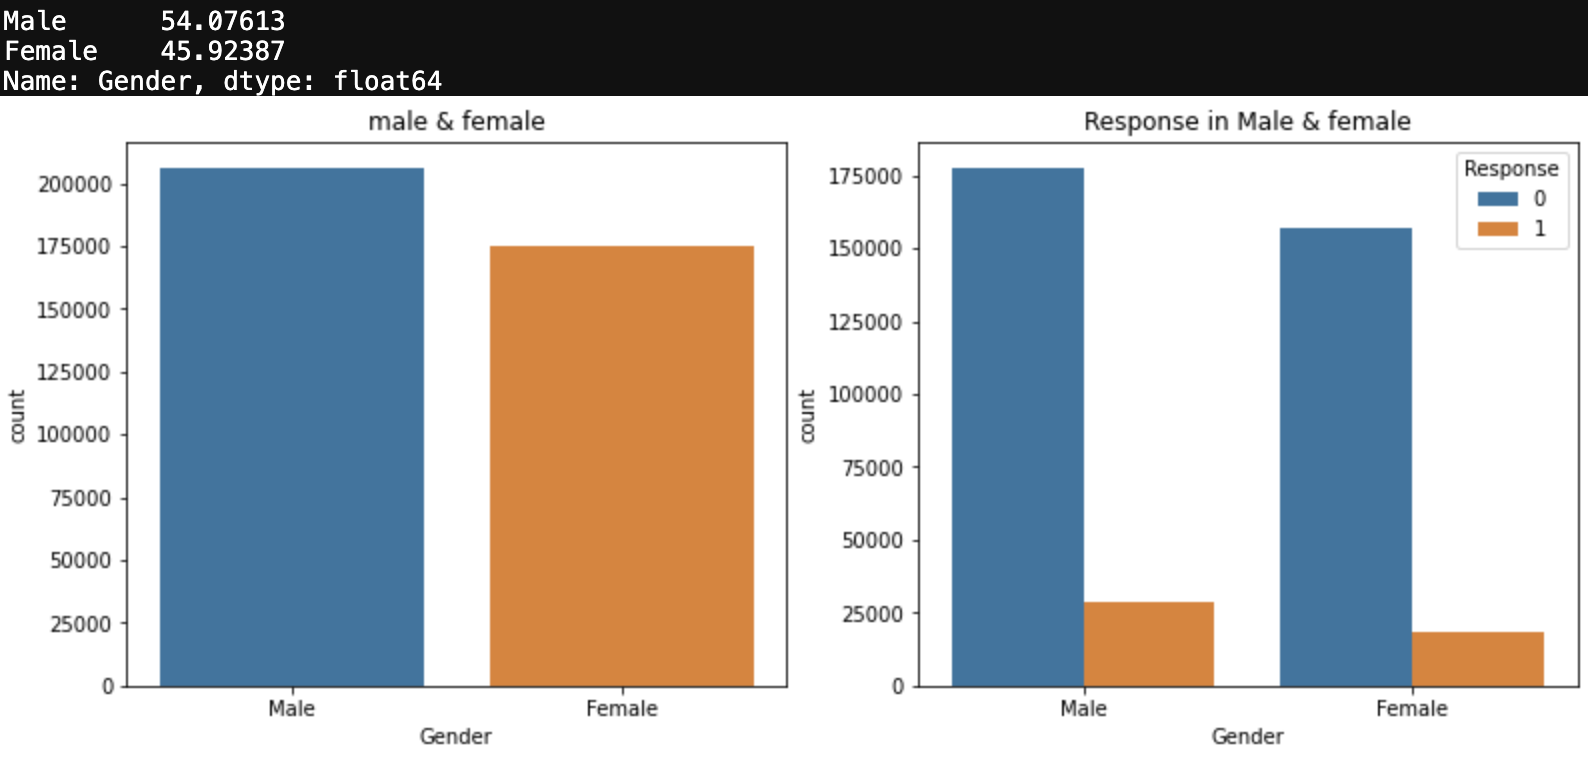
성비는 남자쪽이 조금더 많다. 자동차 보험도 남자의 관심이 높지만, 에초에 성비가 남자가 많기때문에, 그 영향일 가능성이 있다.
### 7. Driving_License(운전면허 보유 여부)
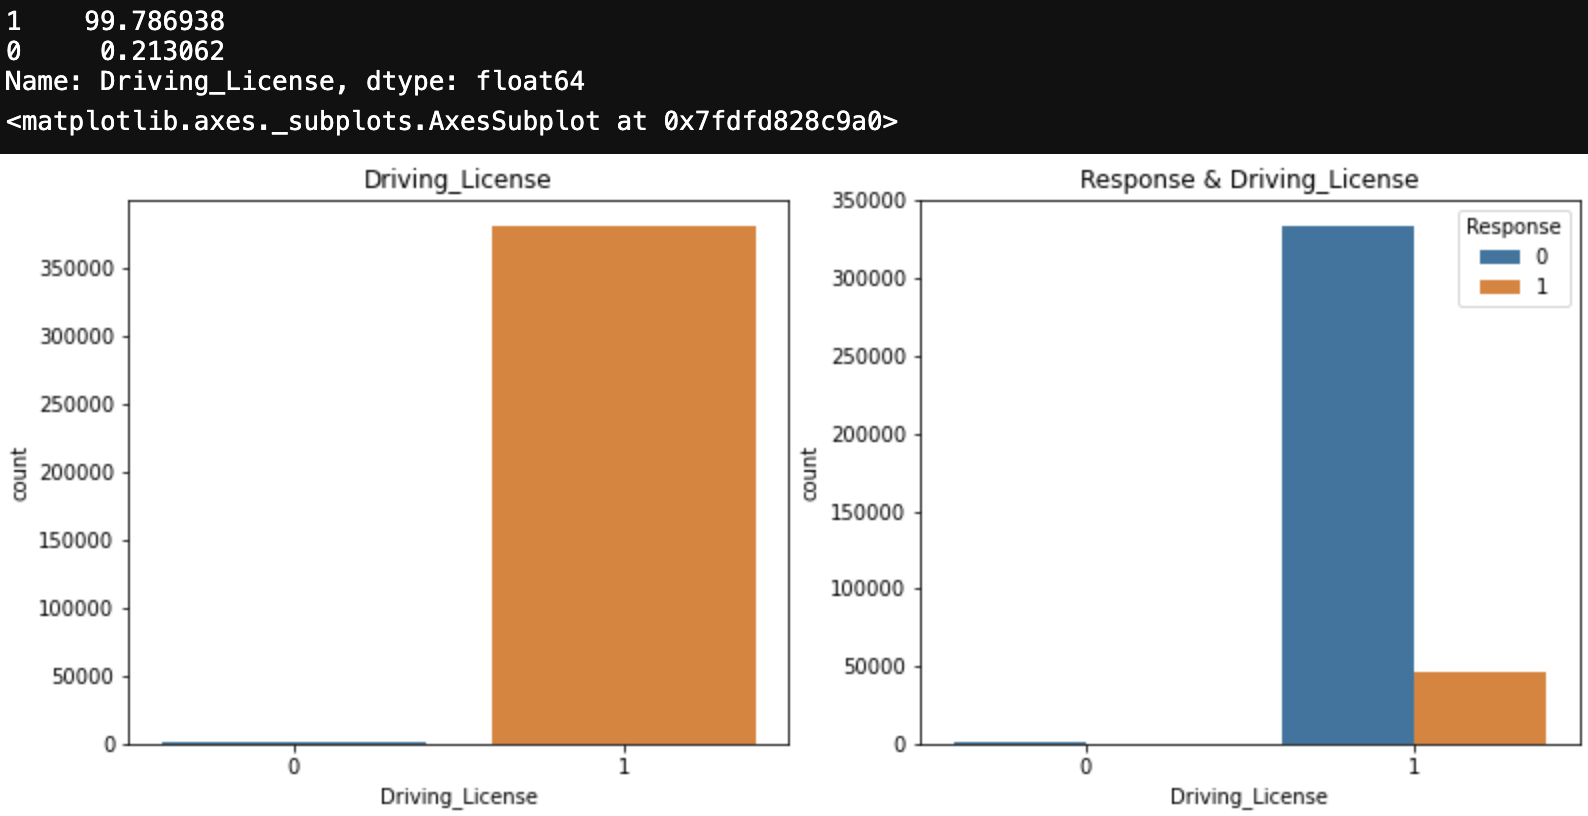
거의 대부분이 자동차 면허증을 가지고있다. 당연한 결과이지만, 자동차 면허증을 소지하고있는 사람들이 자동차 보험에 관심을 가지고있다.
### 8. Vintage(본 회사를 이용한 날짜)
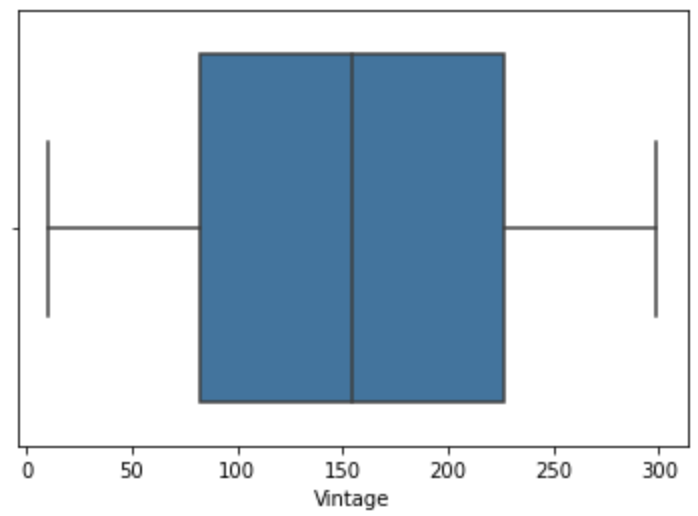
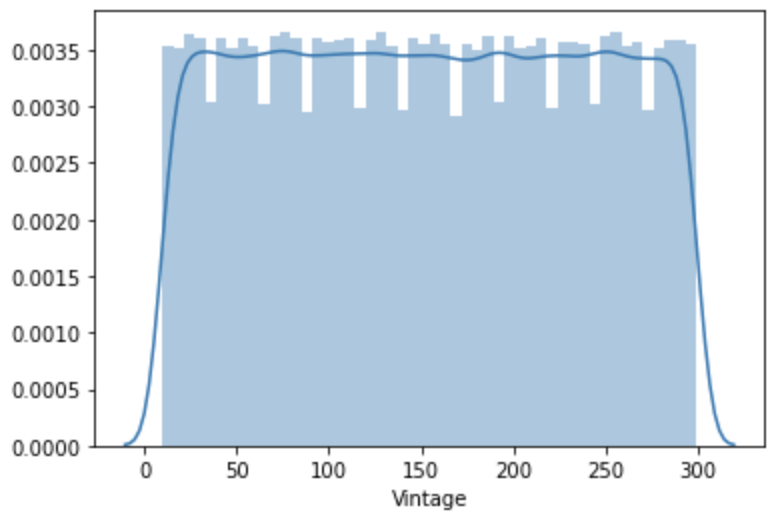
보험 회사를 이용한 기간은 이상치없이 무난한 범주를 가지고있다.
### 9. Annual_Premium(보험료)
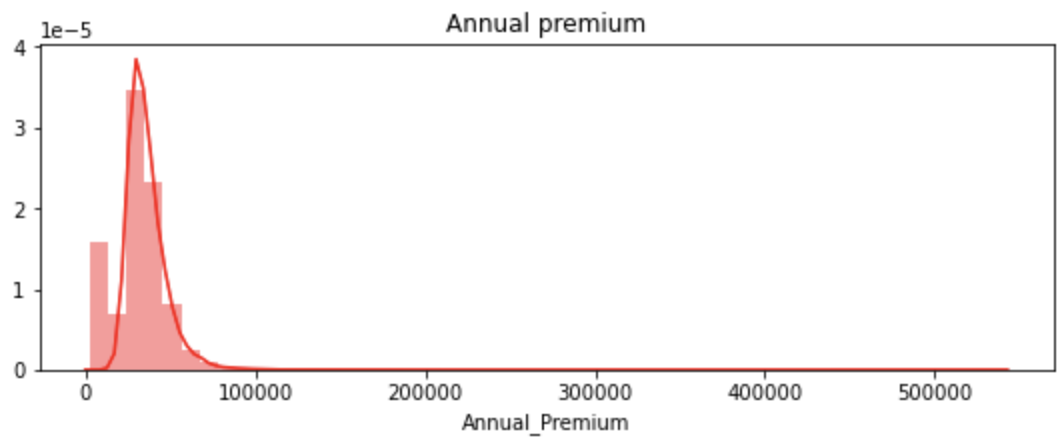
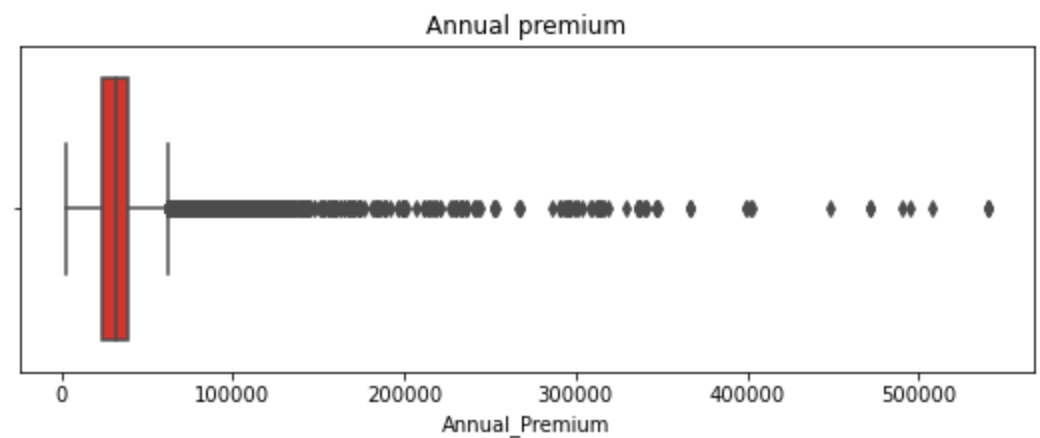
보험료를 확인해보니 이상치로 보이는 부분이 확인되었다. 이 부분은 나중에 전처리 과정에서 제거해주기로 하자.
### 10. Policy_Sales_Channel(보험을 구매하게된 경로)
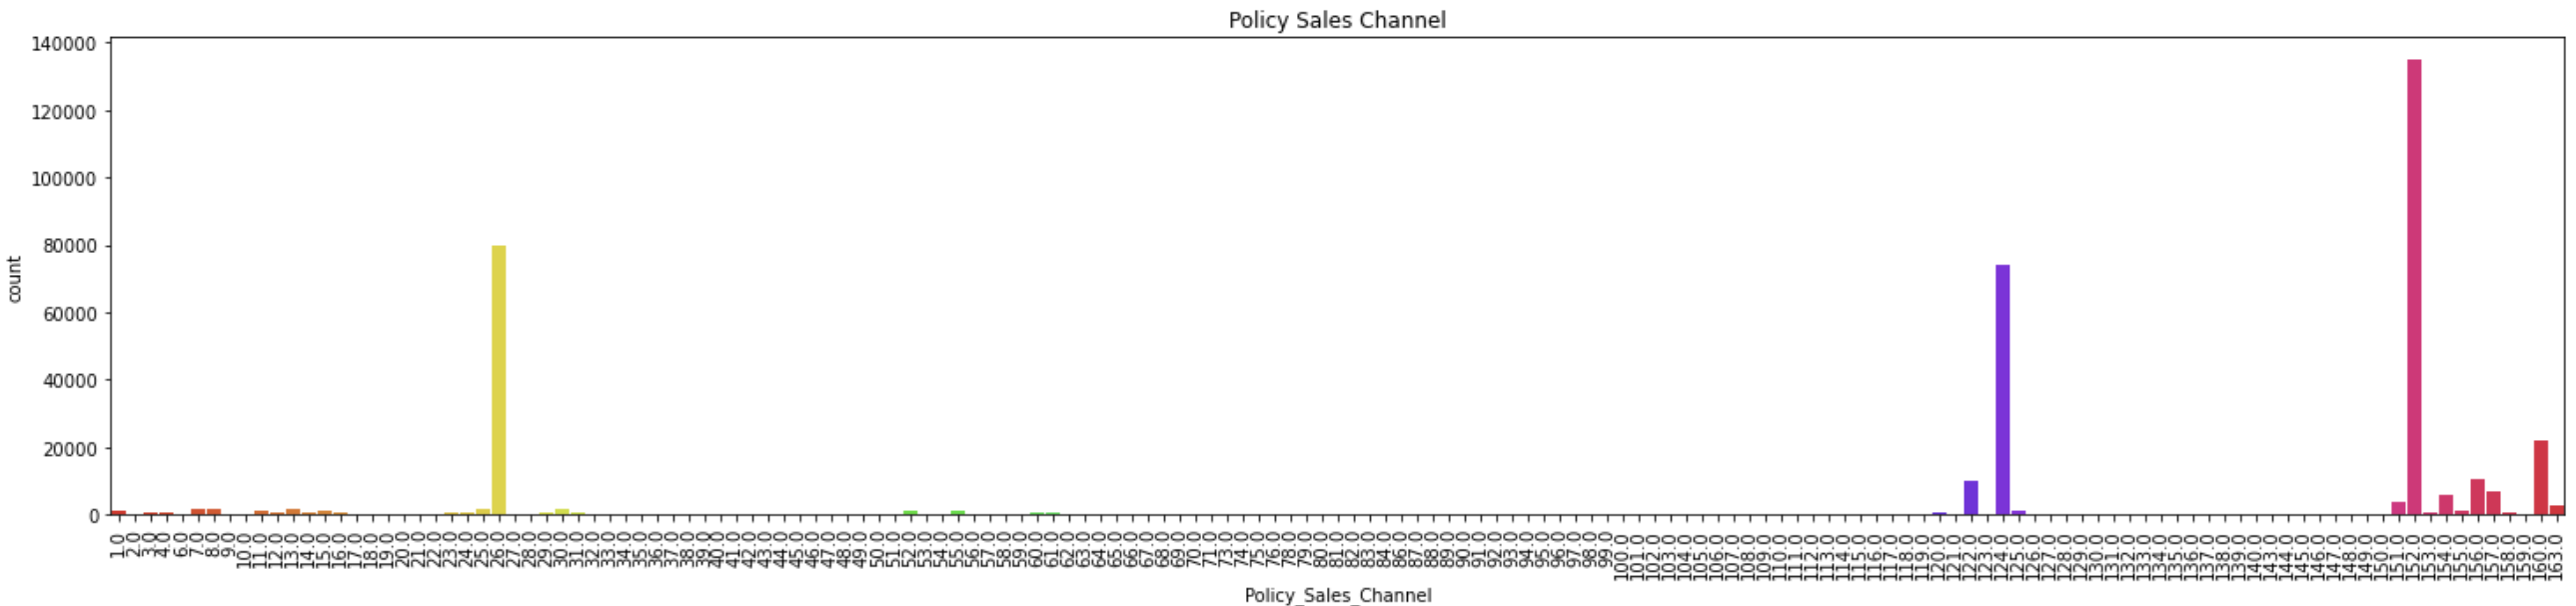
보험을 구매하게된 경로는 특정 부분이 확연하게 높지만, 익명화가 되어있어 타겟과의 연관성을 찾기는 힘들것같다.
### 11. Age(성별)
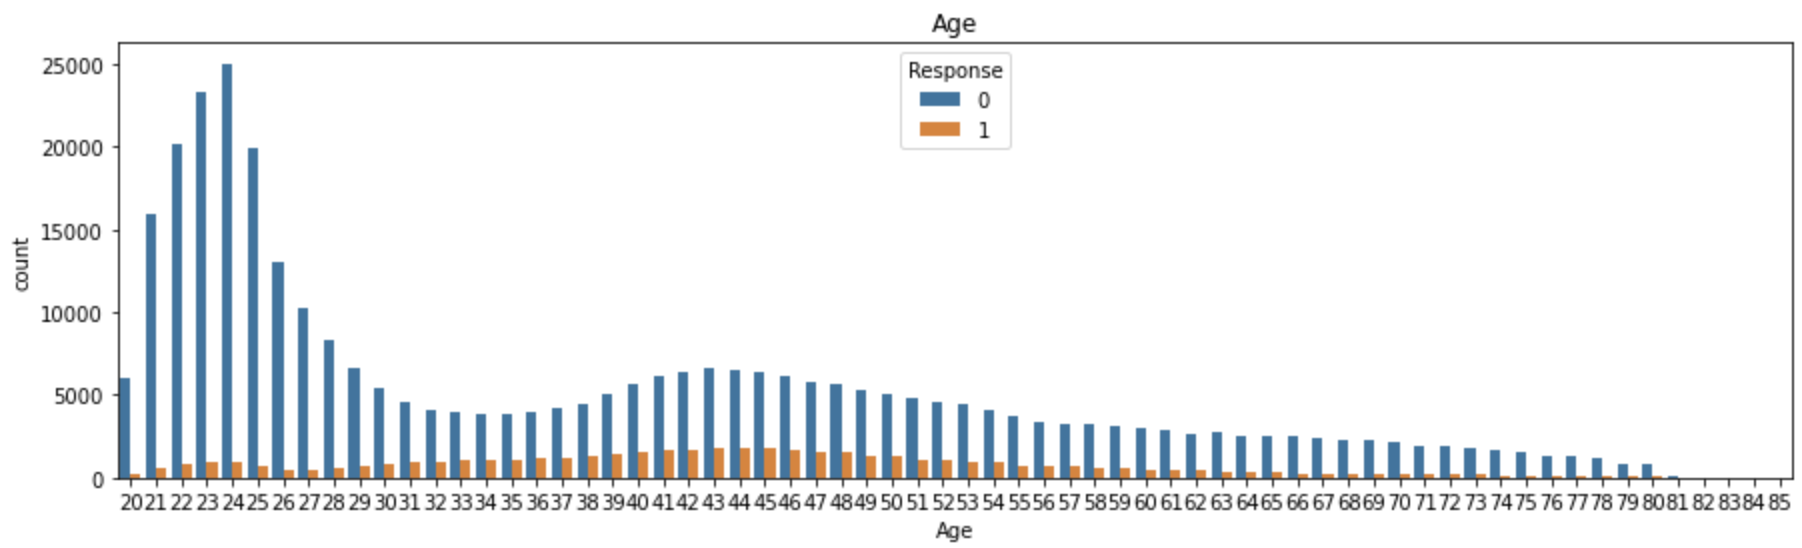
지난해 보험고객은 20대의 비중이 매우 높은것을 알수있다.
# 정보 누수(leakage) 확인
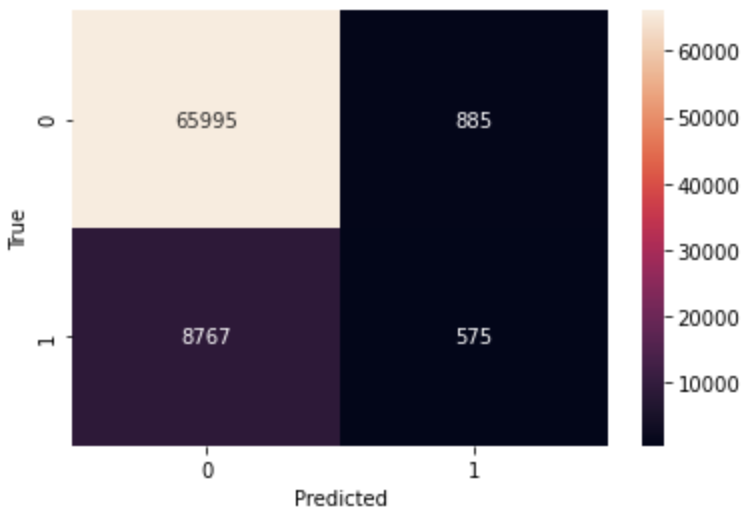
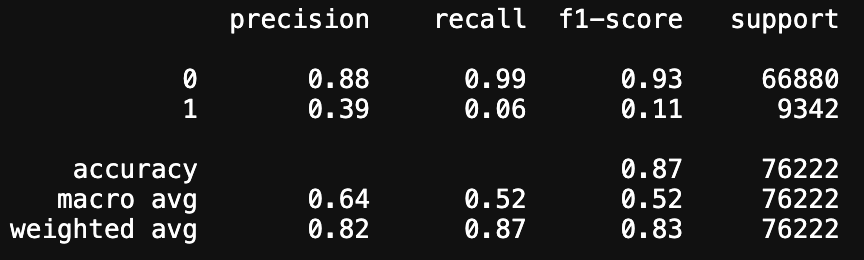
성능이 매우 좋지 못하다. 정보누수가 의심될만큼의 높은점수는 보이지 않기때문에 정보누수는 없다고 판단했다.
# Engineering
```py
def delete(df):
# 카디널리티가 크고, 고유성을 가진 id는 제거
df = df.drop(["id", "Policy_Sales_Channel"], axis = 1)
# 문자열을 숫자로 바꿔주기.
df.loc[(df['Gender'] == "Male"), 'Gender'] = 1
df.loc[(df['Gender'] == "Female"), 'Gender'] = 2
df.loc[(df['Vehicle_Age'] == "< 1 Year"), 'Vehicle_Age'] = 1 # 1년 이하의 차량
df.loc[(df['Vehicle_Age'] == "1-2 Year"), 'Vehicle_Age'] = 2 # 1년이상 2년이하의 차량
df.loc[(df['Vehicle_Age'] == "> 2 Years"), 'Vehicle_Age'] = 3 # 2년 이상의 차량
df.loc[(df['Vehicle_Damage'] == "No"), 'Vehicle_Damage'] = 0 # 과거에 차량에 손상입힌적 없음
df.loc[(df['Vehicle_Damage'] == "Yes"), 'Vehicle_Damage'] = 1 # 과거에 차량손상 입힌적 있음
# 위에서 문자를 숫자로 바꾸어 주었지만 내용만 숫자로 바뀌었을뿐 컴퓨터가 숫자형이라고 인식하지 않기때문에
# 타입도 따로 숫자형이라고 선언해준다.
df["Vehicle_Damage"] = pd.to_numeric(df["Vehicle_Damage"])
df["Vehicle_Age"] = pd.to_numeric(df["Vehicle_Age"])
df["Gender"] = pd.to_numeric(df["Gender"])
# 보험료 이상치 제거
df = df.loc[(df['Annual_Premium'] < np.quantile(df['Annual_Premium'], 0.95)) &
(df['Annual_Premium'] > np.quantile(df['Annual_Premium'], 0.05))]
# 타입변경
df["Region_Code"] = df["Region_Code"].astype(int)
df["Annual_Premium"] = df["Annual_Premium"].astype(int)
return df
train_1 = delete(train)
test_1 = delete(test)
```
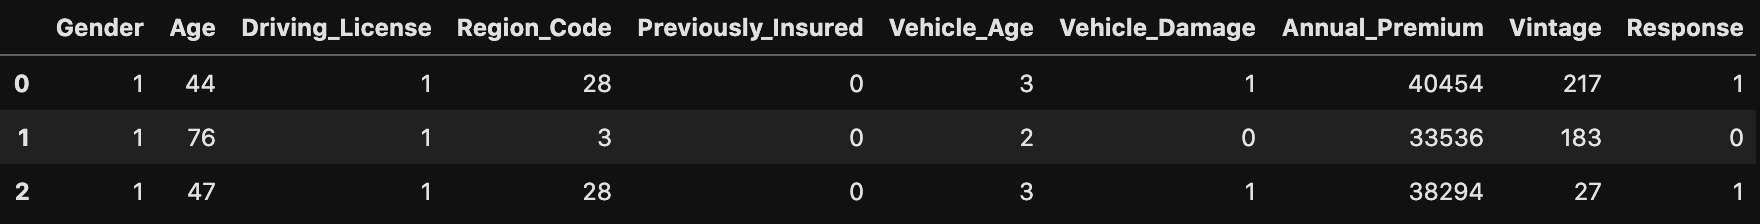
```py
X = train_1.drop([target], axis = 1)
y = train_1[target]
# validation 만들기
from sklearn.model_selection import train_test_split
X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.2, random_state=10)
```
# Modelling
```py
from sklearn.metrics import f1_score
from sklearn.metrics import accuracy_score
# 베이스 모델 생성
# 최빈값
base = train_1[target].mode()[0]
# 예측
y_pred = [base] * len(train_1[target]) # 모두 0으로 예측
print('Base Accuracy :', int(accuracy_score(train_1[target], y_pred).round(2) * 100),'%')
```
최빈값(0)의 분포를 그대로 따라 정확도가 88%가 나왔다. 정확도(Accuracy)평가지표로는 제대로 성능을 평가할수 없기때문에 다른 평가지표를 사용하도록 하고, 평가지표는 f1 score, AUC score를 사용한다.
## Randomforest
```py
pipe = make_pipeline(
OrdinalEncoder(),
StandardScaler(),
RandomForestClassifier()
)
dists = {
'randomforestclassifier__n_estimators': randint(5, 500),
'randomforestclassifier__min_samples_leaf': [None, 10, 15, 20, 30],
'randomforestclassifier__max_depth': [5, 10, 15, 20, None],
'randomforestclassifier__max_features': uniform(0, 1),
'randomforestclassifier__class_weight': [None, "balanced"]
}
# 파라미터를 갱신.
clf = RandomizedSearchCV(
pipe,
param_distributions = dists,
n_iter = 20,
cv = 5,
scoring = "f1",
verbose = 1,
n_jobs = -1,
random_state = 10
)
clf.fit(X_train, y_train)
```
```py
plot_confusion_matrix(y_val, y_pred)
print (classification_report(y_val, y_pred))
```
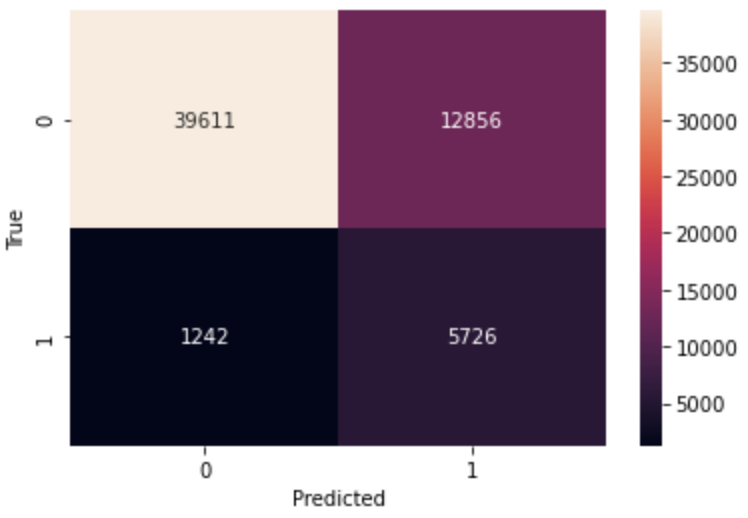
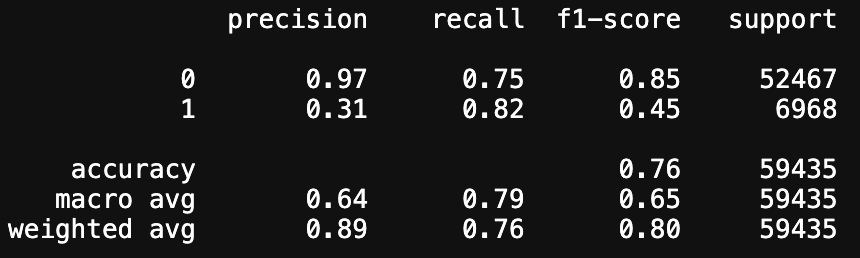
CV를 통해 최적의 하이퍼파라미터값으로 계산했을때 f1 score는 약0.45이다.
### AUC
```py
y_score = clf.predict_proba(X_val)[:,1]
fpr, tpr, _ = roc_curve(y_val, y_score)
plt.title("Random Forest ROC curve: CC Fraud")
plt.xlabel("FPR (Precision)")
plt.ylabel("TPR (Recall)")
plt.scatter(fpr, tpr)
plt.plot((0,1), ls = "dashed",color = "black")
plt.show();
print ("AUC:", roc_auc_score(y_val,y_score))
```
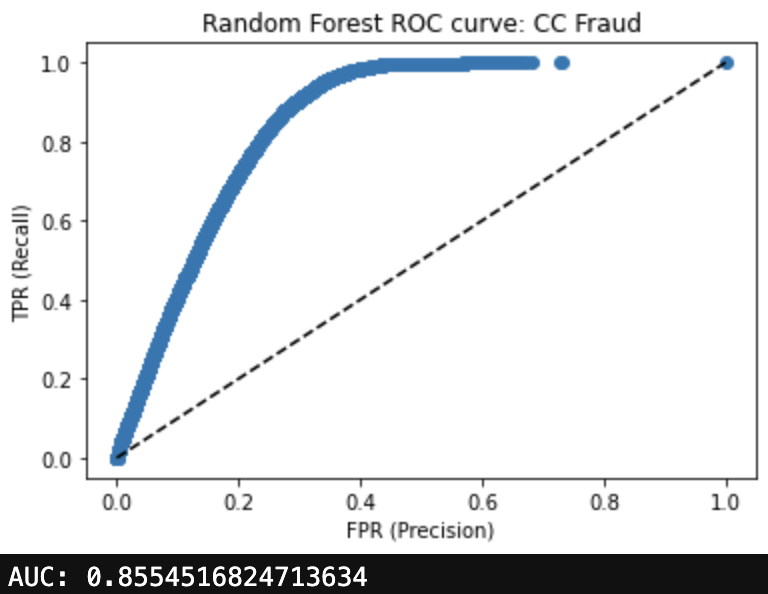
AUC score는 0.855 가 나왔다. 생각보다 학습이 잘 되었다고 생각한다.
이 과정에서 임계값을 조정하여 개선하려 했으나 오히려 점수가 낮아져서 생략하도록 한다.
# Catboost
```py
# 문자형을 숫자형으로 바꿔주는 인코딩. 오디널과 비슷한 인코딩.
from sklearn.preprocessing import LabelEncoder
# train과 test를 한번에 전처리 하기위해 concat으로 한번 합쳐준다.
labelenc = LabelEncoder()
# 새로운 특성을 만들어 train은 1 test는 0을 넣어 데이터를 합쳐준다.
train["is_train"] = 1
test["is_train"] = 0
test["Response"] = None
df = pd.concat((train, test))
print(df.shape)
df.head(2)
```

```py
# 문자형을 전부 숫자형으로 인코딩해준다.
df["Vehicle_Age"] = labelenc.fit_transform(df["Vehicle_Age"])
df["Gender"] = labelenc.fit_transform(df["Gender"])
df["Vehicle_Damage"] = labelenc.fit_transform(df["Vehicle_Damage"])
df["Vehicle_Age"] = labelenc.fit_transform(df["Vehicle_Age"])
df["Gender"] = labelenc.fit_transform(df["Gender"])
df.head()
```
```py
# 위에서 확인할수 있었던 실수형 3가지를 정수형으로 변환해준다.
df["Region_Code"] = df["Region_Code"].astype(int)
df["Policy_Sales_Channel"] = df["Policy_Sales_Channel"].astype(int)
df["Annual_Premium"] = df["Annual_Premium"].astype(int)
```
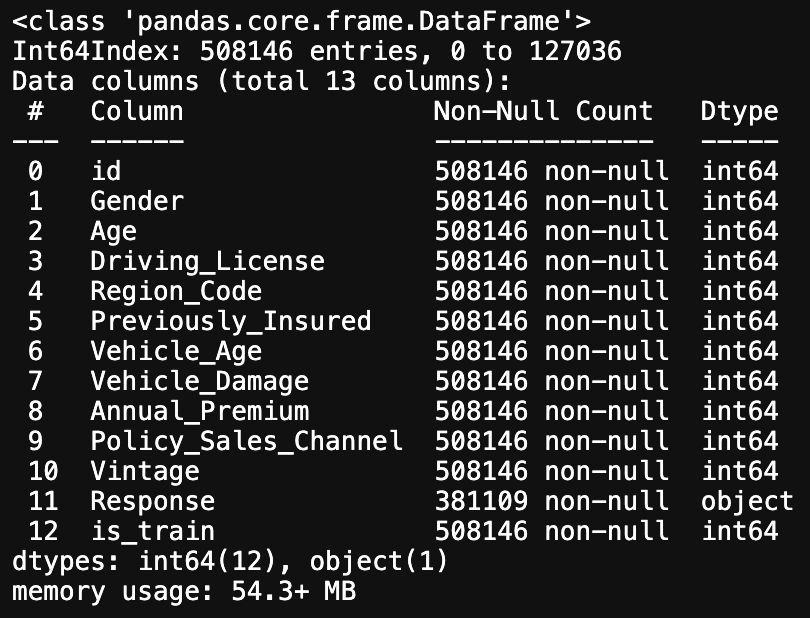
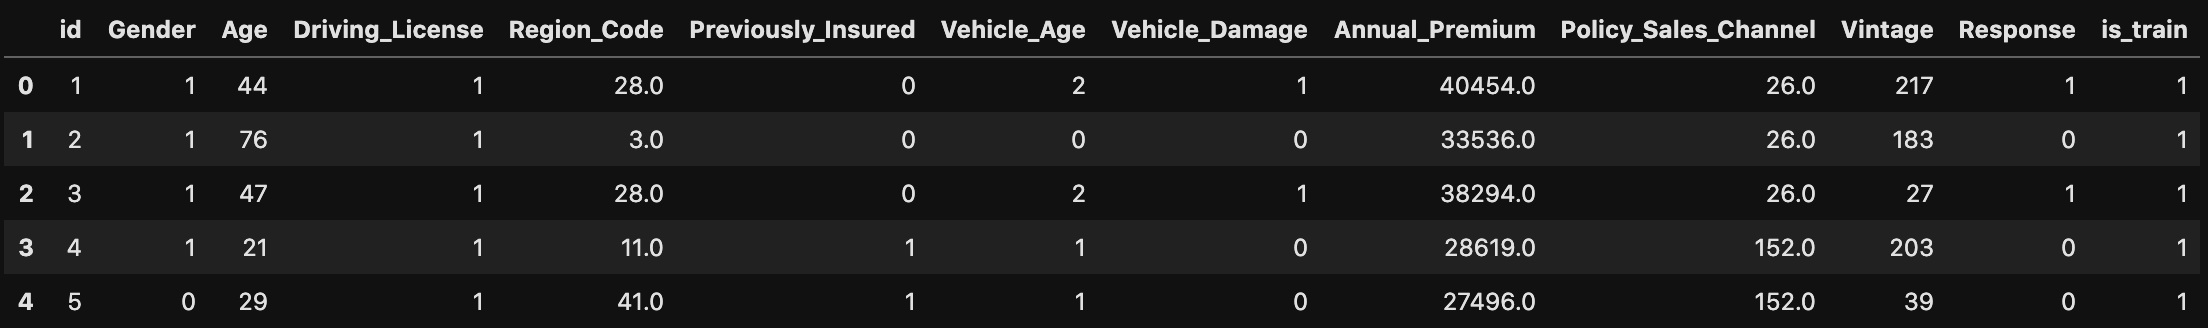
조금뒤에 정수형으로 바꿔줄 타겟값외에 모든값이 정수형이 된것을 확인할수있다.
```py
# 전처리를 마친 train과 test를 다시 나누어주고 타겟값도 정수형으로 바꿔준다.
train = df[df["is_train"] == 1]
test = df[df["is_train"] == 0]
train = train.drop(["is_train"], axis = 1)
test = test.drop(["is_train", "Response"], axis = 1)
train["Response"] = train["Response"].astype(int)
```
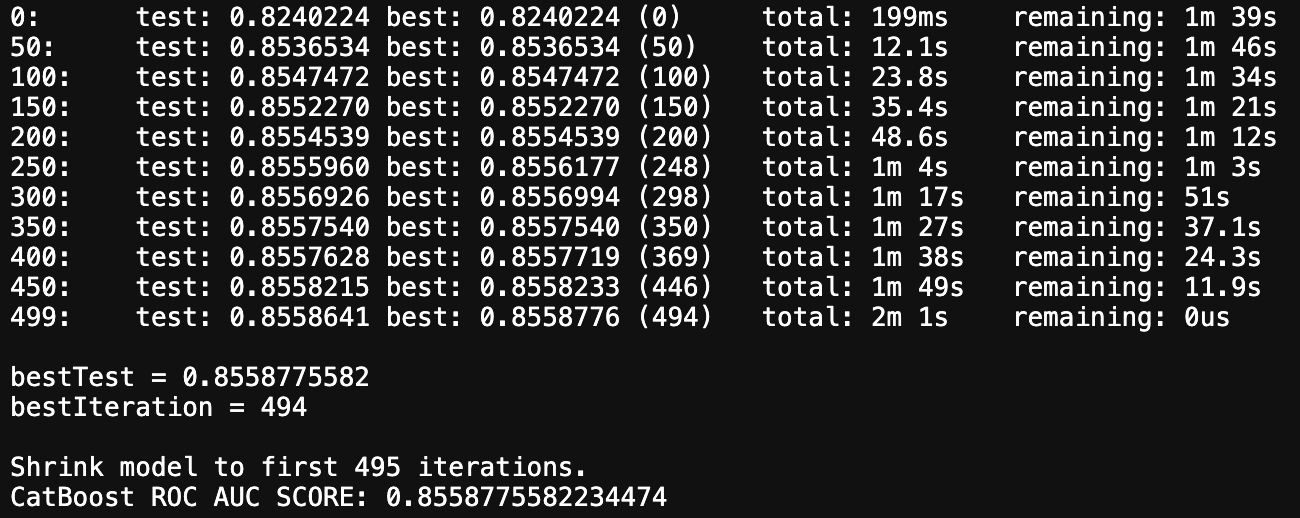
이러한 전처리 부분이 끝나고 바로 모델을 만들어 실행해 보았다.
이때 위의 Randomforest와 iterations값을 동일하게 500으로 맞추어보았다.
파라미터들은 다르지만 같은 범위안에서 얼마나 다른 정확성을 보이는지 보고싶었다.
```py
cat_1 = CatBoostClassifier(learning_rate=0.03, l2_leaf_reg=1, iterations= 500,
depth= 9, border_count= 20,eval_metric = 'AUC')
cat = cat_1.fit(X_train, y_train, cat_features = features,
eval_set = (X_val, y_val),early_stopping_rounds=70,verbose=50)
pred_proba = cat.predict_proba(X_val)[:, 1]
print('CatBoost ROC AUC SCORE: {}'.format(roc_auc_score(y_val, pred_proba)))
```
```py
plot_confusion_matrix(y_val, y_pred)
```
```py
print (classification_report(y_val, y_pred))
```
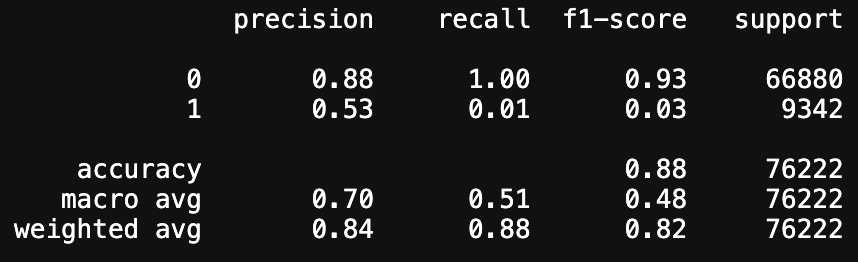
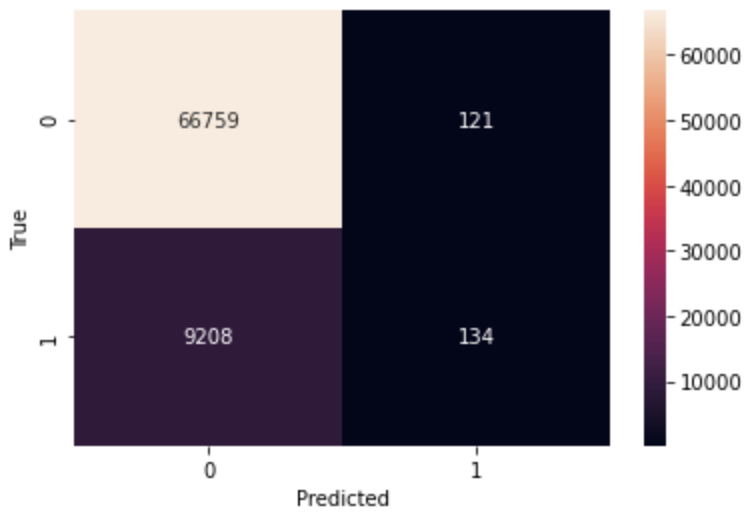
정확성은 눈에띄게 높아졌으나, 재현율과 f1 score가 심하게 낮아졌다.
```py
y_score = cat_1.predict_proba(X_val)[:,1]
fpr, tpr, _ = roc_curve(y_val, y_score)
plt.title("Catboost ROC curve: CC Fraud")
plt.xlabel("FPR (Precision)")
plt.ylabel("TPR (Recall)")
plt.scatter(fpr, tpr)
plt.plot((0,1), ls = "dashed",color = "black")
plt.show();
print ("AUC:", roc_auc_score(y_val,y_score))
```
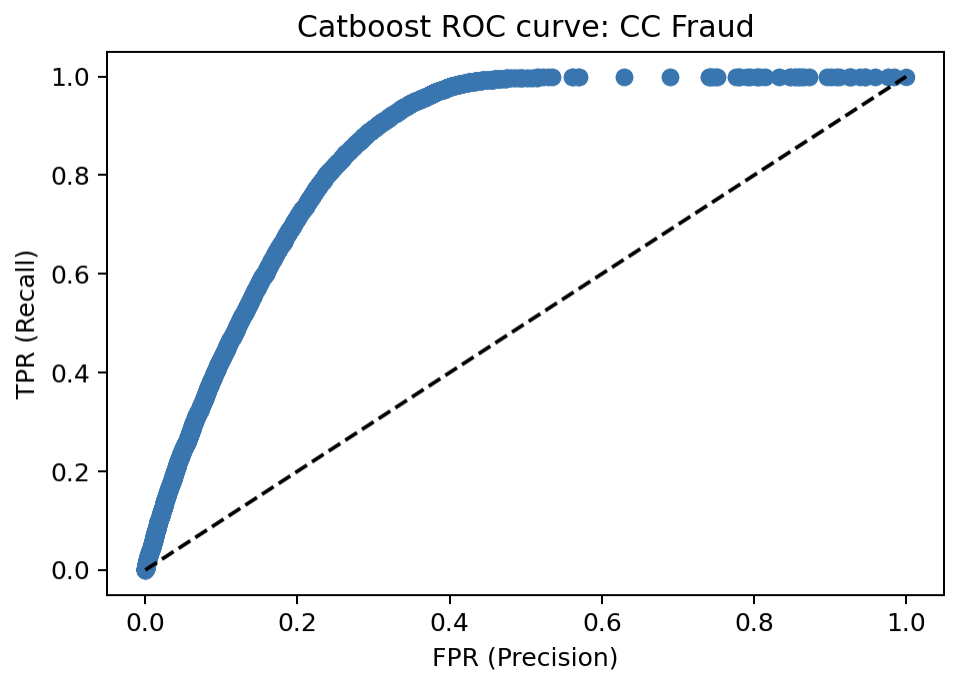
# PDP
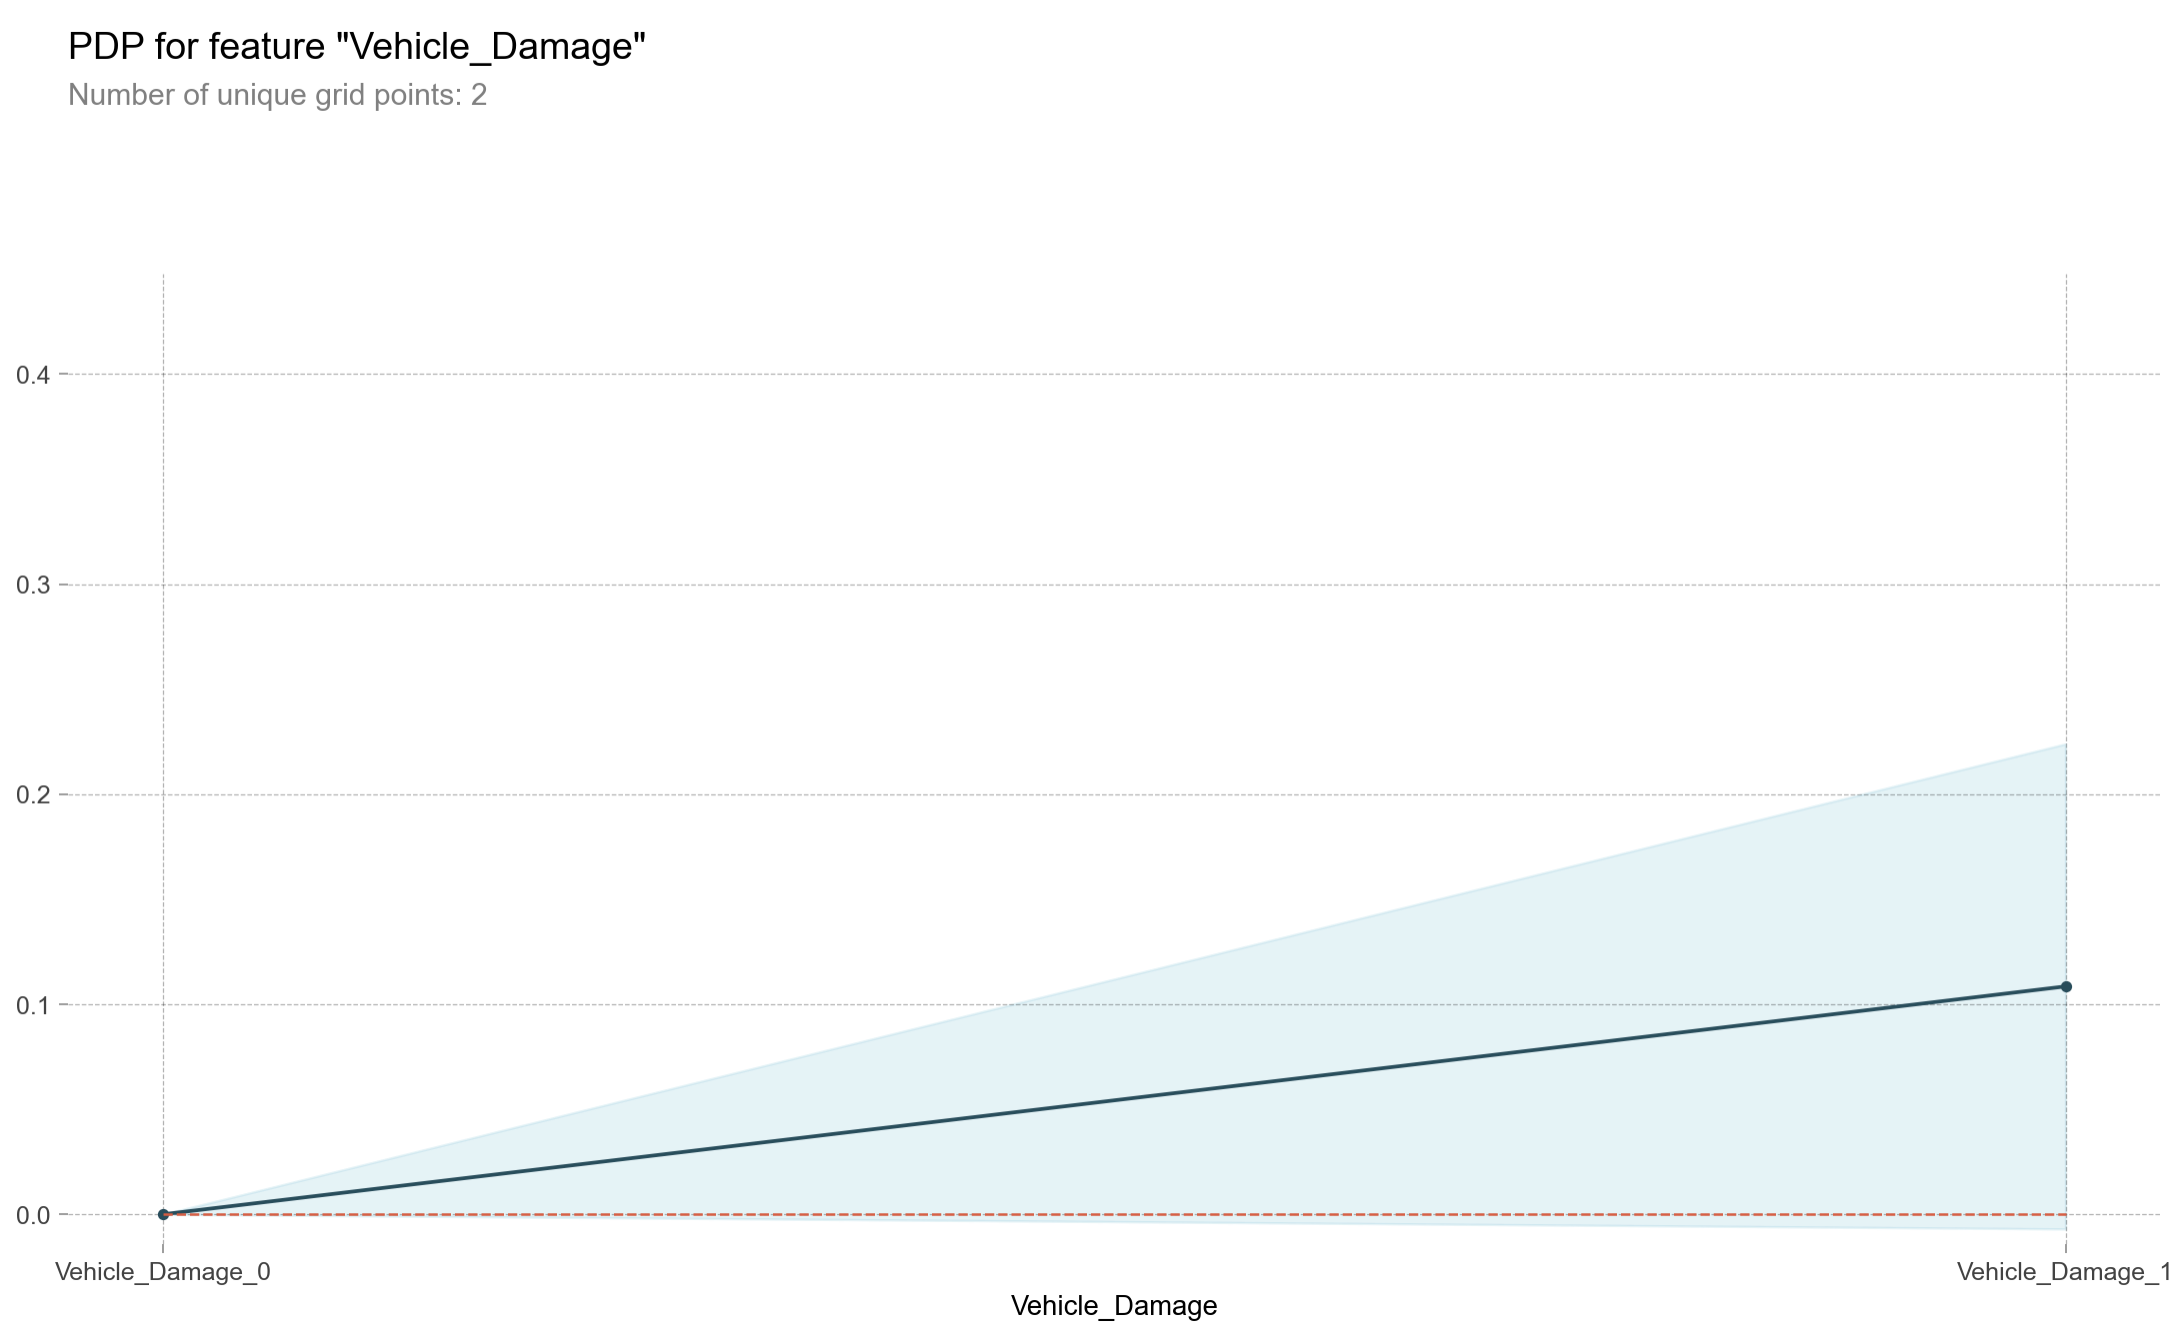
과거에 차를 손상시킨 경험이 없는고객부터 손상시킨 경험이 있는 고객으로 점점 관심도가 높아지는것을 알수있다.
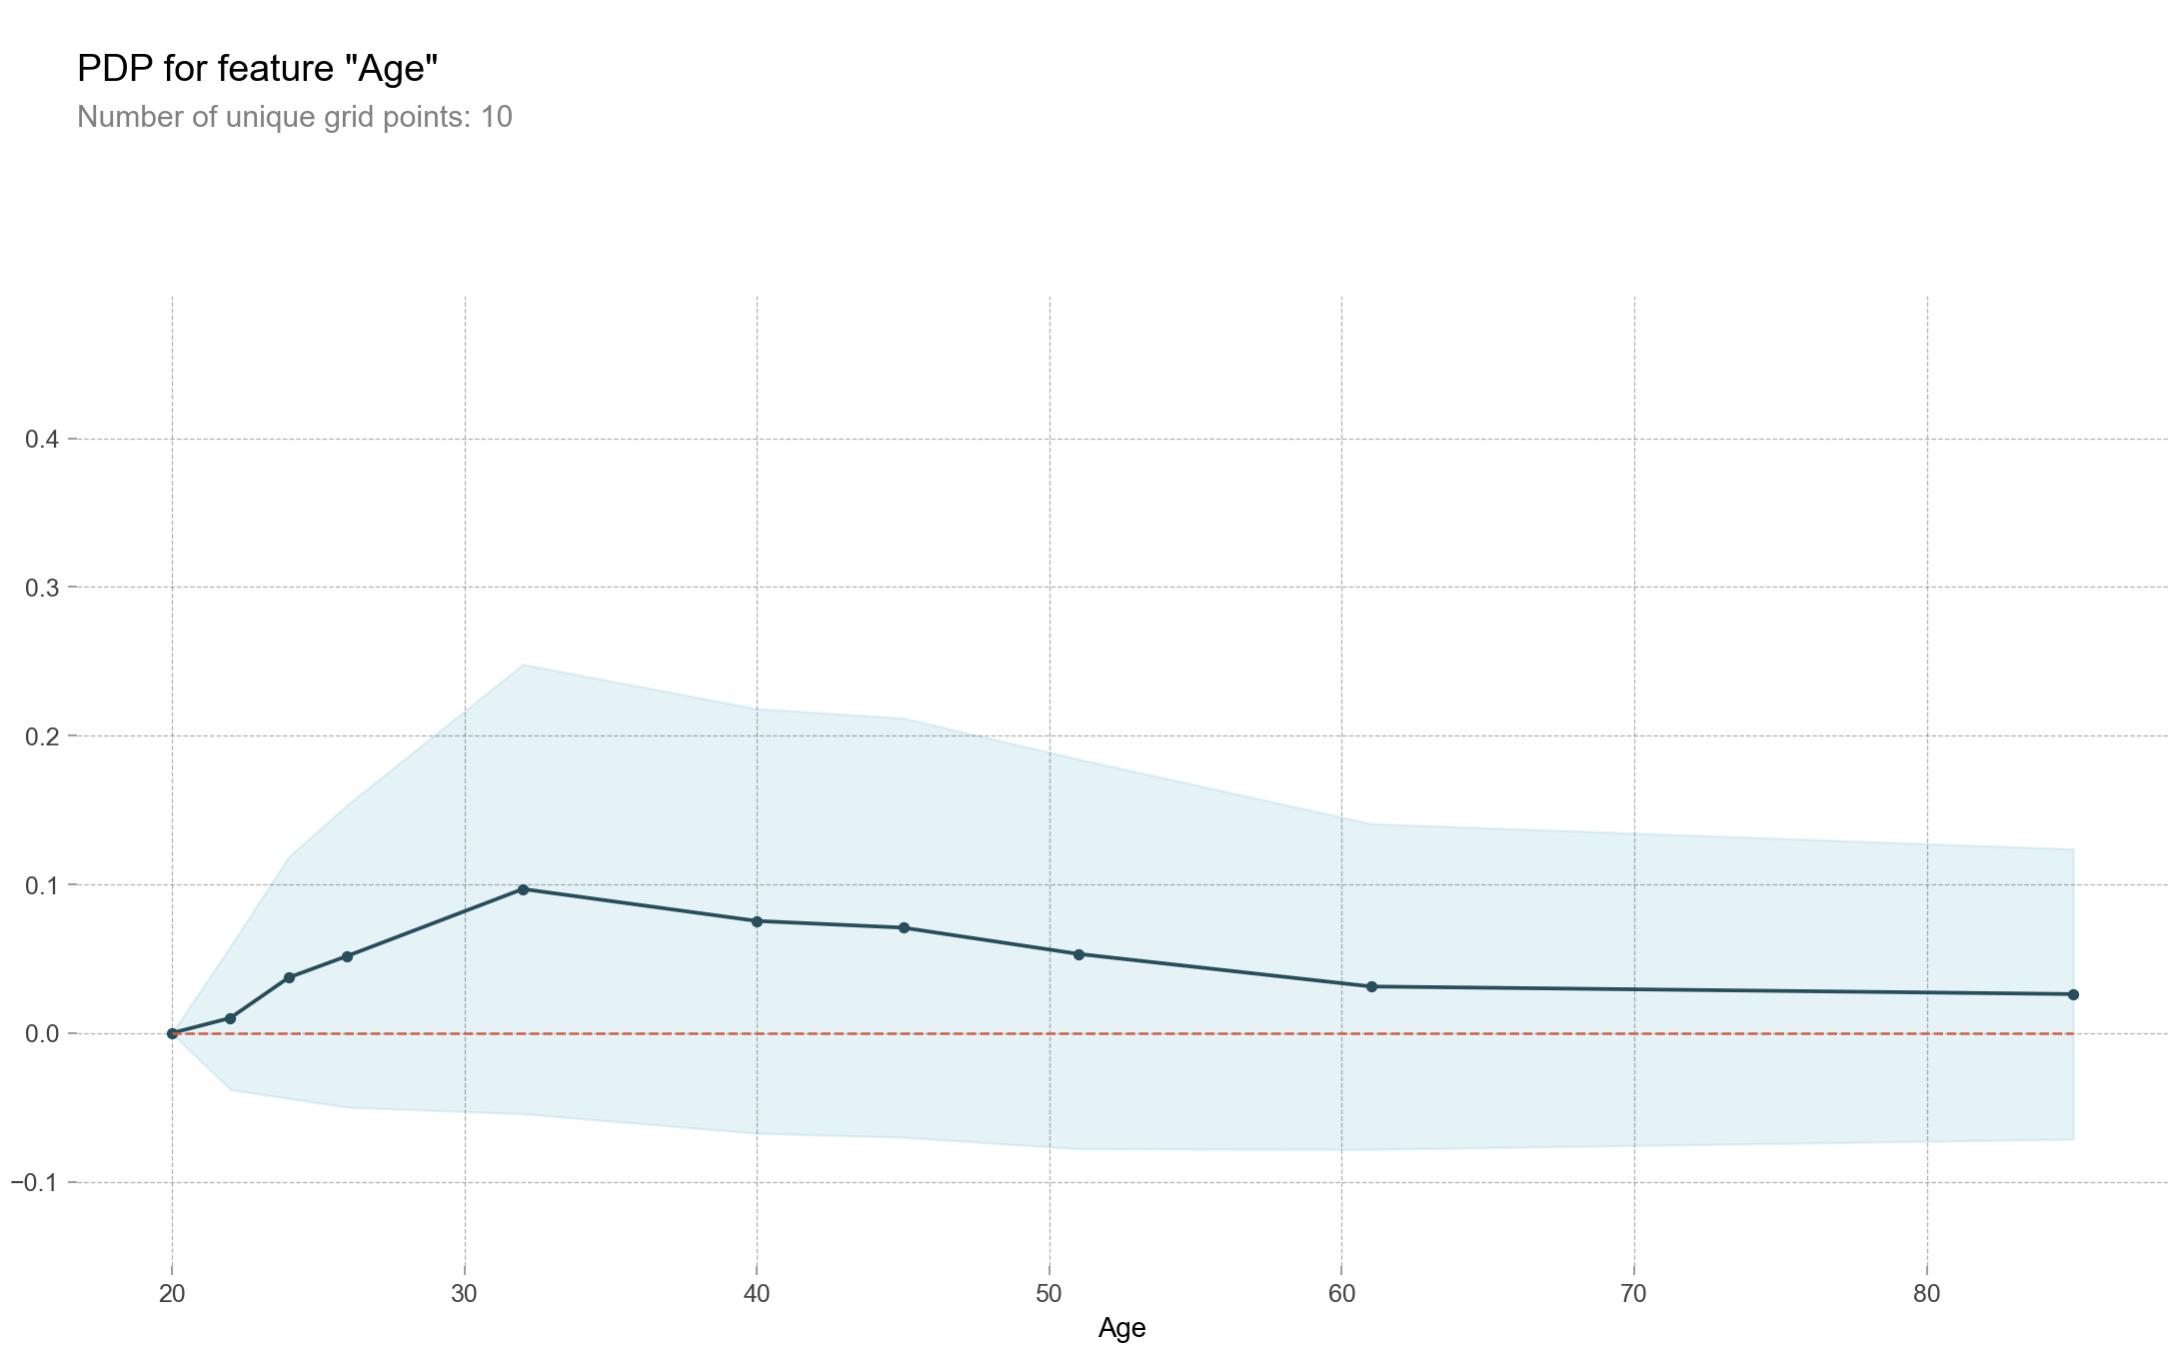
20대부터 30대 초반까지는 관심을 가지는 사람이 증가하다가 30대 중반부터 관심이 줄어든다.
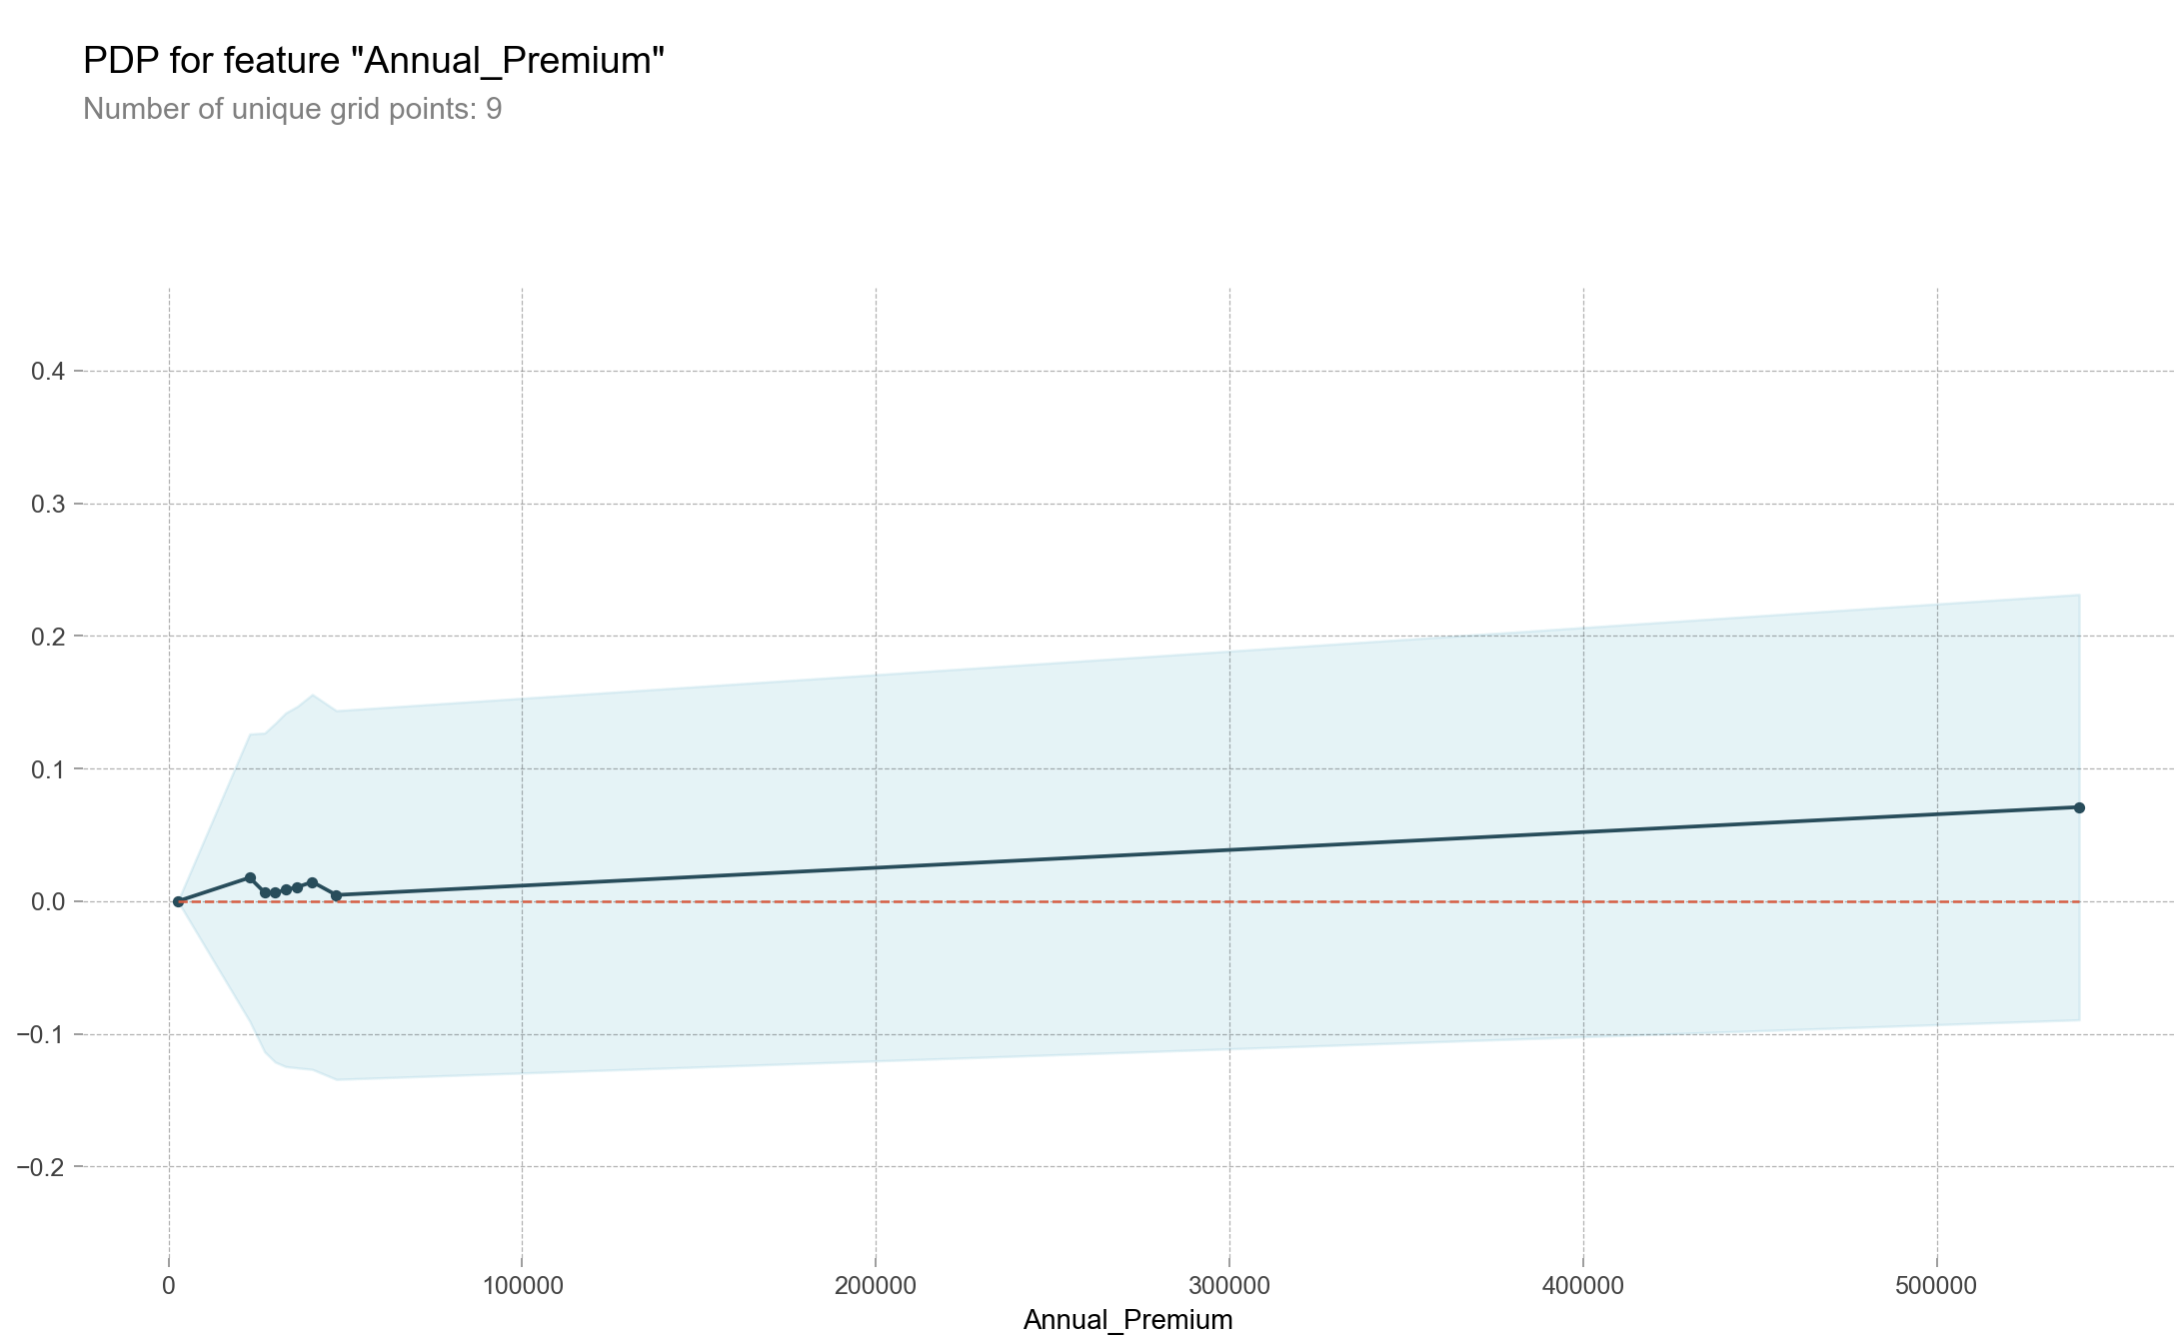
연간 보험료를 많이 내는 사람일수록 관심을 가지는것을 알수있다.
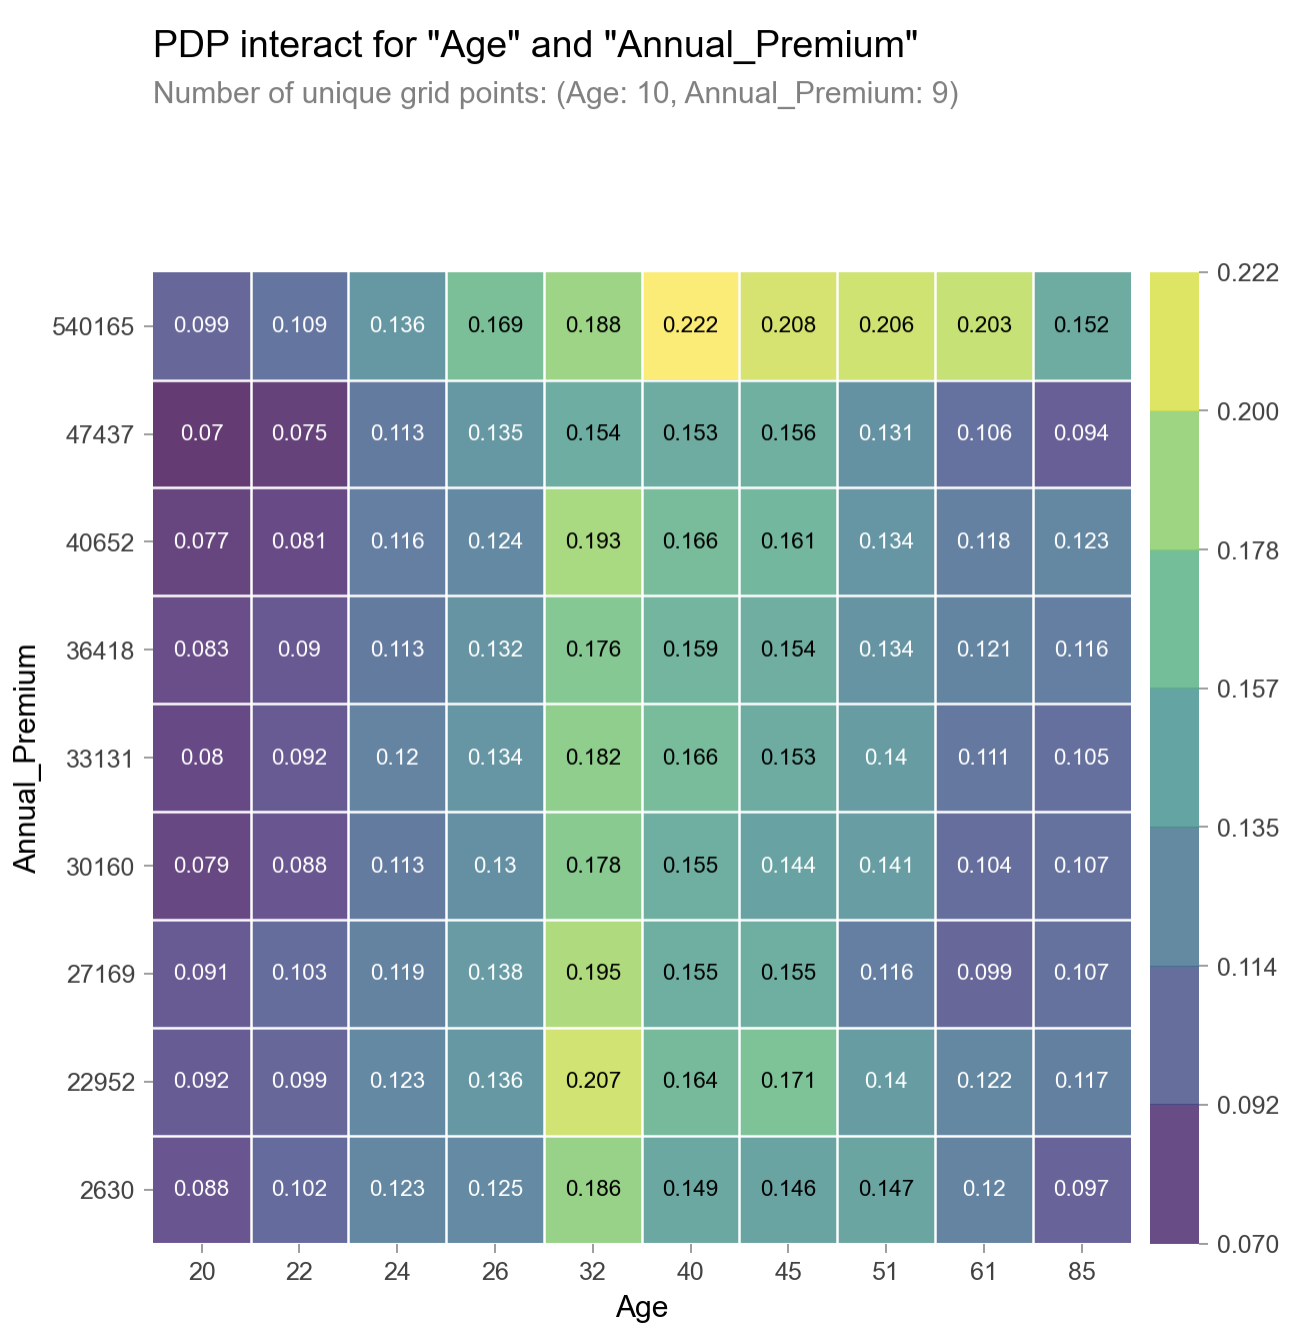
위에서 확인했던 보험료를 많이 지불하는 사람일수록 자동차 보험에 관심을 가질 확률이 높은것을 확인했는데 이 표를 보면 32세부터 61세가 보험료를 가장 많이 내는것을 알수있다.
이 모델은 고객의 정보만을 가지고있을때는 충분히 도움이 될수있지만, 지금과같이 관심이 있는지 없는지에 대한 정답을 알고있는 상태에서 예측하기에는 크기가 작은 클래스의 데이터양이 너무 적어서 참고용으로는 사용할수있으나, 결과값을 신뢰하여 고객에게 연락을 한다면 엉뚱한 고객에게 연락을 할 가능성이 있다. 조금더 깊이 파고들어 잘 다듬으면 충분히 신뢰할수있는 데이터가 될수도 있지만, 지금의 결과로는 의심스럽다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.