codestates / codestates/ds-blog
[김지연]스타트업 생존 예측하기(solo project 02)
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
들어가며
---
지금은 스타트업 시대다. 정부에서는 창업을 지원하고 많은 사람들이 기발한 아이디어를 들고 사업에 뛰어든다. 하지만 스타트업의 10%만이 살아남는다고들한다. 이러한 이유로 스타트업에 투자를 하는 벤처 캐피털리스트와 그 외 수많은 투자자들이 스타트업이 살아남을지를 어떨지를 예측할 수 있는 모델을 쓸 수 있어서 폐업할 것 같은 회사의 투자를 피할 수 있다면 유용하지 않을까 싶어 모델을 만들어 보았다.
데이터
---
이러한 모델을 만들어 보기 위해 캐글에서 스타트업이 받은 투자금액, 종류 등이 나와있는 데이터를 받아왔다.
아래는 이름과 같은 고유값을 제외한 스타트업 데이터의 열(특성)들이다.
1. Category List : 세부 사업분야
2. Market : 주 사업분야
3. Funding Total USD : 총 투자 금액(USD)
4. **Status : 운영 여부** (acquired, operating, closed) **타겟 컬럼**
5. Contry Code : 국가 코드 ex. USA
6. Region : 국가 지역 ex Illinois
7. City : 도시 ex. Champaign
8. Funding Rounds : 투자 받은 횟수
9. Founded At, Founded Month, Founded Quarter, Founded Year : 설립 날짜, 월, 분기, 연도
10. First Funding At, Last Funding At : 첫 투자 날짜와 마지막 투자 날짜
11. Seed, Venture, Equity Crowdfunding, Undisclosed, Convertible Note, Debt Financing, Angel, Grant, Private Equity, Post IPO Equity, Post IPD debt, Secondary Market, Product Crowdfunding, Round A-H : 받은 투자 종류(채권,주식,부채 등)
이 컬럼들 중 회사의 지속 여부를 판단하기 위해, 특히 폐업 했는지 여부의 예측을 위해 위 타겟 컬럼을 Status로 설정하여 분류모델을 만들어 볼 것이다.
데이터 전처리
---
데이터를 모델에 돌려보기 전 모델이 데이터를 잘 소화시키기 위해 데이터를 손질해주는 과정이 필요하다.
첫 번째로 확인해본 것은 데이터의 결측치 여부였다. Pandas Profiling을 통해 데이터를 확인해본 결과 4856개의 결측치(NaN)로만 채워진 행이 4856개가 있어 이 행을 먼저 제거했다.
두 번째로 국가 정보를 제외한 스타트업의 지역 정보를 담고 있는 열(특성)인 Region, City 두 가지를 미국 외 지역의 경우 NaN값이 많고 국가 정보만으로도 충분하다고 판단하여 제거하였다.
그리고 세 번째로 스타트업의 지속여부를 예측해보는 모델이기 때문에 Status 열이 결측치인 NaN값으로 채워진 행을 제거하였다.
다음으로 창립일인 Founded At 열을 제외한 날짜 정보 열들을 제거하여 중복된 열들이 없도록 했다.
마지막으로 이상치를 제거하였는데 총 투자 금액의 경우 최대 금액의 75%이상인 값들을 제거하였다.
특성 공학
---
데이터를 손질하며 기존의 데이터를 이용해 우리가 필요로 하는 정보들을 만들 수도 있는데 이를 특성 공학(Feature Engineering)이라고 한다. 이 데이터를 이용해 만들어 본 특성은 총 세 가지이다.
1. 총 펀딩 횟수(n_fundings) : 이미 Funding Rounds라는 총 투자횟수 열이 있지만 확인해본 결과 받은 투자의 횟수와는 다른 경우가 있어 Fundings Rounds 열을 제거하고 총 펀딩 횟수를 보여주는 열을 새로 만들었다.
2. 총 펀딩 금액(total_fundings) : 총 투자 금액을 보여주는 Funding Total USD 열도 부정확한 경우가 있어 투자 종류 별로 받은 금액을 합쳐 총 펀딩 금액 열을 만들었다.
3. 투자 받기까지 걸린 기간(days_for_funding) : 마지막으로 만든 열은 회사를 설립하고 투자를 받기까지 걸린 기간을 계산한 열이다. 이 열의 경우 투자를 처음 받은 날짜가 설립 날짜보다 앞서는 경우 제거하고 투자 받은 날짜가 설립 날짜와 같거나 이후인 경우만 남겨두었다.
4. 기업 운영 여부(status) : 이 열의 경우 이미 존재하지만 인수와 운영 중인 상태를 생존하였다고 판단하여 1로 바꾸고 더 이상 운영하지 않는 경우 0으로 바꾸었다.
데이터 탐색
---
특성공학을 마무리 하고 데이터가 어떤 모양을 하고 있는지 확인해보도록 한다.
가장 처음으로 운영상태(status)열의 클래스의 분포를 확인해야한다.
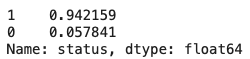
클래스 1은 94.3% 클래스 0은 5.7% 비율로 이뤄진 불균형한 분포를 보인다.
다음으로 어떤 나라에서 스타트업이 많이 생겨났는지 확인해봤다.
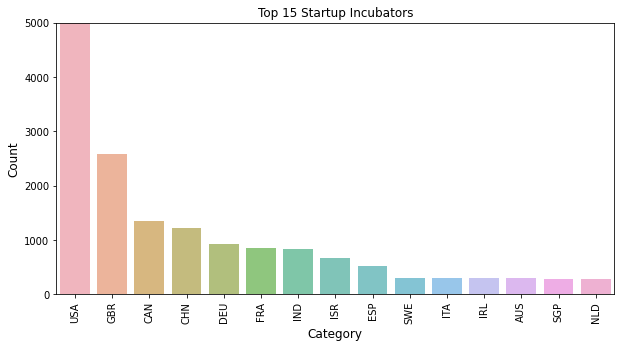
미국의 경우 스타트업이 25000개 이상이어서 다른 나라의 스타트업 갯수가 확인이 어려워 y축 최대치를 5000으로 제한하여 다른 나라들의 모습을 좀 더 확인하기 편하게 했다.
상위 15개 국가 그래프를 보면 미국이 압도적으로 많고(25000개 이상) 그 뒤론 영국과 캐나다가 있어 주로 영미권 국가에서 스타트업이 활발하게 만들어졌음을 확인할 수 있다. 그리고 중국, 인도, 이스라엘, 싱가포르를 제외하면 상위 15개 국가 중 11개가 영미권 혹은 서구 문화권의 나라들이다.
그렇다면 이 스타트업들은 어느 분야에서 활발하게 사업을 하고 있는지 확인해보자.
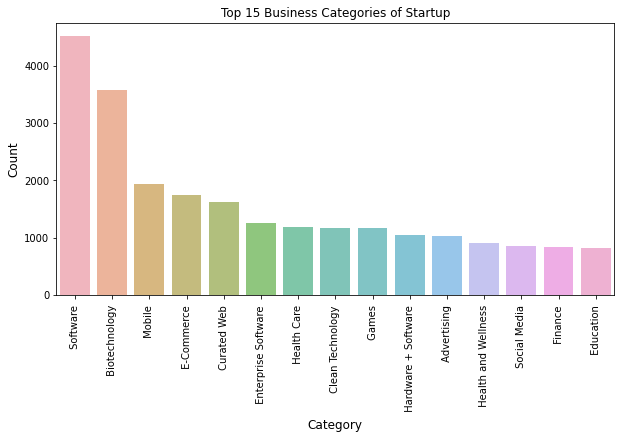
상위 15개 스타트업 사업 분야 그래프를 보면 소프트웨어, 모바일, E-커머스 등 우리가 일상에서 밀접하게 사용하는, 기술들이 굉장히 중요한 사업 분야라는 것을 알 수 있다.
다음으로는 가장 궁금할 수 있는 총 투자 금액이다.
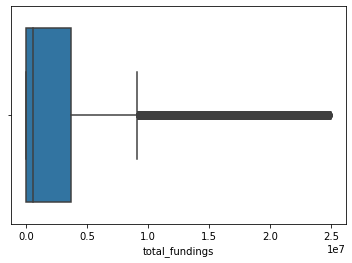
그래프를 보면 0에서 10,000,000달러(11,275,100,000원, 약 112억 원)까지를 일반적인 수준으로 보고 이 수치를 초과하는 것은 이상치로 본 것을 확인할 수 있다. 하지만 112억 원 이상을 투자 받은 경우도 많다는 것을 볼 수 있다.
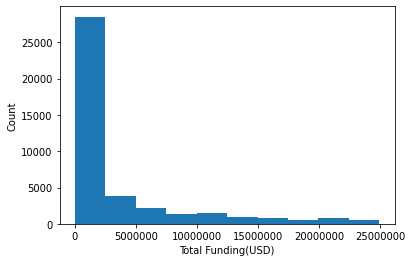
총 투자 금액의 분포를 확인해 보면 대부분이 250,000달러 이하의 펀딩을 받았지만 이보다 훨씬 큰 금액의 투자도 많이 이뤄졌음을 볼 수 있다.
마지막으로 어떠한 특성을 통해 타겟을 유추할 수 있는지 여부(데이터 누수가 있는지 여부)를 생각해보았다. 이 경우 날짜 데이터는 투자 받은 날에 대한 것이고 투자의 금액이나 종류로 타겟값을 예측하긴 어려울 것 같다는 생각이 들어 데이터 누수는 없다고 판단했다.
모델 만들기
---
### 기준 모델
본격적으로 성능이 좋은 분류모델을 만들기 전에 모델 성능 평가의 기본이 되는 모델을 만들었다. 결정 트리(의사결정나무, Decison Tree)를 만들어 내 모델의 베이스라인(나중에 모델 성능을 평가할 때 성능이 이정도는 넘어야 한다라고 정해주는 것)을 정했다. 일단 결정트리로 모델을 만들어 얼마나 운영 상태를 잘 맞췄는지 확인해보았다.
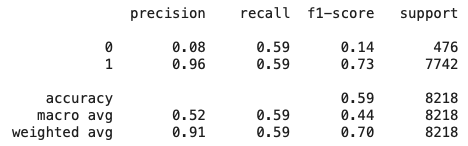
첫 번째 모델 평가지표는 precison 점수이다. 이 표에서 주목해야할 점은 클래스 0(폐업한 상태)의 precision 숫자이다. 앞서 말했듯 내가 중점을 둔 부분은 회사가 폐업했는지를 잘 예측할 수 있느냐이다. 여기서 정밀도(precision)은 폐업이라고 예측한 경우 중 실제로 폐업을 한 것을 얼마나 잘 맞췄느냐를 말해주는 숫자이다. 내가 투자자라면 폐업이라고 예측했는데 실제론 운영을 계속 해서 좋은 투자 기회를 놓치는 것이 아쉬울 것 같아서 정밀도 점수를 확인할 것이다.
정밀도 점수를 설명하자면 0인 경우 하나도 맞추지 못한 것이고 1일 경우 완벽하게 예측을 한 것이다. 우리의 기준 모델의 경우 0.08로 형편없는 예측을 했다고 볼 수 있다.
두 번째 모델 평가지표는 분류모델의 전반적인 점수를 측정하는 AUC 점수이다. 이 평가지표는 임계값에 따라 분류모델이 어떤 성능을 보여주는지 확인할 수 있는 ROC 곡선에서 파생된 점수이다. AUC 점수는 0.5에서 1사이의 숫자로 1이면 분류모델이 완벽한 예측을 한 것으로 보면 된다.
- AUC score: 0.6154019926234507 결정트리의 AUC 점수로 이보다 높은 점수를 얻을 모델을 만드는 것이 목표다.
본격적으로 모델을 만들기 전 이 데이터의 경우 클래스 1(운영 중인 경우)이 약 94%을 차지하는 굉장히 불균형한 데이터이다. 그렇기 때문에 나머지 약 6%를 예측하는데 있어서 클래스가 0인 데이터가 너무 적기 때문에 클래스 1, 0의 비율을 5:5로 맞춰주는 imbalanced learn 라이브러리를 사용했다.
### 모델과 성능
만들어 본 모델은 총 두 가지로 앙상블 모델인 XGBoost와 Random Forest를 이용했다. 모델의 세부 사항을 정해주는 하이퍼 파라미터들의 경우 RandomizedSearchCV를 이용해 최적의 하이퍼 파라미터를 찾아 적용했다.
두 모델 모두 수 많은 결정트리를 모아 집단지성을 발휘해 결정을 내리는 앙상블 모델이다. XGBoost의 경우 하이퍼 파라미터를 잘 사용하면 Random Forest보다 성능이 잘 나오지만 그렇지 못하면 랜덤포레스트에 비해 좋은 성능을 보여주지 못한다.
내가 만든 XGBoost 모델은 Random Forest보다 아주 조금 우세한 성능을 보여 XGBoost 모델을 test 세트에 적용했다.
### 모델 평가
성능이 잘 나온 XGBoost의 정밀도 점수를 확인해보자.
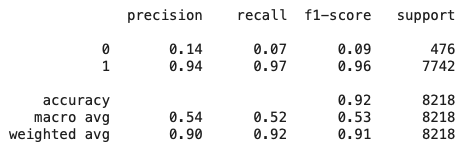
첫 번째로 목표로 했던 클래스 0의 정밀도 점수는 0.14로 베이스라인인 0.08보다 크게 올랐다. 하지만 실제로 폐업한 경우 중 모델이 폐업한 것을 맞춘 것을 비율을 보여주는 재현율(recall) 점수는 0.07로 형편없는 점수가 나왔다. 그 이유를 생각해보면 모델이 0으로 예측을 너무나 적게 해서 이런 점수가 나온게 아닐까 싶다.
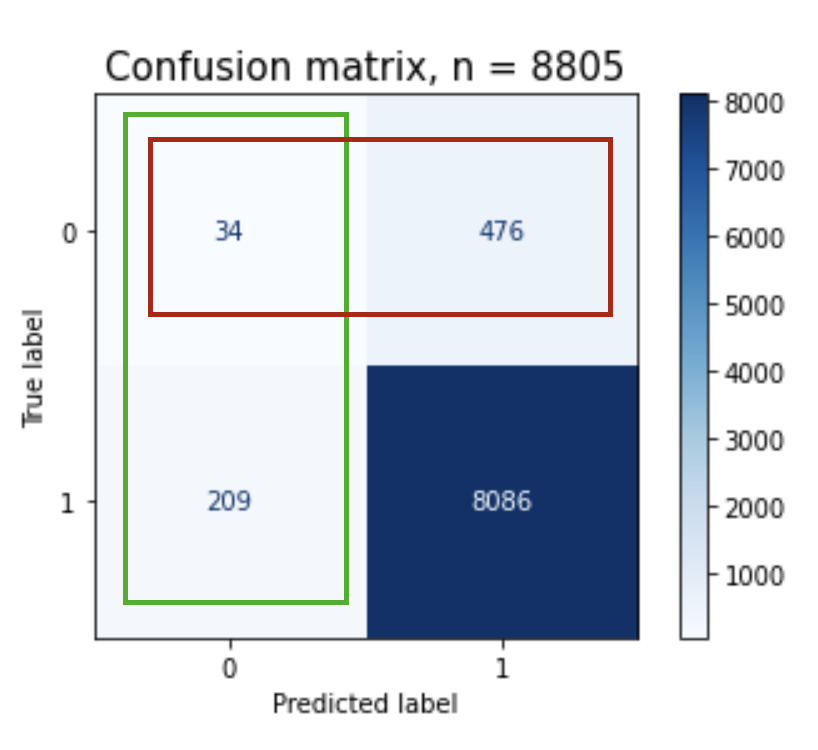
이 그림(confusion matrix)을 보면 빨간 테두리가 재현율, 초록 테두리가 정밀도이다. 위에서 말한 재현율을 확인해보면 실제(True Label)론 0인데 1으로 예측(Predicted Label)한 경우가 많다는 것을 볼 수 있다. 달리 말하면 폐업했지만 모델은 운영중이라고 판단한 숫자이다.
두 번째 평가지표인 AUC 점수를 확인해보자.
- AUC score: 0.6459174990068359
이는 결정트리의 점수 0.615에서 소폭 높아진 값으로 임계치를 조정을 통해 더 나은 예측을 할 수 있지 않을까 싶다.
특성 중요도
---
특정한 특성을 안씀으로써 그 특성이 모델의 성능에 얼마나 영향을 주는지 알려주는 Permutation Importance를 통해 어떤 특성이 모델 성능에 영향을 많이 주는지 확인해봤다.
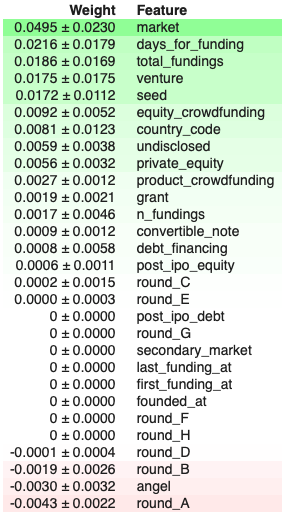
이 표를 보는 방법은 숫자가 높을수록 성능에 영향을 많이 준다는 뜻이고 음수인 경우 없는 게 더 도움이 된다는 뜻이다.
가장 중요한 특성은 어떤 분야에서 사업을 하는지였고 두 번째는 투자를 받는데 까지 걸린 기간이 중요하다는 것을 확인할 수 있다. 그에 반해 받은 투자 종류는 크게 중요치 않다.
사업분야가 중요한 이유를 추측해보자면 아무래도 좀 더 사람들이 많이 사용하는 분야(ex.소프트웨어,게임, E-커머스 등)에서 사업을 하는 것이 스타트업의 생존율에 영향을 끼칠 것 같아서가 아닐까 싶다.
모델해석 (PDP, SHAP value)
---
### PDP
PDP(부분의존도그림, Partial dependence plots)는 모델이 예측을 할 때 각 특성의 값에 따라 예측에 어떤 영향을 끼치는지 알려주는 그래프로 모델을 해석하는 대표적인 방법 중 하나이다.
한 번에 한두개의 특성의 영향을 볼 수 있기 때문에 내가 만든 특성 중 특성중요도가 높게 나온 두가지를 확인해 보려고 한다.
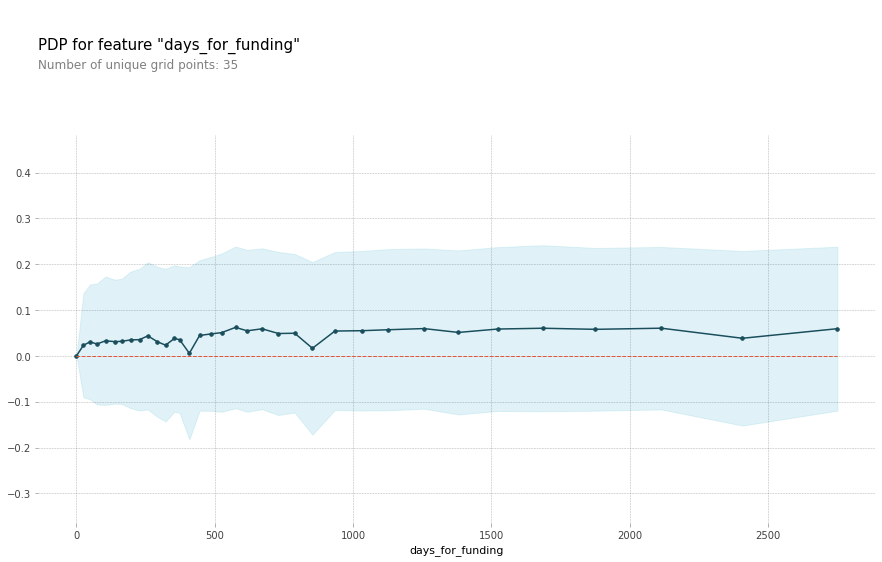
투자 받기까지의 기간(days_for_funding)을 먼저 보면 중간 중간 0에 가까운 지점들을 제외하곤 1400일 정도까지는 클래스 1로 예측하는데 확률을 높인다. 1400일 이후로는 큰 변화가 없다.
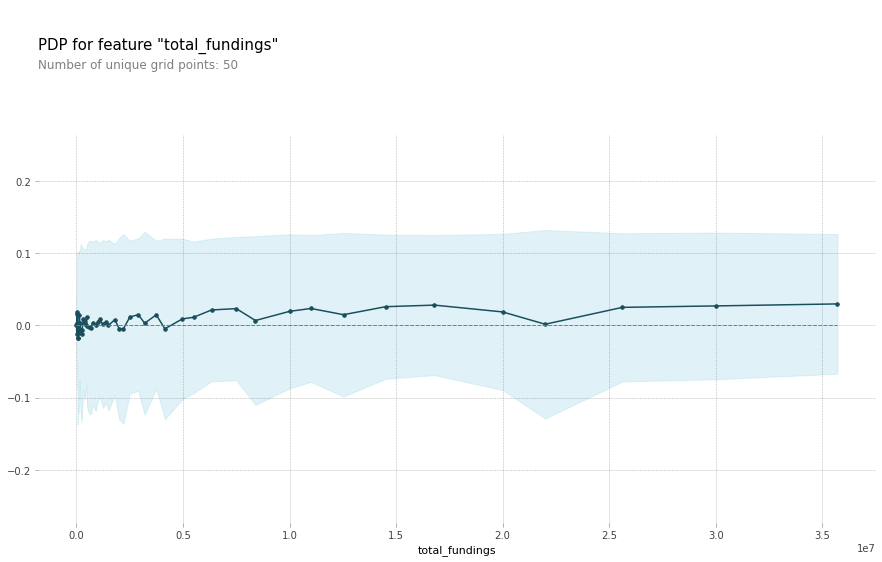
다음은 총 투자금액(total_fundings)이다. 그래프를 보면 5,000,000 달러까지는 굉장히 변동이 커서 투자금액이 많아질수록 클래스 1로 예측할 확률이 높아지거나 낮아지거나 하는 관계는 찾을 수 없다. 5,000,000 달러 이후로는 대체로 투자금액과 상관없이 예측에 비슷한 영향을 끼치는 것으로 보인다.
### SHAP Value
SHAP 라이브러리는 하나의 관측치(한 회사)의 예측에 어떤 특성들이 영향을 끼쳤는지 알아볼 수 있게 해주는 shap values를 계산해주는 라이브러리다. 이 기능을 통해 모델이 한 관측치를 왜 1이나 0으로 예측했는지 알아볼 수 있다.
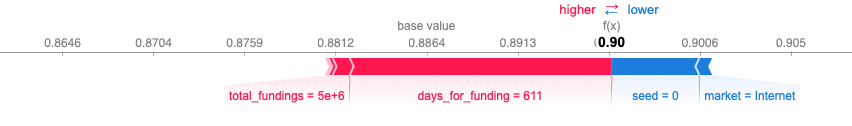
이 그래프를 확인해 보면 이 회사의 경우 총 투자금액과 투자 받기까지 걸린 기간 두 가지가 모델이 회사가 운영 중이라고 예측할 확률을 늘렸다. 그에 반해 seed 투자(사업 초기에 투자 받는 돈으로 사업 시작을 도와주는 씨앗 같은 존재)가 없던 것이나 사업분야가 인터넷인건 모델이 회사가 운영 중이라고 예측할 확률을 줄였다.
한계
---
실제로는 많은 스타트업이 폐업하는데 이 데이터의 대부분의 스타트업은 생존했다. 그런 점에서 현실의 스타트업 생존율을 반영하지 못한 데이터일 수 있다. 또한 단조로운 특성들로 인해 모델이 운영 여부를 예측하는데 있어 어려움이 있지 않았을까 생각이 든다.
[노트북](https://github.com/kk00b/blogging/blob/master/Jiyeon_kim_project_2.ipynb)
[캐글 스타트업 데이터](https://www.kaggle.com/arindam235/startup-investments-crunchbase)
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.