codestates / codestates/ds-blog
[송지] 좋은 와인을 결정하는 성분은 무엇일까?
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
대사관에서 근무할 때, 관저 오·만찬 행사를 매니징하는 것이 주요 업무였다.
말단인 내가 대사님을 직접 마주하는 일은 식사 메뉴보여드리고 와인 선택을 요청드릴때다.
식사는 관저 요리사의 재량이었지만, 와인만큼은 대사님이 고르셨다.
처음으로 맡은 업무를 잘해보고 싶은 마음에 그때부터 불가리아산 와인을 한병씩 사 마시기 시작했다.
화이트 와인 중 샤르도네와 소비뇽블랑의 맛의 차이를 처음 느꼈다. (내 취향은 샤르도네..🥂)
그러나 약간의 떫은 맛 혹은 어딘가 모르게 무거은 맛이 나는 레드와인은 여전히 어려운 세계다.
이번 프로젝트에서 레드와인의 성분과 퀄리티 정보가 들어있는 데이터셋을 활용하여
좋은 와인인지 아닌지 구분하는 예측 모델을 만들고, 또 어떤 성분이 좋은 와인을 결정하는데 영향을 끼치는지 탐색해 보았다.
---
### 🍷데이터셋 예시
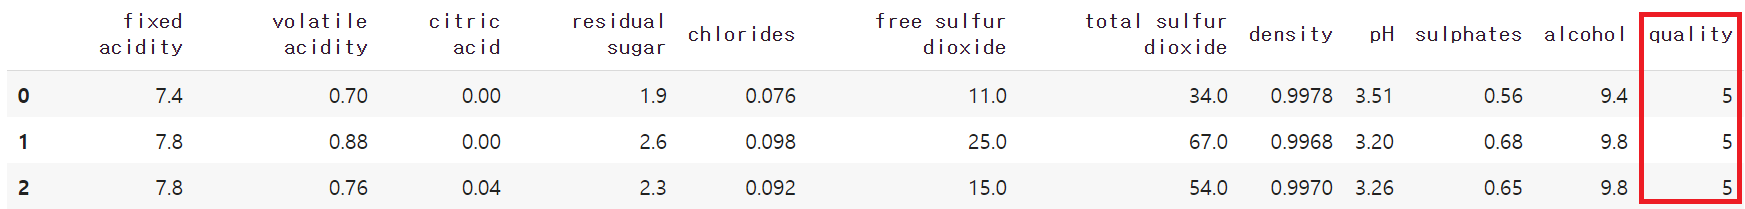
맨 우측의 'quality'는 레드와인의 등급이고, 나머지 특성들은 'quality'에 영향을 끼치는 와인의 여러가지 성분들이다.
### 1. 좋은 와인 vs 안 좋은 와인
quality는 3 ~ 8까지 분포해있는데, 좋은 와인을 분류하는 예측 모델을 만들기 위해 이진분류형 문제로 바꾸었다.
7등급 이상인 와인을 'good'이라는 변수에 맵핑하여 타겟으로 지정했다.
```python
df['good'] = [1 if x >= 7 else 0 for x in df['quality']]
df['good'].value_counts()
---------------------------------------------------------
0 1382
1 217
Name: good, dtype: int64
```
다시 말해 quality = 7,8은 'good' 에서 1로 표시되고, 그 아래 등급들은 0으로 표시된다.
### 2. 베이스라인 모델 만들기
이 프로젝트의 목적은, 좋은 와인인지 아닌지 예측하는 모델을 만들어 평가지표를 통해 모델의 성능을 확인하고 개선하는 것이다.
먼저 훈련/검증/테스트 데이터로 나눈 후, 예측모델의 성능 개선을 확인하기 위해 먼저 베이스라인 모델을 만들고 평가지표를 확인해보았다.
```python
# 모든 특성을 활용한 xgboost 모델
precision recall f1-score support
0 0.97 0.93 0.95 276
1 0.47 0.71 0.57 24
```
- 검증데이터의 타겟의 False에 대한 정밀도 재현도가 높다. 이는 좋은 와인이냐 아니냐를 판단할 때, good에 해당하지 않는 와인은 잘 예측한다.
- 타겟의 True에 대한 평가지표는 대체적으로 낮은데, 특히 정밀도가 떨어지는 편이다. 모델이 좋은 와인이라고 분류한 것 중 실제로 7,8등급 이상의 좋은 와인일 확률이 47%라는 말이다.
나는 타겟의 True 값에 대한 정밀도를 높이고 싶다. 왜냐하면 'quality'에 대한 정보가 없는, 처음보는 와인의 성분 데이터를 이 모델을 통해 돌렸을때 좋은지 안좋은지를 정확히 예측해주는 것이 더 유용하기 때문이다.
### 3. 예측 모델 만들기
```python
# RandomForestClassifier 모델 만들기
precision recall f1-score support
0 0.90 0.96 0.93 247
1 0.72 0.49 0.58 53
```
- 검증데이터에서 타겟의 True에 대한 평가지표 중 precision이 0.47 -> 0.72로 급격하게 올랐다. 그에 반해 recall은 0.71 -> 0.49로 떨어졌다.
- 모델의 precision을 높여 예측 정확성 개선시키려는 목적에 어느 정도 부합한다.
- f1 score는 precision과 recall의 조화 평균이다. label이 불균형 구조일 때 모델의 성능을 정확하게 평가할 수 있는데, 베이스라인 모델이 비해 f1-score도 0.01 정도 상승했다.
이 랜덤포레스트 모델을 테스트 데이터에 적용해 보았다.
```python
precision recall f1-score support
0 0.83 0.96 0.89 301
1 0.77 0.41 0.54 99
```
- 타겟의 True에 대한 precision이 더 올랐다. 모델이 좋은 와인이라고 분류한 것 중 실제로 good에 해당되는 와인을 맞춘 비율이 높아진 것이다.
### 4. Permutation Importances(순열중요도) 구하기
과연 모든 특성이 와인의 퀄리티를 결정하는데 영향을 끼치는걸까?
어떤 특성이 좋은 와인을 구분하는데 영향을 끼치는지 알아보았다.
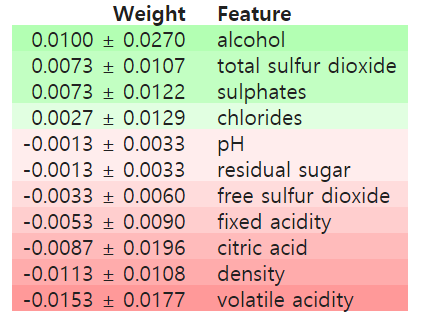
(✔️'-'로 시작하는 특성들은 모델에 거의 영향을 끼치지 않는다.)
> ### 특성 설명
- alcohol(알콜) : 알콜의 함량이 낮은 와인은 입안에서 더 가볍게 느껴지며 부패에 취약하다
- total sulfur dioxide(총 이산화황) : 산화방지제, 살균제, 방부제 등의 역할을 해 와인의 맛과 향이 변하는 것을 방지한다. 그러나 적정량을 넘어서면 기침, 천식, 알레르기 등의 부작용을 일으키기 때문에 나라별로 와인의 이산화황 함유량을 엄격히 관리하고 있으며 아황산염 표기는 법으로 정해져있다.
- sulphates(황산염) : 균 번식과 산화를 방지하고, 와인의 산도를 일정하게 유지하는 역할. 많이 함유될수록 단맛이 난다. (황산염이 가장 많이 함유된 포도주는 단맛이 나는 스위트 화이트와인)
- chlorides(염화물) : 소금의 양
### 5. PDP 시각화로 모델 설명하기
순열중요도에서 확인한 특성들 중 가중치가 큰 특성 몇개를 골라, 모델에 어떤 영향을 주는지 확인해 보았다.
**🍷 alcohol(알콜)**

- 'alcohol(알콜)'의 함유향은 8.4부터 14.9까지 분포해있다.
- 알콜 함유량이 커질수록 좋은 와인으로 분류될 확률이 확연히 높아진다.
**🍷 sulphates(황산염)**

- 황산염은 0.33 ~ 2.0까지 분포되어 있다. 0.8까지는 해당 변수가 좋은 와인으로 분류될 확률이 높아진다.
- 그러나 0.8 이상으로 올라가면 좋은 와인으로 분류될 확률이 높아지지 않고 거의 비슷한 수준을 유지한채 아주 약간 하향한다.
- 황산염은 많이 함유될수록 단맛이 난다. 일정 수준의 단맛은 좋은 와인의 조건이 되지만, 그 이상이면 좋은 와인으로 판정되는것과 큰 상관관계가 없는 것 같다.
- 나의 경우 단맛나는게 맛있어서 잘 마셨는데, 와인 애호가들에겐 황산염 함유량이 높은 와인이 저품질로 취급되어 선호되지 않을 수 도 있을 것 같다.
**🍷 total sulfur dioxide(총 이산화황)**

- 총 이산화황은 6 ~ 289까지 분포되어 있다.
- 이산화황의 함유량이 커질수록 좋은 와인으로 분류하지 않을 확률이 높아진다.
- EU는 레드와인의 이산화황의 최대 함유량을 175ppm(1L당 175mg)로 제한하고 있다.
- 미국은 레드와인의 이산화황의 최대 함유량을 350ppm으로 제한하고 있다.
>### 🥂갑자기 생긴 궁금증 - 내추럴 와인이란?
이산화황 성분에 대해 알아보다가 내추럴 와인에 대한 얘기가 나와 검색을 해 보았다.
식당에서 딱 한번 내추럴 와인을 시켜봤는데 내가 마시던 와인과 정말 달랐다. 솔직히 정말 맛이 없었다.
내추럴 와인은 자연적인 재배방식을 바탕으로 양조 과정에서도 최대한 인공적인 개입을 줄인 것이다.
유럽에서 규제하고 있는 내추럴 와인은 30~40ppm 까지 이산화황 함유가 가능한데, 유기농 와인 인증을 받으려면 인공첨가된 이산화황이 단 1mg도 허용되지 않는다.
이산화황이 직접적으로 내추럴 와인의 맛에 영향을 끼치진 않지만, 방부제(혹은 보존제) 역할을 하는 성분의 함량이 최소화 되었으므로 숙성 없이 그냥 마시기 때문에, 그 특유의 풋내가 내 취향에 안맞았던것 같다.
---
## 회고
데이터셋을 분석하고 예측 모델을 돌리면서 알게된 것은, 와인은 특정 성분의 함량이 높다고 무조건 좋은것도 아니고, 그 반대도 마찬가지다. 무엇보다 밸런스가 가장 중요한것 같다.
내가 좋아하는 단맛 나는 화이트 와인을 마실 때, "음 황산염이 좀 많이 들어갔군" 속으로 생각할 수도 있겠다.
내추럴 와인이 퀄리티 정보가 들어있는 데이터셋이 있다면 또 예측 모델을 만들어보고 싶다.
과연 어떤 특성이 일반 레드와인과 두드러지게 다른지도 비교해보고 싶다.
---
[데이터셋 출처](https://www.kaggle.com/uciml/red-wine-quality-cortez-et-al-2009)
[특성 설명 참조](http://rstudio-pubs-static.s3.amazonaws.com/80458_5000e31f84df449099a872ccf40747b7.html)
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.