codestates / codestates/ds-blog
[이재우]section2_solo_project
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
# 1. 보험회사와 데이터
보험 하면 제일 먼저 떠오르는 것은 보험가입권유 전화이다. 보험가입 권유 전화는 항상 제일 바쁘던 중에 혹은 중요한일을 하던 중에 마주하게 되어 짜증이 나지만, 그렇다고 해서 아주 친절한 상담원분께 무례하게 대할 수 없어서 안절부절못하다가 끊게 되는 불편한 존재로 인식되었다. 하지만 보험을 조금 들여다보게 되면, 데이터를 공부하는 나에게 중요한 분야일 수 있다. 보험은 기본적으로 미래에 일어나지 않는 사건 또는 사고에 대한 보상을 기본으로 한다. 따라서 보험상품은 기본적으로 미래를 예측하는 모델을 바탕으로 설계된다. 생명보험의 경우 대부분의 보험회사는 평균수명 예측 모델을 구축하고 있거나, 또는 [캐글](https://www.kaggle.com/anmolkumar/health-insurance-cross-sell-prediction)에서 처럼 한 사람이 보험에 관심 여부를 예측하는 모델을 구축하기도 한다. 이러한 모델들을 바탕으로, 보험료를 얼마를 책정할지 혹은 보험금을 얼마나 지급을 해줘야 하는지, 혹은 보험사의 기대 이익이 얼마가 될지 계산 할 수 있다. 그래서 이번 프로젝트는 위의 캐글 데이터셋을 사용하여 특정 회사의 고객 정보 등을 통해서 자동차보험에 관심 여부를 예측하는 모델을 만들어보자!
# 2. 프로젝트 설명
위의 캐글 프로젝트 설명을 원문은 다음과 같다.
- *Our client is an Insurance company that has provided Health Insurance to its customers now they need your help in building a model to predict whether the policyholders (customers) from past year will also be interested in Vehicle Insurance provided by the company.*
작년부터 건강보험에 가입된 고객 중에서, 자동차 보험에도 관심이 있을지 없을지 예측하는 모델을 설계하는 것이 목적이다. 예측모델의 결과를 통해서 관심이 있는 고객들과 소통을 하고 자동차보험 설계를 최적화하고, 이익을 최대화 하는 것이 목적이다. 그리고 이 보험회사에서 제공하는 데이터 세트는 인구통계자료(gender, age, region code type), 자동차 정보(Vehicle Age, Damage), 건강보험정보(Premium, sourcing channel) 등을 담고 있다.
# 3. Data
캐글에서 제공된 데이터 세트는 훈련을 위한 **train.csv**, 테스트를 위한 **test.csv**, 그리고 제출을 위한 **sample_submission.csv**로 구성되어 있다. 그럼 먼저 데이터 세트가 어떻게 구성되어 있는지 확인해보자.
## 3.1 Data overview
```py
# Num of cols, rows check
print(train.shape)
# 학습 데이터
train.head()
```
(381109, 12)
id | Gender | Age | Driving_License | Region_Code | Previously_Insured | Vehicle_Age | Vehicle_Damage | Annual_Premium | Policy_Sales_Channel | Vintage | Response
| -- | -- | -- | -- | -- | -- | -- | -- | -- | -- | -- | --
1 | Male | 44 | 1 | 28.0 | 0 | > 2 Years | Yes | 40454.0 | 26.0 | 217 | 1
2 | Male | 76 | 1 | 3.0 | 0 | 1-2 Year | No | 33536.0 | 26.0 | 183 | 0
3 | Male | 47 | 1 | 28.0 | 0 | > 2 Years | Yes | 38294.0 | 26.0 | 27 | 1
4 | Male | 21 | 1 | 11.0 | 1 | < 1 Year | No | 28619.0 | 152.0 | 203 | 0
5 | Female | 29 | 1 | 41.0 | 1 | < 1 Year | No | 27496.0 | 152.0 | 39 | 0
```py
# Num of cols, rows check
print(test.shape)
# 테스트 데이터
test.head()
```
(127037, 11)
id | Gender | Age | Driving_License | Region_Code | Previously_Insured | Vehicle_Age | Vehicle_Damage | Annual_Premium | Policy_Sales_Channel | Vintage
| -- | -- | -- | -- | -- | -- | -- | -- | -- | -- | --
381110 | Male | 25 | 1 | 11.0 | 1 | < 1 Year | No | 35786.0 | 152.0 | 53
381111 | Male | 40 | 1 | 28.0 | 0 | 1-2 Year | Yes | 33762.0 | 7.0 | 111
381112 | Male | 47 | 1 | 28.0 | 0 | 1-2 Year | Yes | 40050.0 | 124.0 | 199
381113 | Male | 24 | 1 | 27.0 | 1 | < 1 Year | Yes | 37356.0 | 152.0 | 187
381114 | Male | 27 | 1 | 28.0 | 1 | < 1 Year | No | 59097.0 | 152.0 | 297
Train 데이터는 총 354,405명의 고객정보를 담고 있으며, 총 12개의 feature를 가지고 있다. Test data는 총 127,037명의 고객정보를 우리의 target feature를 제외한 총 11개의 feature를 가지고 있다. 이로써, 우리의 target feature는 `Response`임을 알 수 있다. 그럼 이제 각 feature가 어떤 정보를 담고 있는지 확인해보자.
## 3.2 Data Description
캐글에서 제공하는 각 feature가 담고 있는 정보를 나타내는 표를 해석한 내용으로, 다음과 같다.
- id : 고객 고유번호
- Gender : 성별
- Age : 나이
- Driving_License :
- 0 : 면허를 보유하지 않음
- 1 : 면허를 보유중
- Region_Code : 고객 지역 고유코드
- Previously_Insured :
- 1 : 이미 자동차보험 보유
- 0 : 아직 자동차보험 미보유
- Vehicle_Age : 자동차 년식
- Vehicle_Damage :
- 1 : 과거에 자동차에 손상을 입힌적이 있음
- 0 : 과거에 자동차에 손상을 입힌적이 없음
- Annual_Premium : 보험료
- PolicySalesChannel : 건강보험을 가입하게 된 경로
- Vintage : 건강보험 보유기간
- Response :
- 1 : 관심있음
- 0 : 관심없음
지금까지 데이터의 대략적인 구성을 통해서, 우리의 target feature인 `Response`를 확인할 수 있었고, 각 feature의 의미를 알 수 있었다. 그럼 이제 본격적으로 데이터를 통해서 얻을 수 있는 insight가 무엇이 있는지 알아보자.
## 3.3 Data Exploration
데이터를 조금 세밀하게 목적을 가지고 분석을 하여 insight를 얻어보도록하자.
### 3.3.1 Missing Value
데이터에서의 결측치는 예측에서 전혀 도움이 되지 않는 요소이다. 결측치를 확인해보고, 어떻게 결측치를 처리할지 생각해보자.
```py
# Train info
train.info()
```
```
RangeIndex: 381109 entries, 0 to 381108
Data columns (total 12 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 id 381109 non-null int64
1 Gender 381109 non-null object
2 Age 381109 non-null int64
3 Driving_License 381109 non-null int64
4 Region_Code 381109 non-null float64
5 Previously_Insured 381109 non-null int64
6 Vehicle_Age 381109 non-null object
7 Vehicle_Damage 381109 non-null object
8 Annual_Premium 381109 non-null float64
9 Policy_Sales_Channel 381109 non-null float64
10 Vintage 381109 non-null int64
11 Response 381109 non-null int64
dtypes: float64(3), int64(6), object(3)
memory usage: 34.9+ MB
```
>먼저 train 데이터의 정보이다. 총 381109명의 데이터 모두 결측치 없이 존재함을 알 수 있다.
```py
# Test info
test.info()
```
```
RangeIndex: 127037 entries, 0 to 127036
Data columns (total 11 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 id 127037 non-null int64
1 Gender 127037 non-null object
2 Age 127037 non-null int64
3 Driving_License 127037 non-null int64
4 Region_Code 127037 non-null float64
5 Previously_Insured 127037 non-null int64
6 Vehicle_Age 127037 non-null object
7 Vehicle_Damage 127037 non-null object
8 Annual_Premium 127037 non-null float64
9 Policy_Sales_Channel 127037 non-null float64
10 Vintage 127037 non-null int64
dtypes: float64(3), int64(5), object(3)
memory usage: 10.7+ MB
```
> test 데이터 또한, 총 127037명의 데이터 모두 결측치 없이 잘 담겨져있다.
위의 두 개의 정보를 통해서 train, test 데이터 세트 모두 결측치가 존재하지 않음을 확인할 수 있었기 때문에 결측치 처리에 대해서는 신경을 쓰지 않아도 된다.
### 3.3.2 Response
`Response`는 예측의 타겟 특성이며, 자동차 보험에 관심이 있는 경우 1의 값을, 관심이 없는 경우 0의 값을 가지게 된다. 따라서 예측모델은 타켓 특성을 분류를 하게 되는 분류 문제이며, 분류 문제에서는 타켓 특성의 분포도 가장 중요한 문제 중의 하나이다. 그럼 분포를 확인해보자.
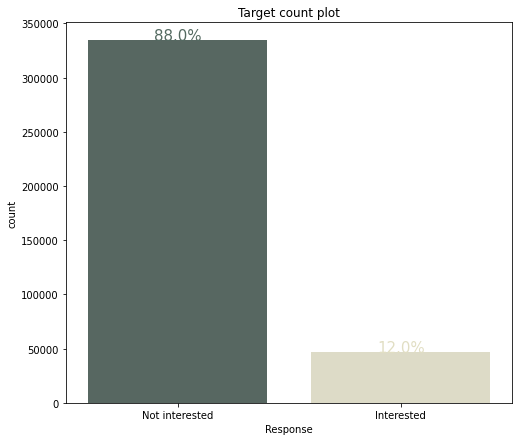
위의 표는 타켓 특성에 대한 분포를 나타내는 그래프이다. 한눈에 봐도 자동차 보험에 관심이 없는 사람이 88% 관심이 있는 사람이 12%로 엄청나게 불균형하게 분포하고 있음을 알 수 있다. 따라서 이 데이터 세트는 Imbalanced 한 데이터 세트라고 할 수 있다. 분류문제에서 불균형한 데이터 세트의 문제는 다음과 같다.
#### 3.3.2.1 Baseline model
베이스 라인 모델을 설정을 해보자. 여기서 최빈값인 0으로 모든 사람을 예측을 하게 되었을 때, 결과를 확인해보자.
```py
from sklearn.metrics import accuracy_score
target = 'Response'
# 최빈값
baseline = train[target].mode()[0]
# 예측값
y_pred = [baseline] * len(train[target]) # 모두 0(Not interested)로 예측
print('Baseline model 정확도(Accuracy) :', int(accuracy_score(train[target], y_pred).round(2) * 100),'%')
```
Baseline model 정확도(Accuracy) : 88 %
아무 근거 없이, 0으로 모든 값을 예측하였을 때, 정확도(Accuracy)가 88%가 나왔다. 정확도는 전체 예측 중에서 맞은 비율을 나타내는 평가지수로, 위의 타켓 특성 분포를 통해서 그 값이 88%임을 예측할 수 있다. 이처럼, 정확도(Accuracy)를 평가지수로 사용하였을 때 모델 성능의 평가가 제대로 이루어지지 않음을 알 수 있다. 따라서 불균형 데이터 세트에서도 모델 성능을 잘 나타내어줄 수 있는 평가지수를 사용하여야 한다.
### 3.3.3 Gender
`Gender`는 성별을 나타내는 특성으로, MALE 또는 FEMALE로 구분된다. 그럼 `Gender`의 특성에서는 어떤 정보를 얻을 수 있을까?
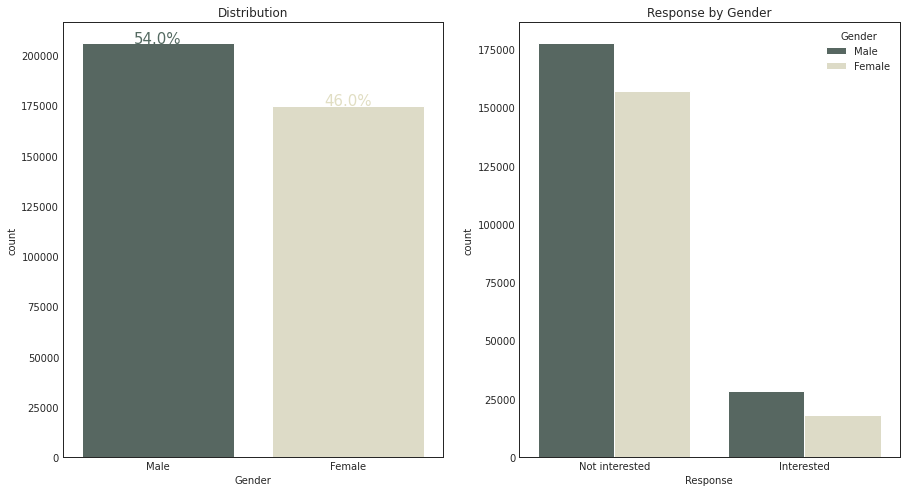
train 데이터 내에서 남자의 비율은 54%이며, 여자의 비율을 46%로 남자가 조금 많다. 자동차보험 관심여부는 성별에 따라 크게 달라지지 않는듯 하다.
### 3.3.4 Age
`Age`는 나이를 나타내는 특성이며, 숫자형 데이터이다.
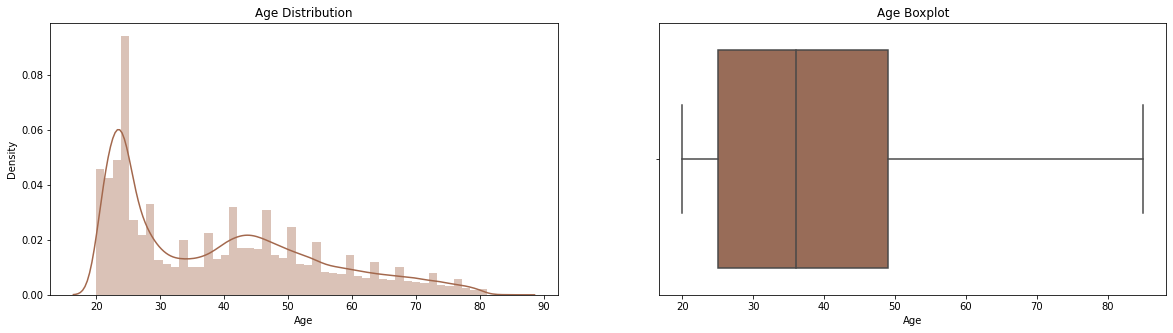
왼쪽 그래프의 나이 특성의 분포를 확인하게 되면, righk-skewed 그래프인걸 확인 할 수 있다. 오른쪽 boxplot을 통해서 이상치는 존재하지 않음을 알 수 있다.
### 3.3.5 Driving_License
`Driving_License`는 면허증의 소지여부를 나타내는 특성으로, 0은 갖고있지 않음, 1은 갖고있음을 나타낸다. 그럼 분포를 확인해보자.
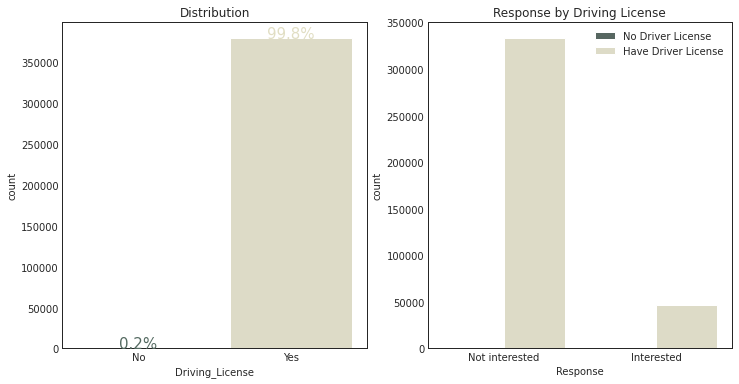
오른쪽 분포를 나타내는 그래프를 통해서 train 데이터 전체의 99.8%가 면허증을 보유하고 있다. 왼쪽의 그래프는 운전면허증의 보유 여부에 따른 자동차보험의 관심 여부를 나타내는 그래프로서, 아무래도 운전면허증이 있는 사람이 자동차보험에 더 관심이 있지 않을까 생각이 든다. 거의 모든 사람이 운전면허증을 보유하고 있지 않기 때문에, 그 차이는 되게 미미할 것으로 예상한다.
### 3.3.6 Region_Code
`Region_Code`는 데이터셋에서의 거주지역을 분류하여 나타내는 특성이다. 1부터 52까지의 숫자로 지역을 분류하였다.
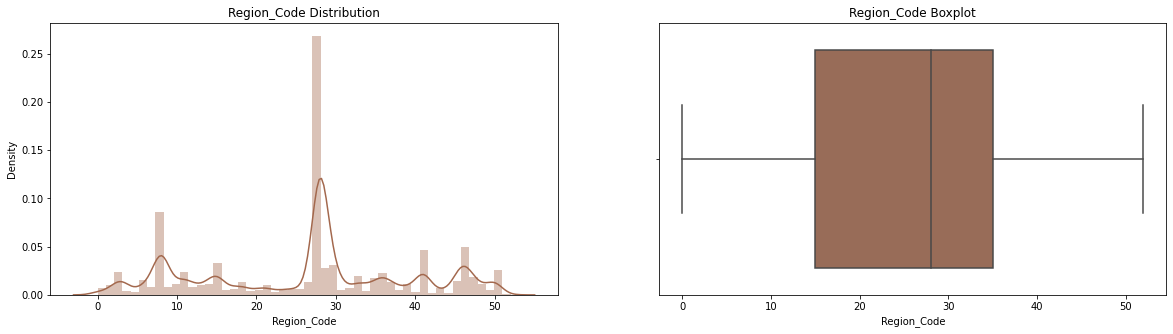
왼쪽 그래프는 지역별 분포를 나타내는 그래프이다. 28 지역에서 특히 많은 사람이 건강보험을 이용하고 있음을 알 수 있다. 그리고 오른쪽 box plot을 통해서, 이상치의 존재는 확인할 수 없었다. 그럼 여기서 추가적인 의문이 들 수 있다. 자동차보험에 관심이 있는 사람들의 지역별 분포는 어떻게 될까?
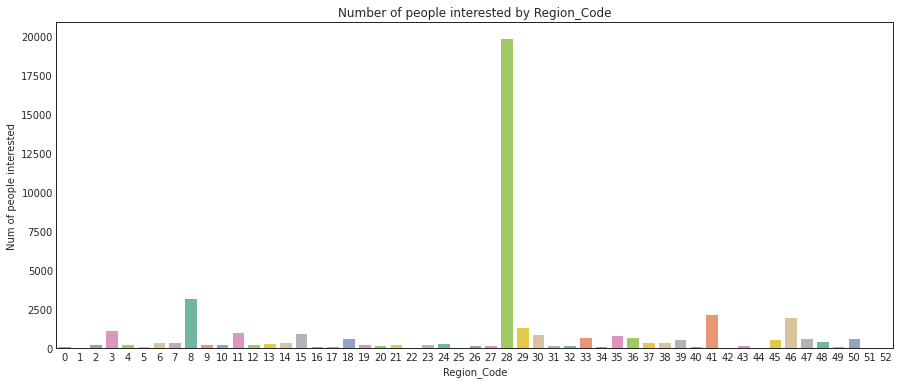
마찬가지로, 28지역의 사람들이 독보적으로 자동차보험에 관심있는 사람들이 많이 분포해 있다.
### 3.3.7 Previously_Insured
`Previously_Insured`라는 특성은 자동차보험에 이미 가입한 상태인지 아닌지를 나타낸다. 0은 자동차보험에 가입하지 않은 상태를 의미하고, 1은 자동차보험에 가입한 상태를 의미한다.
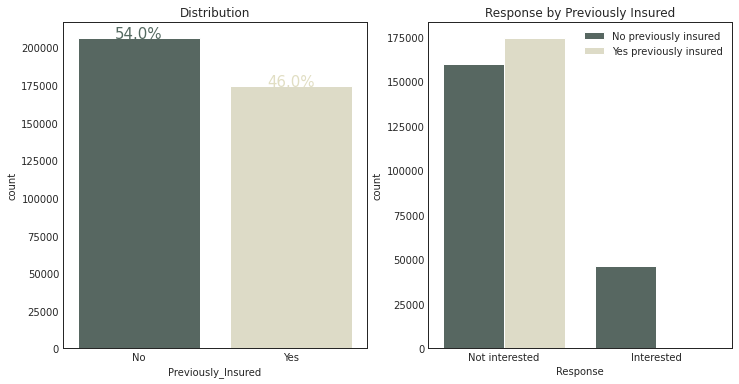
자동차보험의 여부를 나타내는 `Previously_Insured`의 분포를 나타내는 그래프이다. 전체의 54%가 자동차보험에 가입하지 않았으며, 46%가 자동차보험을 이미 보유하고 있다. 당연하게도, 자동차보험을 이미 보유하고 있는 사람들은 새로운 자동차보험에 전혀 관심을 보이지 않는다.
### 3.3.8 Vehicle_Age
`Vehicle_Age`는 자동차의 연식을 나타내는 특성이다. 2년 이상의 연식(> 2 Years), 1년과 2년 사이(1 - 2 Year), 1년 미만 (< 1 Year)과 같이 총 3가지로 분류된다.
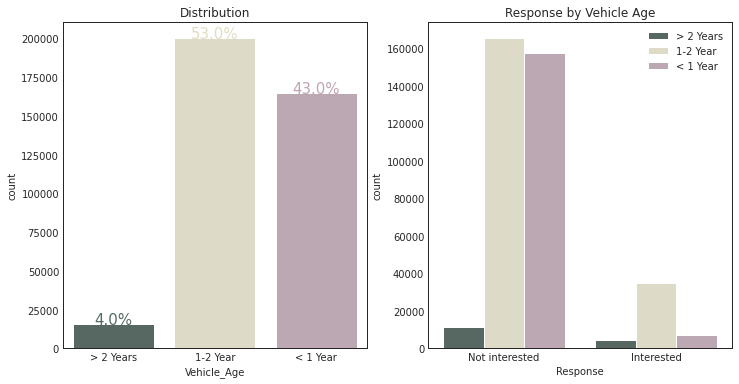
1년과 2년 사이의 자동차 연식을 가진 사람은 53%로 가장 많은 분포를 차지하고 있으며, 1년 미만의 자동차 연식을 가진 사람은 전체의 43%를 차지하고 있고, 마지막으로 2년 이상의 자동차 연식을 가진 사람은 오직 전체의 4%밖에 없다. 오른쪽 그래프를 통해서, 1년과 2년 사이의 자동차 연식을 가진 사람이 자동차 보험에 관심이 가장 높은 것으로 나타났다.
### 3.3.9 Vehicle_Damage
`Vehicle_Damage`는 자동차에 관련 사고 여부를 나태는 특성이다. 0은 아니오, 1은 예를 의미한다.
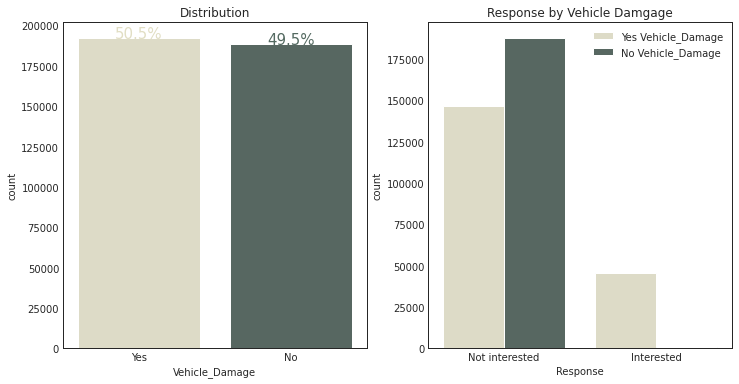
왼쪽 분포 그래프를 통해서, 자동차 관련 사고여부에 따라 거의 50 대 50으로 나누어 졌음을 알 수 있고, 당연하게도 자동차 사고를 경험한 사람이 자동차 보험의 필요성을 느꼈기 때문인지 자동차 보험에 관심이 상대적으로 많음을 알 수 있다.
### 3.3.10 Annual_Premium
`Annual_Premium`은 건강보험을 통해서, 지급하고 있는 보험료를 의미하며, 숫자 형 데이터이다.
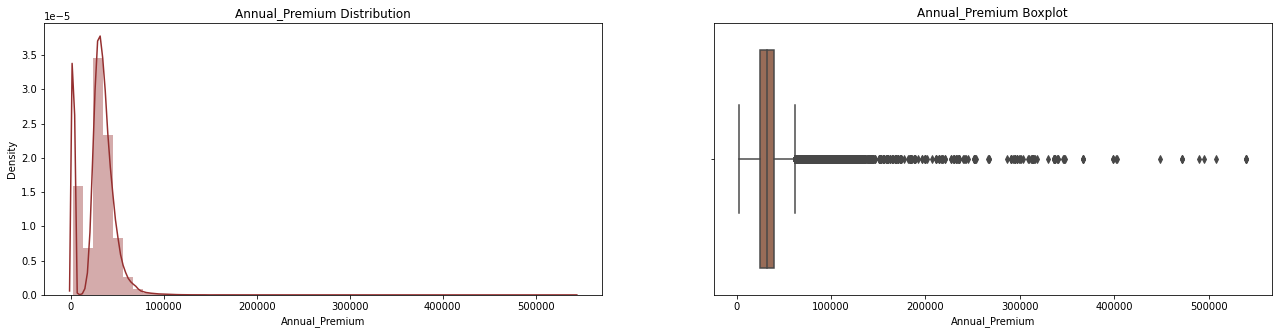
왼쪽 분포 그래프를 보게 되면, 굉장히 right-skewed 된 그래프를 확인할 수 있다. 게다가, box plot을 보게 되면 상당한 수의 이상치가 분포하고 있음을 알 수 있다.
### 3.3.11 Policy_Sales_Channel
`Policy_Sales_Channel`은 건강 보험에 가입하게 된 경로를 익명화하여 나타내는 특성이다. 1부터 159까지의 숫자의 값으로 나타내었다.
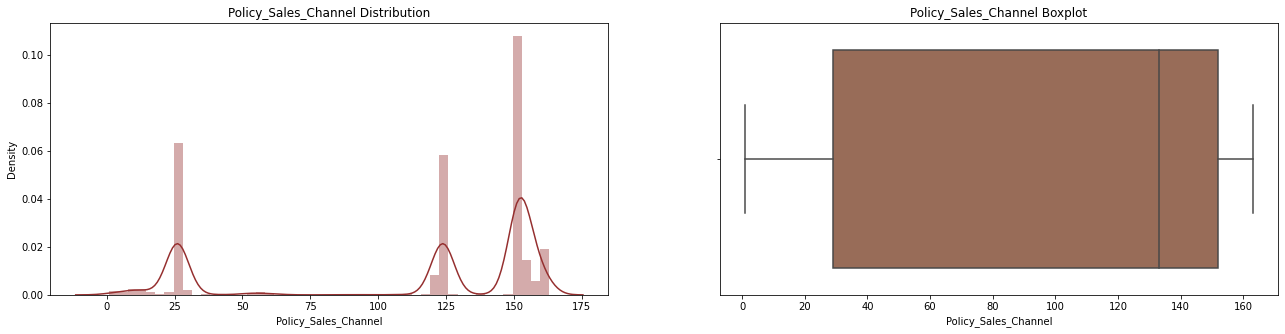
왼쪽 그래프를 보면 특정 경로를 통해서 유독 건강보험에 많이 가입한 경우가 존재한다. 그리고 box plot을 통해서 이상치는 없음을 알 수 있다.
`Region_Code`와 마찬가지로, 자동차 보험에 관심을 가지는 사람은 어떤 `Policy_Sales_Channel`을 보여주는지 확인해보자.
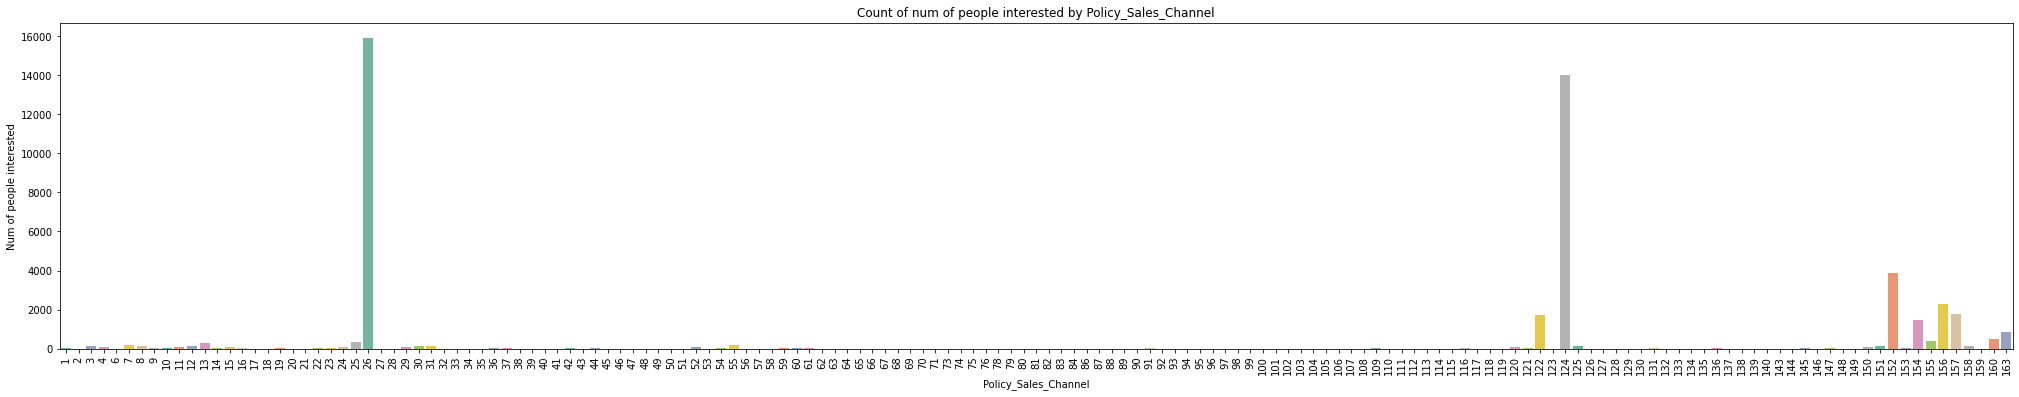
26과 124의 경로를 통해서 건강보험에 가입한 사람들이 자동차보험에도 관심이 많음을 알 수 있다.
### 3.3.12 Vintage
`Vintage`는 건강보험을 얼마나 오랫동안 가입하고 있었는가를 나타내며, 숫자형 데이터로 일(day)을 기준으로 보여준다.
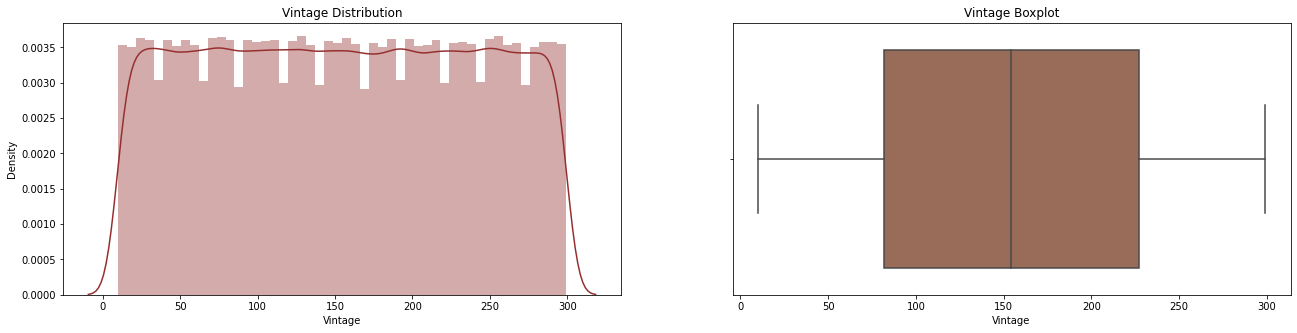
왼쪽 그래프의 분포를 보게되면, 아주 고르게 분포되어있다. 이상치 또한 존재하지 않음을 알 수 있다.
### 3.3.13 Correaltion
숫자형 데이터들의 선형관계를 나타내는 그래프이다.
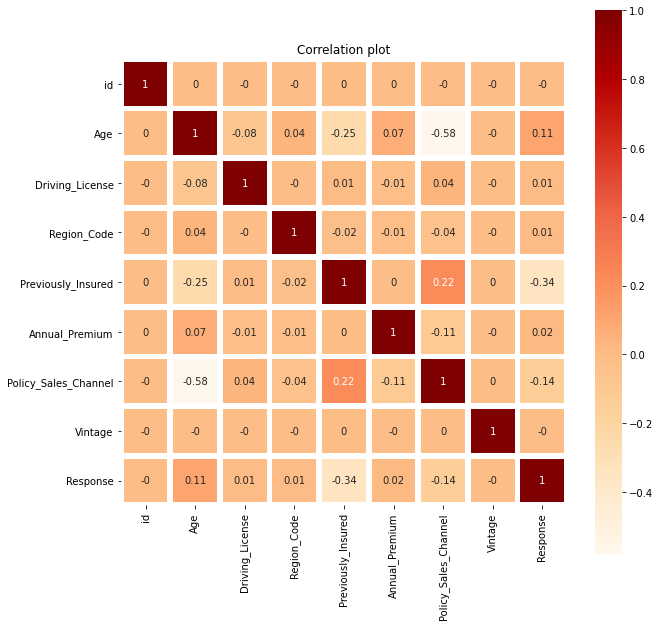
특성들 간에 엄청난 선형관계를 나타내는 feature는 찾기 힘들다.
## 3.4 Feature Engineering
데이터셋 자체가 엄청 간결하고, 필요한 정보들만 담은 데이터셋이라고 생각이 들어서 크게 feature engineering이 필요하지 않았다.
```py
# Merge
train['is_train'] = 1
test['is_train'] = 0
test['Response'] = None
df = pd.concat((train,test)) # 파이프라인을 사용하지 않고 encoder만 따로 적용하기 위해서
```
그럼 합쳐진 데이터프레임 **df**를 통해서, feature engineering을 시작해보자.
```py
# Drop id
df = df.drop('id', axis = 1)
# Annual_Premium 이상치 상위 5%, 하위 5% 데이터 제거
df = df.loc[(df['Annual_Premium'] < np.quantile(df['Annual_Premium'], 0.95)) & (df['Annual_Premium'] > np.quantile(df['Annual_Premium'], 0.05))]
```
> `id`는 사람들의 고유번호이기 때문에, 학습에 도움이 되지 않아 삭제하였다. 그리고 위의 `Annual_Premium`의 boxplot을 통해서 이상치를 발견하여 이상치를 제거해주었다.
```py
from sklearn.preprocessing import StandardScaler
# Num_feature
num_cols = ['Age', 'Annual_Premium', 'Vintage']
# 숫자형 데이터 StandardScaler 적용
scaler = StandardScaler()
df[num_cols] = scaler.fit_transform(df[num_cols])
```
> 숫자형 데이터의 경우 **StandardSclaer**를 통해 표준화를 해주었다.
```py
# Train / Test
train = df[df['is_train']==1]
test = df[df['is_train']==0]
train = train.drop(['is_train'],axis=1)
test = test.drop(['is_train','Response'] ,axis=1)
# target (object to int)
train['Response'] = train['Response'].astype(int)
# Cat features
cat_cols = ['Gender', 'Driving_License', 'Previously_Insured', 'Vehicle_Age','Vehicle_Damage','Region_Code','Policy_Sales_Channel']
# Ordinal Encoder
from category_encoders import OrdinalEncoder
enc = OrdinalEncoder()
train[cat_cols] = enc.fit_transform(train[cat_cols], y = train['Response'])
test[cat_cols] = enc.transform(test[cat_cols])
# Train Result
train.head()
```
> 범주형의 데이터는 `OrdinalEncoder`를 숫자형 데이터로 변환해주었다.
Gender | Age | Driving_License | Region_Code | Previously_Insured | Vehicle_Age | Vehicle_Damage | Annual_Premium | Policy_Sales_Channel | Vintage | Response
| -- | -- | -- | -- | -- | -- | -- | -- | -- | -- | --
0.136645 | 0.392342 | 1 | 28.0 | 0 | 0.302255 | 0.241518 | 0.760015 | 26.0 | 0.749965 | 1
0.136645 | 2.470344 | 1 | 3.0 | 0 | 0.177117 | 0.004210 | -0.083866 | 26.0 | 0.343590 | 0
0.136645 | 0.587155 | 1 | 28.0 | 0 | 0.302255 | 0.241518 | 0.496531 | 26.0 | -1.520953 | 1
0.136645 | -1.101221 | 1 | 11.0 | 1 | 0.041406 | 0.004210 | -0.683657 | 152.0 | 0.582634 | 0
0.098405 | -0.581721 | 1 | 41.0 | 1 | 0.041406 | 0.004210 | -0.820645 | 152.0 | -1.377526 | 0
> 숫자형 데이터는 모두 표준화 되었고, 범주형 데이터도 숫자형 데이터로 바꾸어 졌음을 확인 할 수 있다.
# 4. 모델링
본격적으로 다양한 모델에 train 데이터를 학습시키고, 그 성능을 평가지수를 통해 확인해보자. 이번 프로젝트에서 사용할 평가지수는 ROC curve를 통한 AUC 점수와 f1 점수를 사용할 것이다. 자세한 평가지수에 대한 설명은 모델의 성능 결과를 예를 들어 같이 설명하는 게 좋겠다. 그럼 먼저 모델링을 하기 전에, 데이터를 조금 나누어야 한다.
```py
# X, y
X = train.drop(target, axis = 1)
y = train[target]
X_test = test
# Train / Val
X_train, X_val, y_train, y_val = train_test_split(X, y, test_size = 0.2, # data를 random하게 나누어주는 코드
stratify = y, shuffle = True)
```
> `train_test_split`을 통하여, train 데이터와 validation 데이터를 나누어 주었다.
## 4.1 Baseline
`Response` 특성을 보면서, 함께 봤던 모든 예측값을 데이터의 최빈값으로 설정하여 예측한 모델을 의미한다.
```py
# 예측
y_pred_bs = [0] * len(X_val)
y_prob_bs = [0] * len(X_val)
```
> 모든 예측값을 0(Not Interested)로 예측하고, 1이 될 확률을 담은 **y_porb_bs**또한 모두 0이 됨을 알 수 있다.
그렇다면 베이스라인 모델의 위에서 소개한 f1 점수와, ROC curve를 통한 AUC 점수를 확인해보자.
```py
# confusion matrix
def plot_confusion_matrix(y_real, y_pred): # confusion matrix plot 함수
cm = confusion_matrix(y_real, y_pred)
ax= plt.subplot()
sns.heatmap(cm, annot=True, ax = ax, fmt='g')
ax.set_xlabel('Predicted labels')
ax.set_ylabel('True labels')
# plot
plot_confusion_matrix(y_val, y_pred_bs)
```
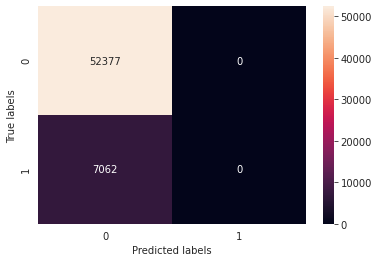
> **confusion_matrix**를 통해서, 실제값과 예측값의 비율을 확인할 수 있다. 1을 예측한 경우 모두 0임을 알 수 있다.
```py
# f1 score를 확인
from sklearn.metrics import classification_report
print(classification_report(y_val, y_pred_bs))
```
> sklearn에서 `classification_report`를 통해서 정밀도(Precision), 재현율(Recall)과 f1_score 또한 확인할 수 있다.
```
precision recall f1-score support
0 0.88 1.00 0.94 52377
1 0.00 0.00 0.00 7062
accuracy 0.88 59439
macro avg 0.44 0.50 0.47 59439
weighted avg 0.78 0.88 0.83 59439
```
정밀도(precision)는 예측값 중에 실제값과 일치하는 비율을 나타낸다. 따라서 0의 경우 precision이 0.88이다. 재현율(Recall)은 실제값 중에서 실제값과 예측값이 일치하는 비율을 나타낸다. 따라서 실제값이 0인 경우 모두 그 예측값 또한 0이기 때문에 1을 확인할 수 있다. 마지막으로 **f1-score**는 정밀도와 재현율의 조화평균을 나타낸다. 반면에, 1의 경우 정밀도, 재현율 모두 0이다. 그에 따라, **f1-score** 또한 0을 알 수 있다. 여기서 다시 프로젝트의 목표를 다시 생각해볼 필요가 있다. 이번 프로젝트는 보험의 관심이 있는 사람들을 알아내는 것이 목표이기 때문에, 1을 잘 맞추는 것이 중요하다. 따라서 1의 **f1-score**가 0이기 때문에 모델의 개선이 필요하다고 생각할 수 있다. 그럼 ROC curve를 확인해보자.
```py
from sklearn.metrics import roc_curve, auc
plt.style.use('seaborn-whitegrid')
# ROC curve
fpr, tpr, thr = roc_curve(y_val, y_prob_bs)
plt.title('Random Forest ROC curve: CC Fraud')
plt.xlabel('FPR (Precision)')
plt.ylabel('TPR (Recall)')
plt.plot(fpr,tpr)
plt.plot((0,1), ls='dashed',color='black')
plt.show()
print ('Area under curve (AUC): ', auc(fpr,tpr))
```
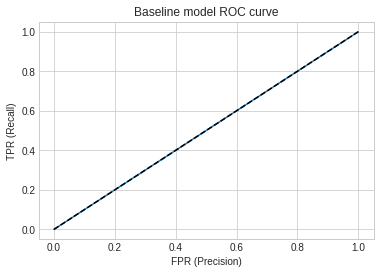
Area under curve (AUC): 0.5
> ROC curve는 x축에는 FPR(False Positive Rate)을 나타내고, y축에는 TPR(True Positive Rate)를 나타낸다. FPR은 Negative로 예측한 경우에서 예측값과 실제값이 다른 경우를 의미한다. TRP 은 재현율을 의미한다. 가운데 그어져 있는 선을 기준으로 조금씩 멀어질수록 좋은 성능을 나타낸다고 볼 수 있다. 그리고 AUC(Area Under Curve)를 의미하고, 위의 경우에는 0.5점이다. AUC는 0.5를 최소점수를 해서 가장 이상적인 점수는 1에 가까울수록 모델 성능이 높다고 판단할 수 있다.
베이스라인 모델의 평가지표를 확인해보았다. **f1_score**는 0으로, **AUC**는 0.5임을 알 수 있다. 이제 다양한 방법으로 이 모델의 성능을 개선해보자.
## 4.2 RandomForest
첫번째로 적용할 모델은 `RandomForest`모델이다. 여러개의 결정트리들을 합쳐놓은 모델로 생각 될 수 있다. 여러개의 결정트리들을 결과를 합쳐서 예측을 합니다.
```py
from sklearn.model_selection import RandomizedSearchCV
# # RandomForest Modeling
# rf = RandomForestClassifier(random_state=2, n_jobs = -1, class_weight='balanced')
# # param grid
# rf_grid ={
# 'criterion' : ['gini', 'entropy'],
# 'max_features': ['auto', 'sqrt'],
# 'max_depth': [10, 20, 30, 40, 50, 60, 70, 80, 90, 100, 110, None],
# 'min_samples_leaf': [1, 2, 4],
# 'min_samples_split': [2, 5, 10],
# 'n_estimators': [130, 180, 230]
# }
# # Hyperparameter Tuning
# clf = RandomizedSearchCV(
# rf,
# rf_grid,
# n_iter = 10,
# cv = 4,
# random_state = 2
# )
# # 학습
# clf.fit(X_train, y_train)
# # 예측
# y_pred_rf = clf.predict(X_val)
# y_prob_rf = clf.predict_proba(X_val)[:,1]
# 최적화 모델
rf = RandomForestClassifier(bootstrap=True, ccp_alpha=0.0, class_weight='balanced',
criterion='gini', max_depth=60, max_features='sqrt',
max_leaf_nodes=None, max_samples=None,
min_impurity_decrease=0.0, min_impurity_split=None,
min_samples_leaf=1, min_samples_split=2,
min_weight_fraction_leaf=0.0, n_estimators=230,
n_jobs=-1, oob_score=False, random_state=2, verbose=0,
warm_start=False)
# 학습
rf.fit(X_train, y_train)
# 예측
y_pred_rf = rf.predict(X_val)
y_prob_rf = rf.predict_proba(X_val)[:,1]
```
> `RadomizedSearchCV`를 통해서 하이퍼 파라미터를 튜닝 한 후 학습을 진행 하였다. `RadomizedSearchCV`는 주어진 파라미터들 조합을 random하게 조합하여, 가장 높은 성능을 보여주는 하이퍼 파라미터를 찾아준다.
```py
# confusion matrix plot
plot_confusion_matrix(y_val, y_pred_rf)
```
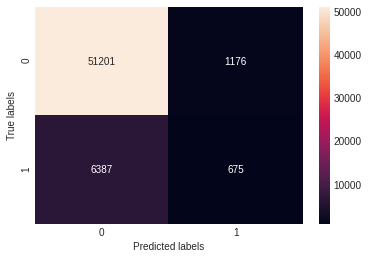
> 베이스라인 모델과 달리 1에 대해서 예측을 하기 시작했지만, 그 성능이 엄청 좋아보이진 않는다.
```py
# Classification Report
print (classification_report(y_val, y_pred_rf))
```
```
precision recall f1-score support
0 0.89 0.98 0.93 52377
1 0.36 0.10 0.15 7062
accuracy 0.87 59439
macro avg 0.63 0.54 0.54 59439
weighted avg 0.83 0.87 0.84 59439
```
> 베이스라인 모델과 비교했을 때, **f1_score**가 0.16으로 상승 했다. 하지만, 성능은 아직 많이 떨어진다.
```py
plt.style.use('seaborn-whitegrid')
# ROC curve
fpr, tpr, thr = roc_curve(y_val, y_prob_rf)
plt.title('Random Forest ROC curve')
plt.xlabel('FPR (Precision)')
plt.ylabel('TPR (Recall)')
plt.plot(fpr,tpr)
plt.plot((0,1), ls='dashed',color='black')
plt.show()
print ('Area under curve (AUC): ', auc(fpr,tpr))
```
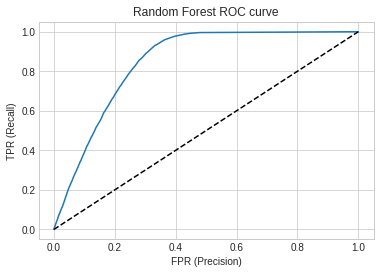
Area under curve (AUC): 0.8462593298989705
> AUC 점수는 거의 0.85에 가까울 정도로 학습은 잘 되었다고 알 수 있다.
`RandomForest`를 통해서 베이스라인 모델 보다는 좋은 성능을 보여줬지만, 아직 많이 아쉬원 성능을 확인 할 수 있었다. 다른 모델을 활용해보자.
## 4.3 XGB
이번에 사용할 모델은, 같은 결정트리를 베이스로한 `XGB`모델이다. `RandomForest`와는 달리, 각 결정트리의 순서가 존재하며 각 결정트리들의 중요도도 다르다.
```py
# optuna 활용 하이퍼 파라미터 튜닝
# np.random.seed(666)
# sampler = TPESampler(seed=0)
# 최적화 모델 설정
# def create_model(trial):
# max_depth = trial.suggest_int("max_depth", 2, 20)
# n_estimators = trial.suggest_int("n_estimators", 1, 400)
# learning_rate = trial.suggest_uniform('learning_rate', 0.0000001, 1)
# gamma = trial.suggest_uniform('gamma', 0.0000001, 1)
# scale_pos_weight = trial.suggest_int("scale_pos_weight", 1, 20)
# model = XGBClassifier(learning_rate=learning_rate, n_estimators=n_estimators, max_depth=max_depth, gamma=gamma, scale_pos_weight=scale_pos_weight, random_state=0)
# return model
# 최적화를 진행할 Objective 함수 정의
# def objective(trial):
# model = create_model(trial)
# model.fit(X_train, y_train)
# preds = model.predict(X_val)
# score = f1_score(y_val, preds)
# return score
# optuna 적용
# study = optuna.create_study(direction="maximize", sampler=sampler)
# study.optimize(objective, n_trials=100)
# 최적화 결과
# xgb_params = study.best_params
# xgb_params['random_state'] = 0
# xgb = XGBClassifier(**xgb_params)
# xgb.fit(X_train, y_train)
# 최적화 모델
xgb = XGBClassifier(base_score=0.5, booster='gbtree', colsample_bylevel=1,
colsample_bynode=1, colsample_bytree=1,
gamma=0.0012894603636011376, learning_rate=0.11574102977184302,
max_delta_step=0, max_depth=3, min_child_weight=1, missing=None,
n_estimators=347, n_jobs=1, nthread=None,
objective='binary:logistic', random_state=0, reg_alpha=0,
reg_lambda=1, scale_pos_weight=4, seed=None, silent=None,
subsample=1, verbosity=1)
# 학습
xgb.fit(X_train, y_train)
# 예측
y_pred_xgb = xgb.predict(X_val)
y_prob_xgb = xgb.predict_proba(X_val)[:,1]
```
> `optuna`를 사용해서 하이퍼파라미터를 튜닝하였다.
```py
# confusion matrix plot
plot_confusion_matrix(y_val, xgb.predict(X_val))
```
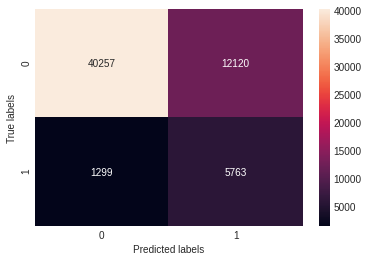
> 확실히 `RandomForest`의 결과보다, 1을 맞추는 경우도 많이 늘어났고 틀린경우도 많이 생겼다.
```py
# f1 score
print (classification_report(y_val, y_pred_xgb))
```
```
precision recall f1-score support
0 0.97 0.77 0.86 52377
1 0.32 0.82 0.46 7062
accuracy 0.77 59439
macro avg 0.65 0.79 0.66 59439
weighted avg 0.89 0.77 0.81 59439
```
> 1의 정밀도는 거의 비슷하지만, 재현율이 많이 올라갔다. 그 결과를 통해서 **f1_score**또한 0.46으로 크게 상승했다.
```py
# ROC curve
fpr, tpr, thr = roc_curve(y_val, y_prob_xgb)
plt.title('XGB ROC curve')
plt.xlabel('FPR (Precision)')
plt.ylabel('TPR (Recall)')
plt.plot(fpr,tpr)
plt.plot((0,1), ls='dashed',color='black')
plt.show()
print ('Area under curve (AUC): ', auc(fpr,tpr))
```
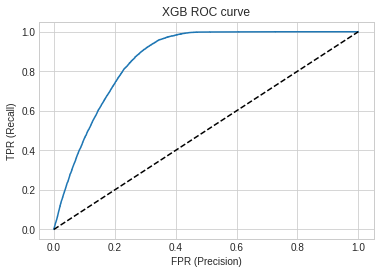
Area under curve (AUC): 0.8646973570321353
> AUC 점수도 약 0.86으로 소폭 상승했음을 알 수 있다.
전반적으로 `XGB`모델이 `RandomForest`모델의 성능보다, 많은 상승을 보여주었다.
## 4.4 LGBM
`LGBM`모델도, `XGB`와 같이 boosting 모델중의 하나이다. 데이터를 학습시키고, 그 결과를 확인해보자.
```py
from lightgbm import LGBMClassifier
# model 설정
lgb = LGBMClassifier(boosting_type='gbdt',n_estimators=500,depth=10,learning_rate=0.04,objective='binary',metric='f1',is_unbalance=True,
colsample_bytree=0.5,reg_lambda=2,reg_alpha=2,random_state=2,n_jobs=-1)
# 학습
lgb= lgb.fit(X_train, y_train,eval_metric='auc',eval_set=(X_val , y_val),verbose=50,categorical_feature=cat_cols,early_stopping_rounds= 50)
# 예측
y_pred_lgb = lgb.predict(X_val)
y_prob_lgb = lgb.predict_proba(X_val)[:, 1]
```
> Hyperparameter 튜닝을 해보았으나, 성능이 오히려 떨어져서 그대로 사용함
```py
# confusion matrix
plot_confusion_matrix(y_val, y_pred_lgb)
```
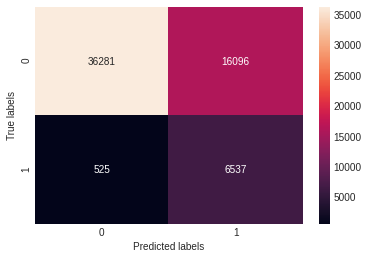
> `XGB`와 비교했을 때, 1로 예측했을 때의 맞는결과도 많이 상승 했었지만 오히려 틀린경우가 더 많이 늘어났다.
```py
# classification Report
print (classification_report(y_val, y_pred_lgb))
```
```
precision recall f1-score support
0 0.99 0.69 0.81 52377
1 0.29 0.93 0.44 7062
accuracy 0.72 59439
macro avg 0.64 0.81 0.63 59439
weighted avg 0.90 0.72 0.77 59439
```
> 예상대로, 재현율은 더 커졌지만 정밀도는 감소하여 **f1_score**가 감소했다.
```py
# ROC curve
fpr, tpr, thr = roc_curve(y_val, y_prob_lgb)
plt.title('LGBM ROC curve')
plt.xlabel('FPR (Precision)')
plt.ylabel('TPR (Recall)')
plt.plot(fpr,tpr)
plt.plot((0,1), ls='dashed',color='black')
plt.show()
print ('Area under curve (AUC): ', auc(fpr,tpr))
```
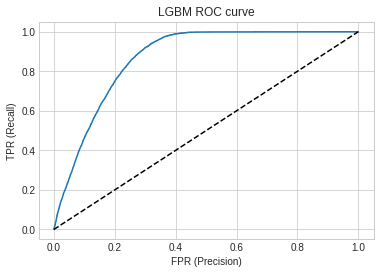
Area under curve (AUC): 0.866483369025105
> AUC 점수 또한 `XGB`에 비해 다소 높은 점수를 확인 할 수 있다.
`LGBM`의 결과는 `RandomForest`의 결과보다는 좋지만, `XGB`의 결과보다는 좋지 않음을 알 수 있었다. 하지만 가장 높은 **재현율**을 보여준 `LGBM`모델을 최종 모델로 설정하였다. 보험사의 입장에서는 자동차 보험이 관심이 있는 사람들은 놓치면 엄청난 손해이기 때문에, 정밀도가 조금 낮더라도 재현율이 높은 모델을 최종 예측 모델로 설정하였다.
# 5. Model Interpretation
최종적으로 선택한 `XGB`모델을 해석을 해석을 해보도록 하자.
## Permutation Importance
`Permutation Importance`를 활용하여 모델을 학습하는데 중요했던 특성과 그렇지 않았던 특성을 확인해보자.
```py
# Permutation Importance Instance 생성
perm = PermutationImportance(lgb, random_state=1).fit(X_train, y_train)
eli5.show_weights(perm, feature_names = X_train.columns.tolist())
```
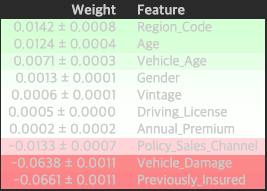
위의 그림과 같이 `Permutation Importance`를 통해서 `XGB`모델에서 중요했던 특성들을 확인할 수 있다. **Age**와 **Vehicle_Age**둘의 특성이 가장 중요한 특성으로 나타났다. 모델 학습을 중요하지 않은 특성들을 제외하고 결과를 확인해보았을 때, 오히려 성능이 감소하여 그대로 사용하였다.
## 5.1 PDP plot
`PDP plot`을 사용하면, 하나의 특성이 모델에 주는 전반적인 영향을 알 수 있다. 위의 `PermutationImportance`를 통해서 확인 할 수 있었던 중요한 특성 **Age**와 **Region_Code** 어떤 영향을 주었는지 확인해보자.
### 5.1.1 Age
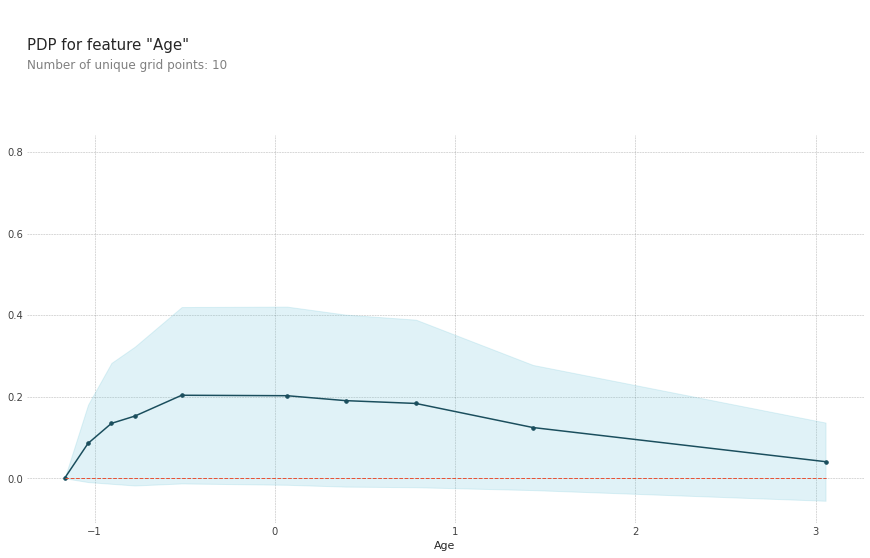
>x축은 scaled 된 age의 값을, y축은 확률의 변화값을 의미한다. 기본적으로, 확률이 0.5 이상이 되면 1로 예측을, 반대로 이하이면 0으로 에측을 한다. 따라서, 나이가 증가하면서 조금씩 자동차보험에 관심을 보이다가 어느 순간을 지나게 되면 계속 감소함을 알 수 있다.
### 5.1.2 Region_Code
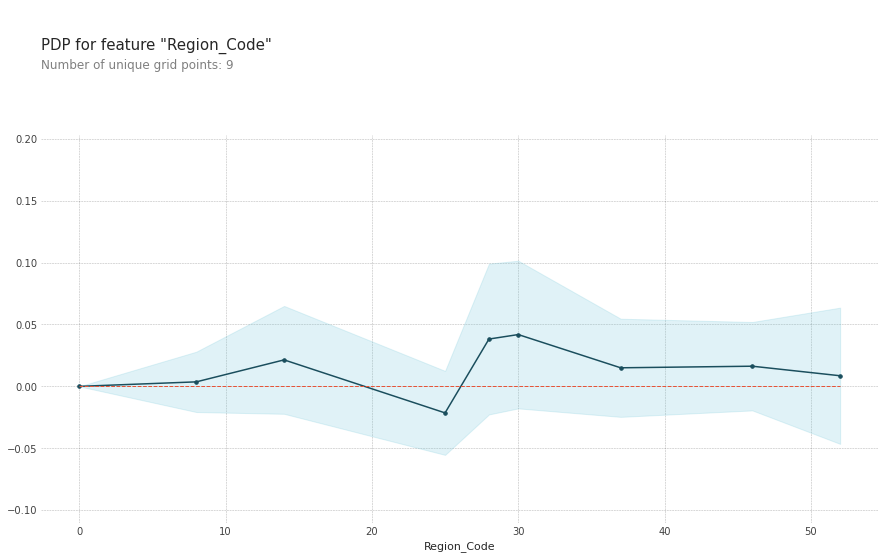
>X축에는 각 지역 코드를 의미하는 값들이, y축에서는 확률의 변화량을 나타낸다. 30 근처의 지역에서 자동차보험의 관심도가 가장 높음을 알 수 있다. 반대로, 25 주변의 지역에서는 관심도가 가장 낮음을 알 수 있었다.
최종 예측 모델 해석을 통해 얻을 수 있는 결과는 다음과 같다.
1. 20대에서 40대 사이의 사람들이 자동차 보험에 관심이 많다.
2. 특정 지역에 거주하는 사람들이 자동차 보험에 관심이 많다.
이 두가지 사실을 통해서, 좀 더 효과적인 마케팅이 가능하지 않을까 생각한다.
# 6. 결론
어느 하나의 보험회사의 건강보험 가입 고객들의 데이터을 통해서, 새롭게 시작하는 자동차보험에 대한 관심 여부를 예측하는 프로젝트을 진행하였다. 가장 먼저 데이터을 충분히 이해하기 위해서 다양한 시각화을 통해서 많은 Insight을 얻으려고 하였다. 그런 다음 데이터을 적절히 전처리한 후에 학습 모델에 적용해주었다. 학습에 사용한 모델은 `RandomForest`, `XGB`, `LGBM`모델을 사용하였다. 가장 좋은 **f1_score**을 보여준 모델은 `XGB`모델이었다. 하지만 보험사의 처지에서 생각을 해보았을 때 예측이 틀리는 것 즉, 정밀도가 낮음을 무서워하는 것이 아닌, 자동차 보험에 관심이 있는 사람을 놓치는 상황을 최대한 줄이기 위해서 **재현율**이 가장 높은 `LGBM`모델을 최종 예측 모델로 설정하였다. `LGMB`모델에서는 재현율이 0.93으로 실제로 자동차보험에 관심이 있는 사람들은 대부분 예측을 통해 맞출 수 있음을 알 수 있었다. 그리고 최종 예측 모델에 대한 특성들의 역할을 보기 위하여 순열 중요도을 확인했고, 중요한 특성들이 최종 예측 모델에 어떠한 영향을 주었는지 `PDP plot`을 통해서 확인해보았다. 그 결과 특정 나잇대, 특정 지역에서 자동차 보험에 관한 관심이 높음을 확인할 수 있어 이 사실을 마케팅 전략으로 활용하여 좀 더 효과적인 마케팅 방법을 구상할 수 있지 않을까 생각해본다.
# Reference
[Source Code](https://github.com/jingwoo4710/2020_project/blob/main/Solo_project_2_%EC%9D%B4%EC%9E%AC%EC%9A%B0.ipynb)
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.