codestates / codestates/ds-blog
[오예은] 머신러닝에서의 순열 특성 중요도 이해하기
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
# Permution Importance
우리가 요리를 할 때 어떤 재료를 넣느냐에 따라서 마지막에 만들어진 음식의 맛이 좌우되곤 합니다.
머신러닝에서도 예측모델을 만들 때 어떤 특성들이 들어가느냐에 따라 모델의 성능에 차이를 보이곤 하는데요,
모델의 성능에 중요한 영향을 미치는 특성들을 뽑아낼 수 있는 방법 중 한 가지를 소개하고자 합니다.
## 순열 중요도(Permutation Feature Importance)란?
- 순열 특성 중요도는 Breiman(2001)이 랜덤 포레스트를 제안한 논문에서 소개한 개념입니다.
- 한번에 한 개의 특성 값을 무작위로 섞어 특성와 실제 결과 사이의 관계를 없애고 모델의 예측 오차 증가를 측정하여 특성의 중요도를 판단하는 방식입니다.
- 특성 값을 섞었을 때 모델 오류가 증가하는 경우 이 특성은 모델의 예측에 “중요”합니다. 반대로 특성의 값을 섞었는데 모델이 예측에 대해 특성이 무관한 경우 “중요하지 않은”이 특성이 됩니다.
## Feature importance와의 차이점
- 어떤 특성이 가지(tree)에서 몇번 등장하는지, 혹은 불순도를 얼마나 낮추는 지에 대한 지표입니다. 쉽게 말해서 트리를 만드는 과정에 어떤 특성이 가장 중요한지 평가하는 것을 말합니다.
- 이 중요도는 특정 변수가 모델을 구성하는 비율로 측정하는데요, 각 특성의 중요도는 0~1 사이의 값을 가지고 전체를 합하면 1이 됩니다.
- 하지만 이 방법의 단점이 있는데 -영향을 주는 특성을 알수 없다는 것과 cardinality가 높은 경우 특성의 중요도가 높게 나와 해당 특성을 사용했을 때 모델을 과적합으로 만들 수 있다는 것입니다.
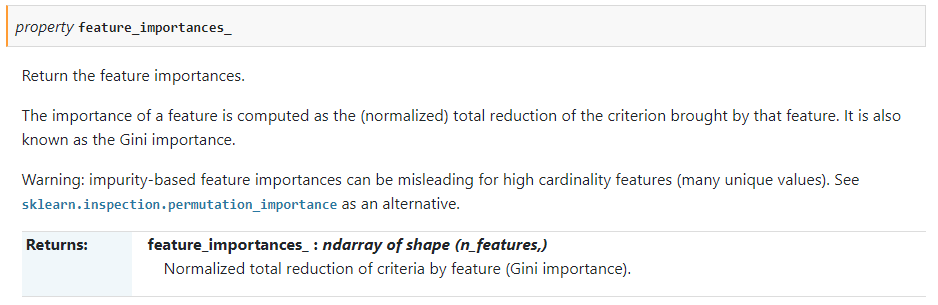
> 사이킷런에서는 이런 점을 보완하는 방법으로 순열 중요도를 언급함
- 하지만 여전히 feature importance와 permution importance를 해석할 때 주의사항으로
랜덤 포레스트에서 두 개 이상의 특성이 서로 상관관계가 깊다면, 하나는 아주 잘 잡아내지만 다른 정보는 잘 찾아내지 못할 수 있다는 점이 있습니다.
## 파이썬으로 순열중요도 출력해보기
실제로 머신러닝에서 어떻게 순열중요도를 활용할 수 있는지 간단한 예제로 보여드리겠습니다.
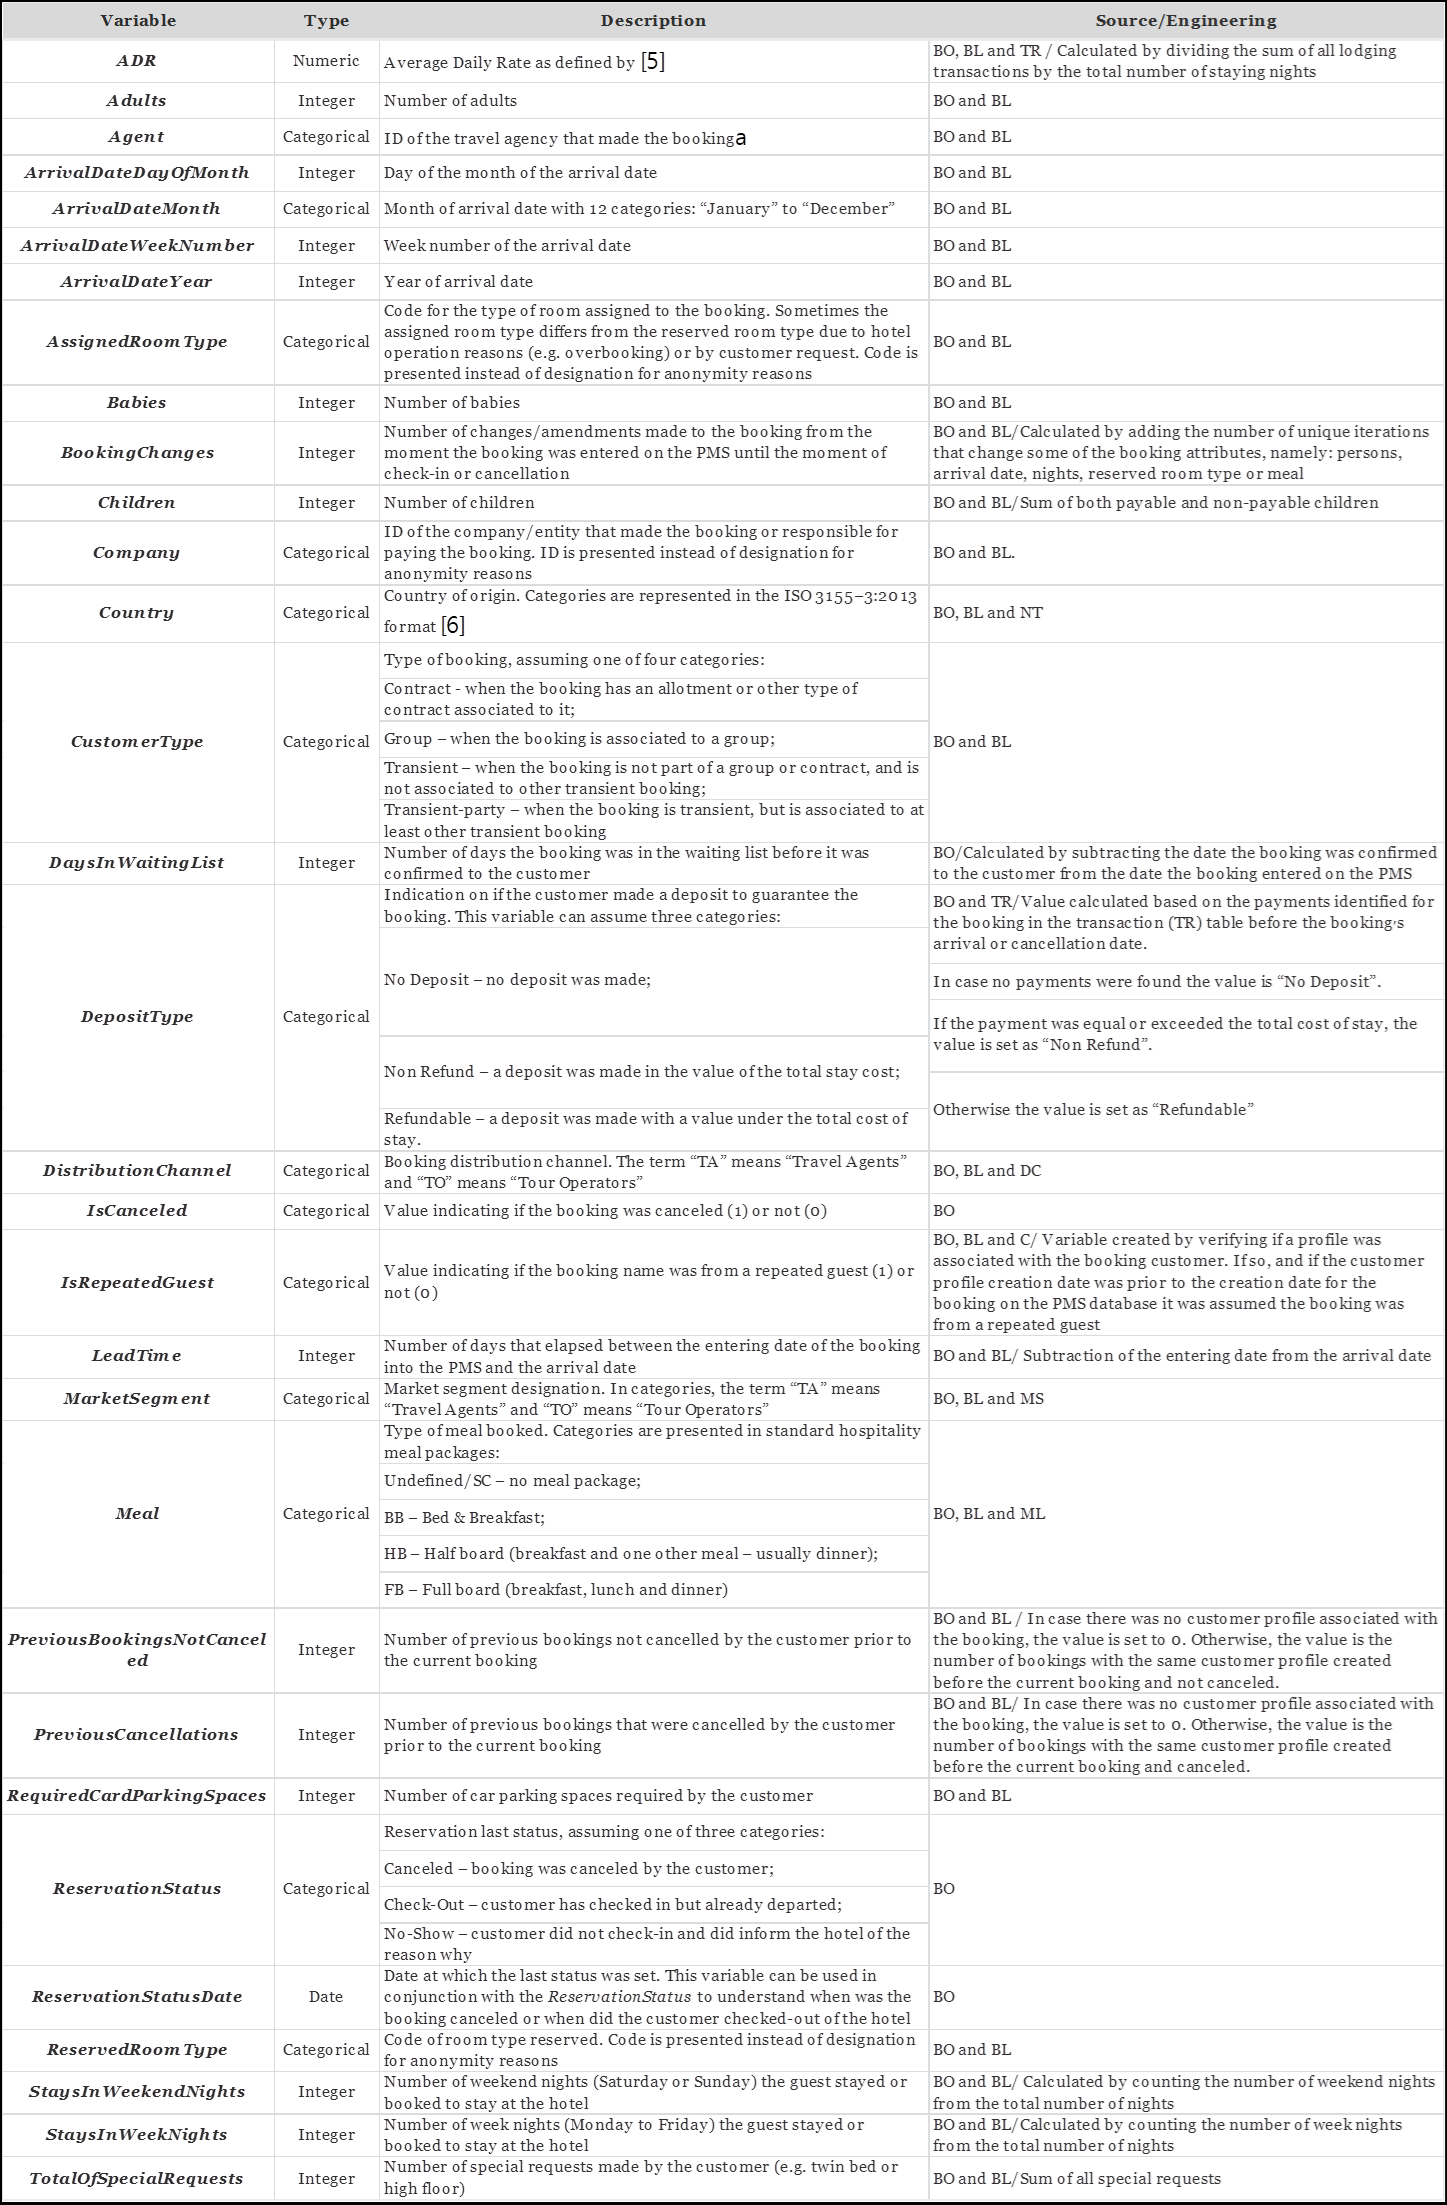
* 예제에 활용할 데이터는 호텔 예약 정보로, 이 데이터를 통해 예약 취소를 예측하는 모델을 만들어 순열 중요도를 측정해보겠습니다.
(데이터 출처: https://www.kaggle.com/jessemostipak/hotel-booking-demand)
- 데이터 분할 : 학습(64%), 검증(16%), 테스트(20%) 데이터
- 타겟 특성: 'is_canceled'
- 특성 정보
### [작성한 코드]
```py
import eli5
from eli5.sklearn import PermutationImportance
from sklearn.pipeline import Pipeline
# pipeline 생성
pipe = Pipeline([
('preprocessing', make_pipeline(OrdinalEncoder(), SimpleImputer())),
('xgb_model', XGBClassifier(n_estimators=1000, max_depth=7, learning_rate=0.2, n_jobs=-1))
])
# 모델 학습
pipe.fit(X_train, y_train)
# permuter 정의
permuter = PermutationImportance(
pipe.named_steps['xgb_model'], # model
scoring='accuracy', # metric
n_iter=5,
random_state=2)
# 검증데이터 transform
X_val_transformed = pipe.named_steps['preprocessing'].transform(X_val)
# 중요도 계산
permuter.fit(X_val_transformed, y_val)
# 특성리스트 만들기
feature_names = X_val.columns.tolist()
pd.Series(permuter.feature_importances_, feature_names).sort_values()
# 특성별 score 확인
eli5.show_weights(
permuter,
top=None,
feature_names=feature_names
)
```
### [실행결과]
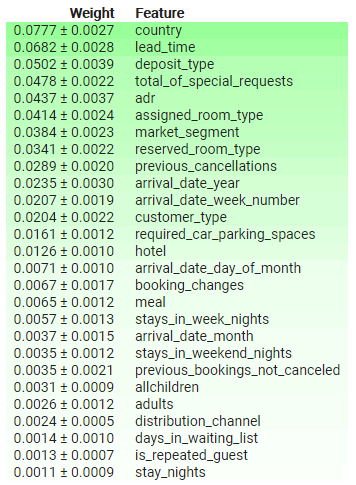
이 데이터에서 취소를 예측할 때 가장 중요한 특성 5개를 살펴보면,
이 모델이 예측한 예약 취소는 국가(country), 예약부터 도착일까지 걸리는 기간(lead time), 예치금 종류(deposit type), 특수요청사항(total_of_special_requests), 객실요금(adr)의 영향을 받습니다.
이렇게 나온 결과를 바탕으로 중요한 특성 위주로 모델을 학습시키면 모델의 성능을 높일 수 있을 것입니다.
반대로, 학습한 모델을 순열중요도 결과를 모델을 설명하는 자료로 사용할 수도 있을 것입니다.
* 참고사이트
[GoLab](http://machinelearningkorea.com/2019/08/13/%EC%88%9C%EC%97%B4-%ED%8A%B9%EC%84%B1-%EC%A4%91%EC%9A%94%EB%8F%84-permutation-importance/)
[Kaggle - Permutation Importance](https://www.kaggle.com/dansbecker/permutation-importance)
[ELI5](https://eli5.readthedocs.io/en/latest/blackbox/permutation_importance.html)
https://eair.tistory.com/24
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.