codestates / codestates/ds-blog
[김태헌] Permutation Importances(순열 중요도)계산
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
나는 이제까지 특성을 선택할때 correlation matrix를 사용했는데 이게 처음 사용할때는 특성고르기 엄청 편하고 좋다 생각했었다.
하지만 순열 중요도를 배워버렸다는거..물론 주의해야하는 부분들이 있지만 매우 직관적이고 주의해야하는 부분도 조금만 꼼꼼히 확인한다면 큰 문제없는 아주 좋고 편한 기능이다. 어떤 특성을 사용해서 모델을 만들지 모르는 사람들은 꼭 참고하면 좋을것같다.
순열 중요도에는 3가지 방법이 있다. 이제부터 하나씩 알아보도록 하자.
## 1. Feature Importances(Mean decrease impurity, MDI)
sklearn tree기반 분류에서 디폴트로 사용되는 특성 중요도이다.
속도는 방법 3가지중에 가장 빠르지만, 결과를 주의해서 살펴야한다(이후 설명). 각각의 특성을 모든 tree에 대해 평균불순도 감소를 계산한 값이다.
예시를 위해 사용한 데이터는 [kaggle 은행 이탈데이터](https://www.kaggle.com/shrutimechlearn/churn-modelling)를 사용했습니다.
```py
# 불필요한 features 제거
df = df.drop(["RowNumber", "CustomerId", "Surname", "Geography"], axis = 1)
# 새로운 feature 생성
# 신용점수가 평균이하이면서 비교적 경재력이 낮은 여성의 이탈율이 높을수 있다는 예측을 하며, 이 둘을 합쳐 새로운 특성을 만든다.
df["Below_average_Fe"] = df[["CreditScore", "Gender"]].apply(lambda x : 1 if x["CreditScore"] <= 650
and x["Gender"] == "Female" else 0, axis = 1)
```
저는 전처리 과정에서 "RowNumber", "CustomerId", "Surname", "Geography"특성을 제거하고 새로운 특성, `Below_average_Fe`를 만들었습니다. 이부분 참고하며 밑의 과정을 봐주세요.
```py
pipe = make_pipeline(
OrdinalEncoder(),
SimpleImputer(),
RandomForestClassifier(n_estimators = 100, random_state = 2, n_jobs= - 1)
)
```
pipe line을 만들어주고, 하이퍼파라미터(n_estimators = 100, random_state = 2, n_jobs= - 1)는 본인 마음대로? 좀더 자유롭게 만져도 됩니다. 물론 값은 더 좋아질수도 더 나빠질수도 있습니다!
이제 한번 특성 중요도를 확인해보겠습니다.
```py
# 특성 중요도
rf = pipe.named_steps['randomforestclassifier']
importances = pd.Series(rf.feature_importances_, X_train.columns)
%matplotlib inline
import matplotlib.pyplot as plt
n = 20
plt.figure(figsize=(10,n/2))
plt.title(f'Top {n} features')
importances.sort_values()[-n:].plot.barh();
```
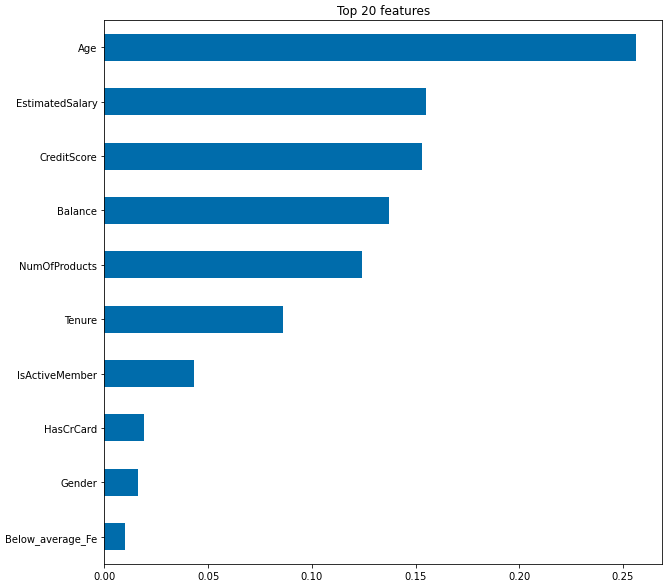
이러한 그래프를 불러낼수있습니다!
그래프를 보면 `Age`의 중요도가 제일 높다고 나오지만, 위에서 얘기했지만 결과를 주의하며 살펴봐야합니다!
이 특성 중요도는 cardinarity가 높으면 중요도가 높다고 판단하는 성향이 있기때문에 그대로 사용할경우 과적합이 될수도 있습니다!
하나의 특성의 cardinarity를 알아보는 방법은 여러가지가 있지만, 간단히 알아보는 방법은 아래와 같습니다.
`len(X_train['Age'].value_counts())` = 70 으로 확인되었습니다. Age의 값의 개수가 70종류나 된다는 이야기입니다.
이와같이 직관적인 그래프로 쉽게 중요도를 확인할수 있으나 결과를 주의하며 확인해야합니다!
확인한 결과, `NumOfProducts` 과 `Tenure`이 각각 4개, 11개의 cardinarity를 가지고있으면서 중요도도 높은편이기때문에, 다음 과정에서는 이 둘을 사용해 보도록 하겠습니다.
## 2. Drop-Column Importance
두번째는 이론상으로는 아주 좋은 기능인 중요도 확인방법이지만, 특성을 drop한다음 fit을 다시 해야하는 과정이 있기때문에, 다른 확인방법에 비해 상대적으로 느리다는 단점이 있습니다. 확인할 특성이 n개 있다면, n + 1번 학습이 필요합니다.
```py
column = 'NumOfProducts'
# NumOfProducts 없이 fit
pipe = make_pipeline(
OrdinalEncoder(),
SimpleImputer(),
RandomForestClassifier(n_estimators=100, random_state=2, n_jobs=-1)
)
pipe.fit(X_train.drop(columns=column), y_train)
score_without = pipe.score(X_val.drop(columns=column), y_val)
print(f'검증 정확도 ({column} 제외): {score_without}')
# NumOfProducts 포함 후 다시 학습
pipe = make_pipeline(
OrdinalEncoder(),
SimpleImputer(),
RandomForestClassifier(n_estimators=100, random_state=2, n_jobs=-1)
)
pipe.fit(X_train, y_train)
score_with = pipe.score(X_val, y_val)
print(f'검증 정확도 ({column} 포함): {score_with}')
# NumOfProducts 포함 전 후 정확도 차이를 계산합니다
print(f'{column}의 Drop-Column 중요도: {score_with - score_without}')
```
얼핏보면 복잡해 보일수 있으나, 천천히 보면 해석은 간단합니다.
먼저 `NumOfProducts`특성을 포함하지 않은 상태에서 학습을 시킨다음 스코어를 계산하고, `NumOfProducts`특성을 포함하고 학습을 시킨다음 스코어를 계산합니다. 그 다음 이 둘을 빼면, 특성이 스코어에 얼마나 기여하는지를 알수있습니다.
쉽게 얘기해서 특성이 있을때와 없을때 점수가 얼마나 차이나는가를 확인하는 과정이라 생각하면 됩니다.
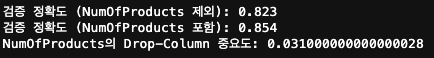
결과를 보면, NumOfProducts가 없을때 0.823, 있을때 0.854로 대략 0.03정도 차이가 있는데, 이는 꽤나 큰 차이라고 볼수있습니다.
82%와 85%는 아주 큰 차이입니다.
여담으로 다른 특성, `Tenure`의 중요도를 계산해보겠습니다.
```py
column = 'Tenure'
# Tenure 없이 fit
pipe = make_pipeline(
OrdinalEncoder(),
SimpleImputer(),
RandomForestClassifier(n_estimators=100, random_state=2, n_jobs=-1)
)
pipe.fit(X_train.drop(columns=column), y_train)
score_without = pipe.score(X_val.drop(columns=column), y_val)
print(f'검증 정확도 ({column} 제외): {score_without}')
# Tenure 포함 후 다시 학습
pipe = make_pipeline(
OrdinalEncoder(),
SimpleImputer(),
RandomForestClassifier(n_estimators=100, random_state=2, n_jobs=-1)
)
pipe.fit(X_train, y_train)
score_with = pipe.score(X_val, y_val)
print(f'검증 정확도 ({column} 포함): {score_with}')
# Tenure 포함 전 후 정확도 차이를 계산합니다
print(f'{column}의 Drop-Column 중요도: {score_with - score_without}')
```
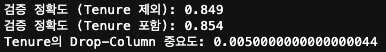
있을때와 없을때의 차이가 0.005이다. 이정도 수치라면 엄청 중요하진 않지만 어느정도 영향을 준다고 판단할수있다.
## 3. 순열중요도(Permutation Importance, Mean Decrease Accuracy,MDA)
마지막은 순열중요도이다. 첫번째 중요도 계산과 다른점은, 계산하고자하는 특성에만 무작위로 노이즈를 주고 예측을 했을때, 성능 평가지표(정확도, F1 score, R2)가 얼마나 감소하는지 측정합니다.
Drop-Column Importance는 특성의 중요도를 확인하기위해 특성을 제거하고 재학습을 시킨다면, 순열중요도는 특성을 제거하지 않고, 특성값에 노이즈를 주어, 기존의 정보를 사용하기 힘든 상태를 만들어 무력화 상태에서 성능을 측정하여 중요도를 확인합니다.
여기서 말하는 노이즈를 주는 방법중 가장 간단한 방법은, 특성의 값을 무작위로 섞는것입니다.
예제로 설명하도록 하겠습니다!
위에서 확인했었던 NumOfProducts를 사용해 알아보겠습니다.
```py
# 변경 할 특성을 선택합니다
feature = 'NumOfProducts'
X_val[feature].head()
```
```py
# 특성의 분포를 확인합니다
X_val[feature].value_counts()
```
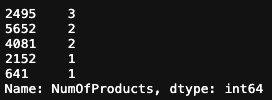
1부터4까지 각각의 값의 개수를 알수있습니다.
1은 1021개, 2는 906개, 3은 57개, 4는 16개.
```py
# 특성의 값을 무작위로 섞습니다
X_val_permuted = X_val.copy()
X_val_permuted[feature] = np.random.RandomState(seed=7).permutation(X_val_permuted[feature])
```
이때 seed는 랜덤 범위를 고정시켜주는 역할을 합니다. 실행 시킬때마다 다른값이 나오는 경우를 방지하기위해 7에 해당되는 구역에 고정한다 생각하면 쉬울듯하다.
```py
# 특성 값의 순서가 뒤바뀐 것을 확인합니다
X_val_permuted[feature].head()
```
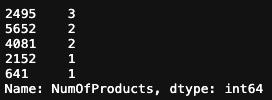
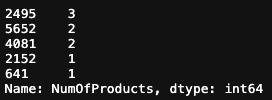
맨 위의 결과와 비교해보면 같은 인덱스의 값이 바뀐것을 알수있다.
2495 3 -> 1
5652 2 -> 1
```py
# 카테고리들의 분포는 바뀌지는 않았음을 확인합니다
X_val_permuted[feature].value_counts()
```
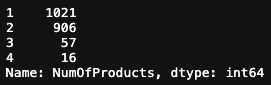
하지만 1부터 4의 개수는 바뀌지 않았다. 똑같은 범위내에서 값들만 바뀐것이다.
```py
# 순열 중요도 값을 얻습니다. (재학습이 필요 없습니다!)
score_permuted = pipe.score(X_val_permuted, y_val)
print(f'검증 정확도 ({feature}): {score_with}')
print(f'검증 정확도 (permuted "{feature}"): {score_permuted}')
print(f'순열 중요도: {score_with - score_permuted}')
```
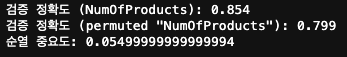
drop의 과정보다 중요도가 더 올라 0.05가 되었다. 확실히 NumOfProducts는 중요한 특성인듯합니다.
**이런식으로 분명 각각 필요한 상황에 쓸수있도록 만들어졌겠지만 아직 나는 적극적으로 사용해보지 않아 어떤 상황에서 어떤 방법이 좋은지는 알수없습니다.. 좀더 다양한 데이터에 사용해보고 더 자세한 예제를 만들어보도록 하겠습니다.**
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.