codestates / codestates/ds-blog
[윤현태] Data Dilemma, 예측 가능한 데이터 vs 예측 불가능한 데이터
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
# 들어가며...
데이터 사이언티스트를 꿈꾸는 당신, 몇가지 데이터들을 다뤄보고, 회귀분석이나 분류 분석을 시행한 다음, 자신감에 차있다.
"이제 이 세상 데이터들은 내가 다 처리할 수 있어!"
그야 당연하다. 범주형 데이터들은 인코더들이 알아서 머신러닝 모델들이 이해할 수 있도록 바꿔주고, 모델들의 파라미터는 내가 일일히 찾을 필요도 없이 RandomSearchCV, GridSearchCV등을 사용해서 하이퍼 파라미터를 찾아준다!(~~대신 시간과 컴퓨터를 바쳐야 겠지만~~) 그래서 다음 사냥감을 물색중인 당신, 먼저 눈에 들어온 것은 농구 데이터였다.
"흠, 그래. 조던과 르브론의 비교라. 재밌겠는데?"
## test case 1. 팀 경기
1. 데이터의 train set과 test set 정하기
target을 정하기는 쉽다. 경기 결과를 target으로 하고, feature들은 각 선수가 게임에서 펼쳤던 stat이 되겠다. 여기서 한가지 의문이 든다. 그러면 test set은...? 조던의 경기결과를 학습시킨 모델에 조던 데이터를 넣으면, 얼마나 '조던스러운지'를 보는 거고, 르브론 모델에 르브론 데이터를 넣으면, 얼마나 '르브론스러운지'를 보는 건가? 아! 생각해보니 이건 르브론과 조던을 비교하는 거니까, 서로의 데이터를 바꿔서 모델에 집어 넣으면 되겠다!
2. 결론
검증가설: 르브론과 조던중 누가 더 팀의 승리를 많이 할 수 있을까?
target: 경기결과
features: 경기 후 스탯들
train set: 조던과 르브론의 경기 후 스텟 데이터
test set: 조던과 르브론의 경기후 스텟 데이터
일단, 여기에서 의문이 든다. 여기서 모델이 학습하는 것은 '조던은 이러이러한 스텟을 찍었 때는 이기고, 이러이러한 스텟을 찍었을 때는 진다.' 라면, 결국 르브론의 데이터를 쓴다고 하더라도 '조던의 경우에서' 얼마나 더 이기는 지, 아니면 조던의 데이터를 써서 '르브론의 경우에서' 얼마나 더 이기는지가 의미가 있을까?
우리는 너무나도 많은 것을 고려하지 못한다. 당시 게임의 상황, 상대팀에는 누가 있고, 우리팀에는 누가 있는지, 누가 컨디션이 좋은지, 즉, model이 되는 대상과, 그 주변의 것들을 완전히 배재하고 단순히 스텟만을 놓고 보는 것이다.
여기서 또 하나의 의문이 든다. 그러면 경기 결과를 에측하고 싶으면 어떻게 하지?
##test case 2. 개인 경기
조금더 극단적인 예를 들기 위해서, 다른 사람들의 결과를 신경 쓸 필요가 없고, 오로지 개인의 스텟에만 초점을 두는 데이터가 있다고 하자. 대표적으로 테니스 단식 경기가 있다. 페더러의 승률은 1242승 271패 (82.1%), 나달의 승률은 999승 201패 (83.24%) 다. 둘의 통산 전적은 막상막하. 하지만 상대전적은 23승 14패로 나달이 크게 앞서고 있다. 그러면 경기 결과에 대한 데이터를 생각해보자. 결국 테니스는 상대보다 포인트를 더 많이 따고, game, set가 더 높아야 이기는 게임이고, 이는 자연스럽게 경기에서 성공시킨 공격의 수와 비례한다. 그러니까 결국, 경기 결과를 가지고 예측 하는 것은 매우 바보같은 일이 아닐 수 없다. 이긴 선수의 결과는 당연히 높을 것이고, 진 선수의 결과는 당연히 낮다. 한 예로, 이긴 선수들과 진 선수들의 서브 에이스에 대한 비교다.
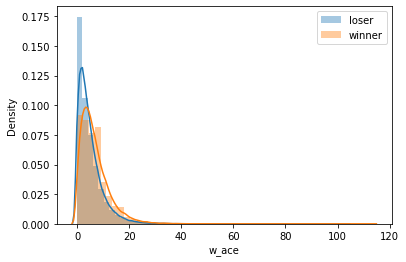
그래프를 확인 해 보면, 이긴 선수들의 서브 에이스 수가 진 선수들의 서브 에이스보다 대체적으로 높은 것으로 나타났다.
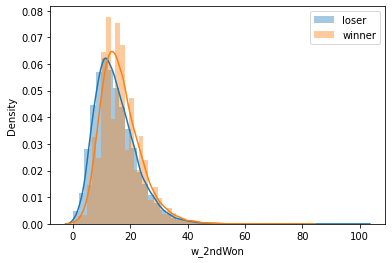
2번째 서브 에이스 역시도 마찬가지다. 이긴 선수들의 서브 에이스 수가 더 높다.
이처럼, 모델링을 돌리기 전에도 우리는 이미 이긴사람의 지표가 훨씬 더 좋을 거라는 것을 알 수 있다.
그러면 테니스의 경기 결과만을 놓고 우리는 다음 승부에 대한 예측을 할 수 있을까?
결론은 '할 수 없다'가 되겠다. 이긴 사람의 지표가 당연히 좋은 것은 둘째 치고서라도 애초에 테니스에서 공격의 성공률, 방어의 성공률, 이 모든 것들이 그때 그때 상황에 따라 달라지기 때문이다. 당장 테니스에서 선수들에 대한 서브 성공률, 포핸드 성공률, 방어 성공률은 서로 다른 상황과 서로 다른 선수들에게서 얻은 데이터들을 일일히 모은 것에 지나지 않기 때문이다.
그러면 여기에서, 우리가 예측을 하려면 어떻게 해야할까?
우선, 지금까지 했던 경기들을 통해 우리는 그 선수가 어디에 강점이 있는지 정도는 알 수 있다. 이것을 baseline probablity로 보고, 게임이 진행 되면서 '관찰되는' 데이터들을 통해 누가 더 점수를 얻을 확률이 높은 지를 알아내는 것이다. 즉, feature의 값들은 경기 도중에서 얻는 정보들이 될 것이고, target은 정보를 얻은 그 다음 상황에 누가 점수를 얻는 지를 판별하는 것이 될 것이다.
다시 한번 정리히자면, 경기가 끝난 결과에 대한 데이터가 중요한 것이 아니고, **경기가 진행되는 과정에서 얻는, 시간의 흐름에 따라서 변화되는, 관찰된 데이터들**을 보고 그것을 통해서 **다음 시간에 어떤 일이 일어날지를 예측**하는 것이다.
## 마치며
이미 결과가 일어난 뒤에 모인 데이터와, 결과가 확정되지 않은 체 단순히 관측되어진 데이터는 뭐랄까, 아직도 내게는 말장난 같기도 하다. 그리고 내가 데이터를 다룬지 고작 2개월 밖에 되지 않았기 때문에, 이 부분에 대해서는 조금 더 공부가 필요하다. 기껏 제목은 멋지게 지어놨는데, 앞으로 내가 DS boot camp를 진행하면서 조금씩 더 알아가는 만큼, 여기에 추가를 할 예정이다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.