codestates / codestates/ds-blog
[최근후] 데이터 랭글링의 단계!
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
# 데이터 랭글링이란?
데이터로부터 인사이트를 얻기위해 데이터 분석 또는 머신러닝을 하기위해선, raw data를 탐색, 정제, 변형 하는 등의 전처리가 필요합니다. 데이터 랭글링은 그러한 작업들을 일컫는 말인데, 즉, 쉽게말해 데이터를 분석하기쉽게 위해 변형/맵핑 하는 과정이라고 보시면 됩니다.
이러한 데이터 랭글링 과정은 실전 데이터 분석에서 대부분의 시간을 차지한다고 합니다 ㅎㅎ.. 저도 조금씩 느끼고 있는데요, 이번주에 제가 머신러닝을 위해 사용했던 데이터는 81개의 피쳐가있어서 하나하나 읽어보고 이해했다고 생각했지만 나중엔 또 까먹고 다시읽어보는 과정을 여러번 반복했답니다...ㅠㅠ
하지만 이렇게 무시무시한 데이터 랭글링은 데이터 분석에서 피할수 없는 과정이라고 하니, 한번 자세히 알아보겠습니다!
# Steps of Data Wrangling
### 1. Discovering (탐색)
 이 단계에선 EDA가 포함됩니다. 데이터를 파악하고, 변수간의 상관관계를 이해합니다. 데이터가 어떻게 사용 될 것인지 생각합니다. 이 단계에선 도메인 지식이 필요하니, 도메인 지식을 쌓는것도 이 단계의 과정이라고 할 수 있겠네요!
> 도메인 지식 쌓기
> 데이터분포 파악
> 어떤 데이터가 필요한지/필요없는지 이해
---
### 2. Cleaning (정리)
일관성없는 데이터를 처리하고, 분석/모델의 성능에 방해가 될만한 요소를 처리합니다.
> 결측치 처리
> 이상치 처리
> 이상한 데이터 처리 (예를들면 사람의 몸무게가 음수로 되어있는것)
> 통합할 데이터가 있다면 데이터 형식 통일
---
### 3. Structuring/Enriching (구조화/풍부하게하기)
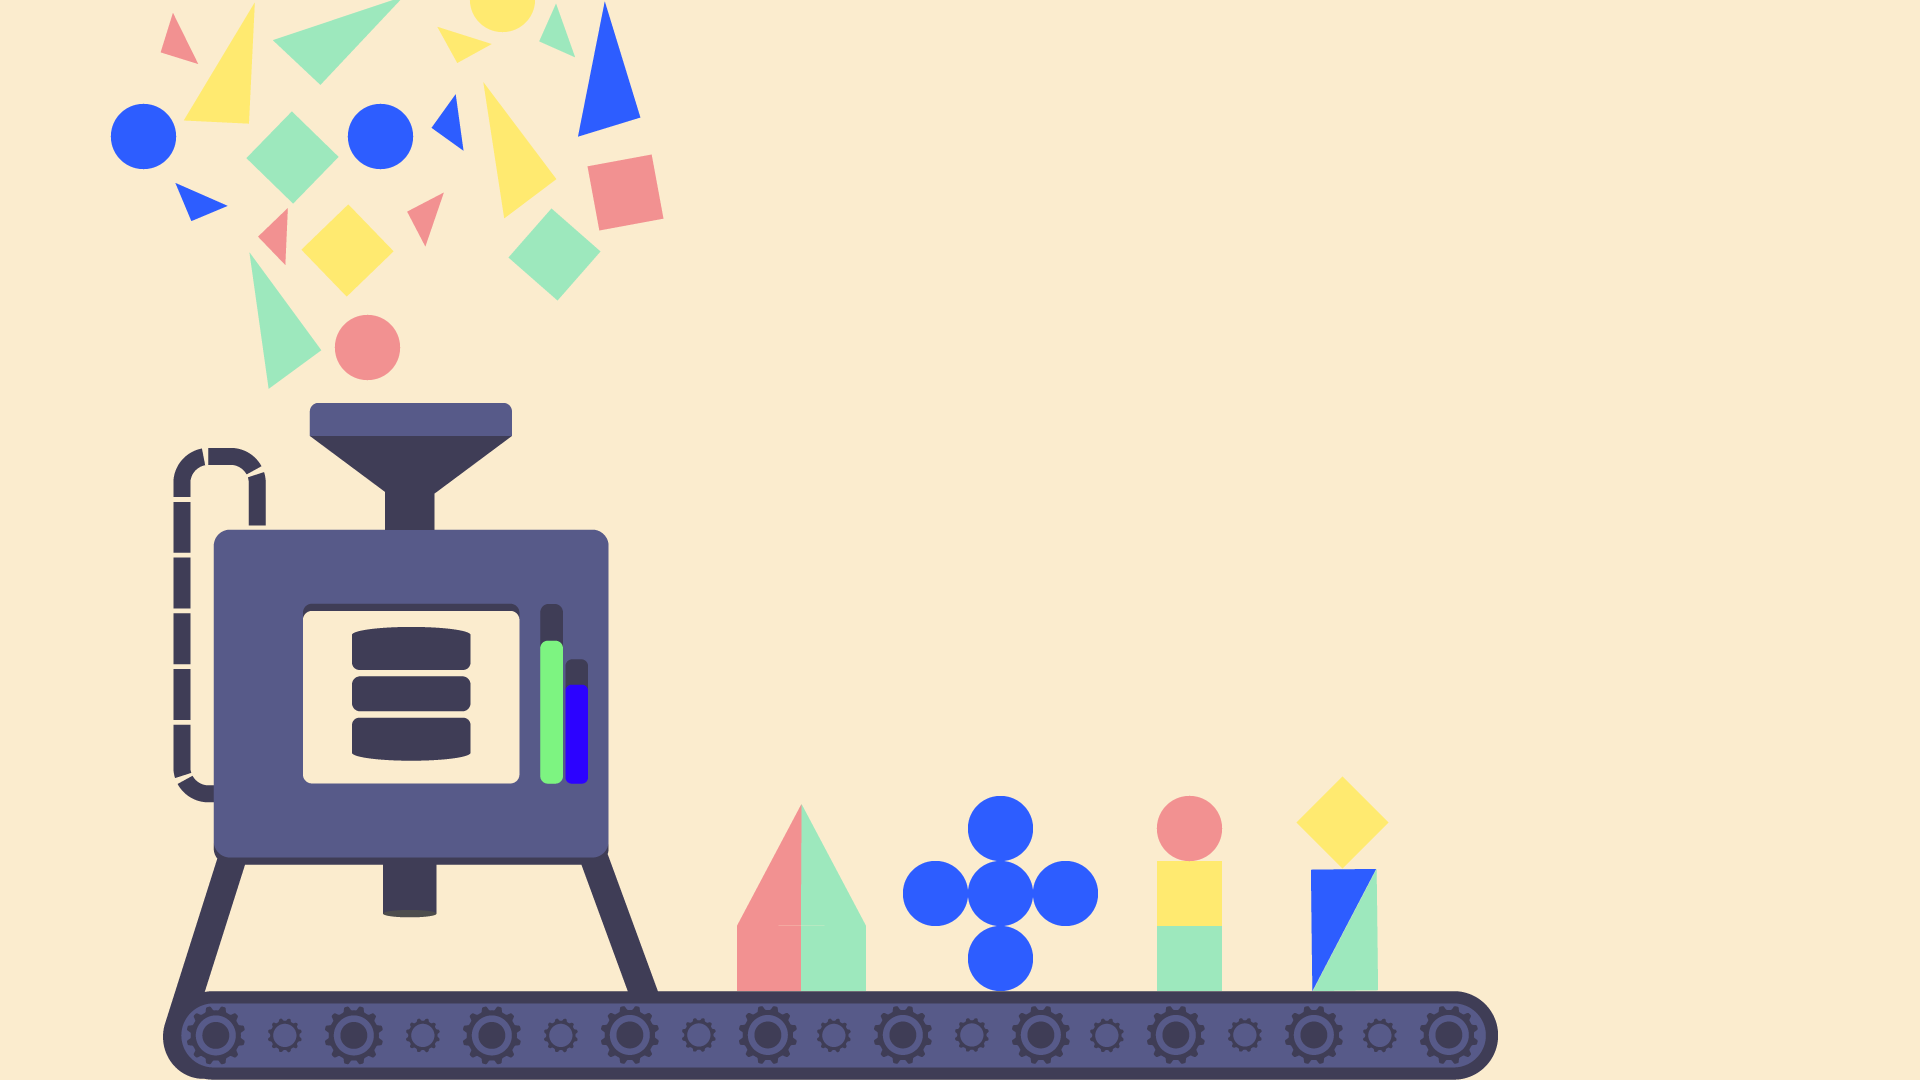
데이터분석/머신러닝에 적합하게 데이터를 재구성하기 및 데이터 내부 또는 외부 데이터를 통합하여 분석 범위를 확대.
> 데이터 통합
> 데이터 인코딩
> 새로운 피쳐 만들기
.
위 작업이 끝난 후, 도출하고싶은 인사이트에 맞게 적절히 데이터가 꾸려졌는지 확인하는 과정도 필요합니다!
---
## 마치며..
데이터 과학자가 종종 75%까지 시간을 할애한다는 데이터 랭글링은 자칫 귀찮은 과정이라고 여겨질 수 있는데요, 이것을 적절히 수행해야 데이터를 기반으로 더 나은 통찰력을 이끌어낼 수 있습니다.
현실에서 결점 없는 데이터를 얻는 경우가 드물고, 특히, 기술이 빠르게 변화하는 시대엔 더욱 그러합니다. 데이터 랭글링은 모델 선택과 같은 데이터 사이언스의 다른 단계만큼 흥미롭지는 않을 수도 있지만, 이것의 중요성을 간과해서는 안됩니다.
우수한 데이터 분석가가 되기위해선, 데이터를 잘 이해하며, 필요할땐 다른 데이터를 통합하며, 일반적인 데이터구조 문제를 해결하며, 데이터를 정리하는 방법을 알아야겠습니다!
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.