codestates / codestates/ds-blog
[김지연]부트스트래핑과 랜덤 포레스트(Bootstrapping and Random Forest)
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
오늘 머신러닝에서 분류, 회귀 분석, 검출을 하기 위해 사용하는 **랜덤 포레스트** (Random Forest)에 대해 알아볼 것이다.
랜덤 포레스트는 **배깅** (Bagging)을 이용한 앙상블 학습법이다. 앙상블 학습법은 학습모델(Weak Base Learning)을 여러 개 만들어 각 학습모델의 예측결과로 평균을 내거나 다수결을 계산해 예측을 하는 것이다.
학습 모델을 여러 개 만들 수 있는 이유는 한 데이터세트를 **부트스트랩** (Bootstrap)해 만들어진 수많은 부트스트랩 데이터세트로 각각의 학습 모델을 만들기 때문이다.
여기서 부트스트랩이란 한 데이터세트에서 **뽑았던 샘플을 또 뽑을 수 있는 복원추출**을 하여 n개의 새로운 데이터세트를 만들어 내는 것이다. 그렇게 만들어진 데이터세트들을 학습모델에 적용하여 학습 결과를 합치는(Aggregation) 과정을**B**ootstrap **Agg**regation , 배깅 Bagging이라고 한다.
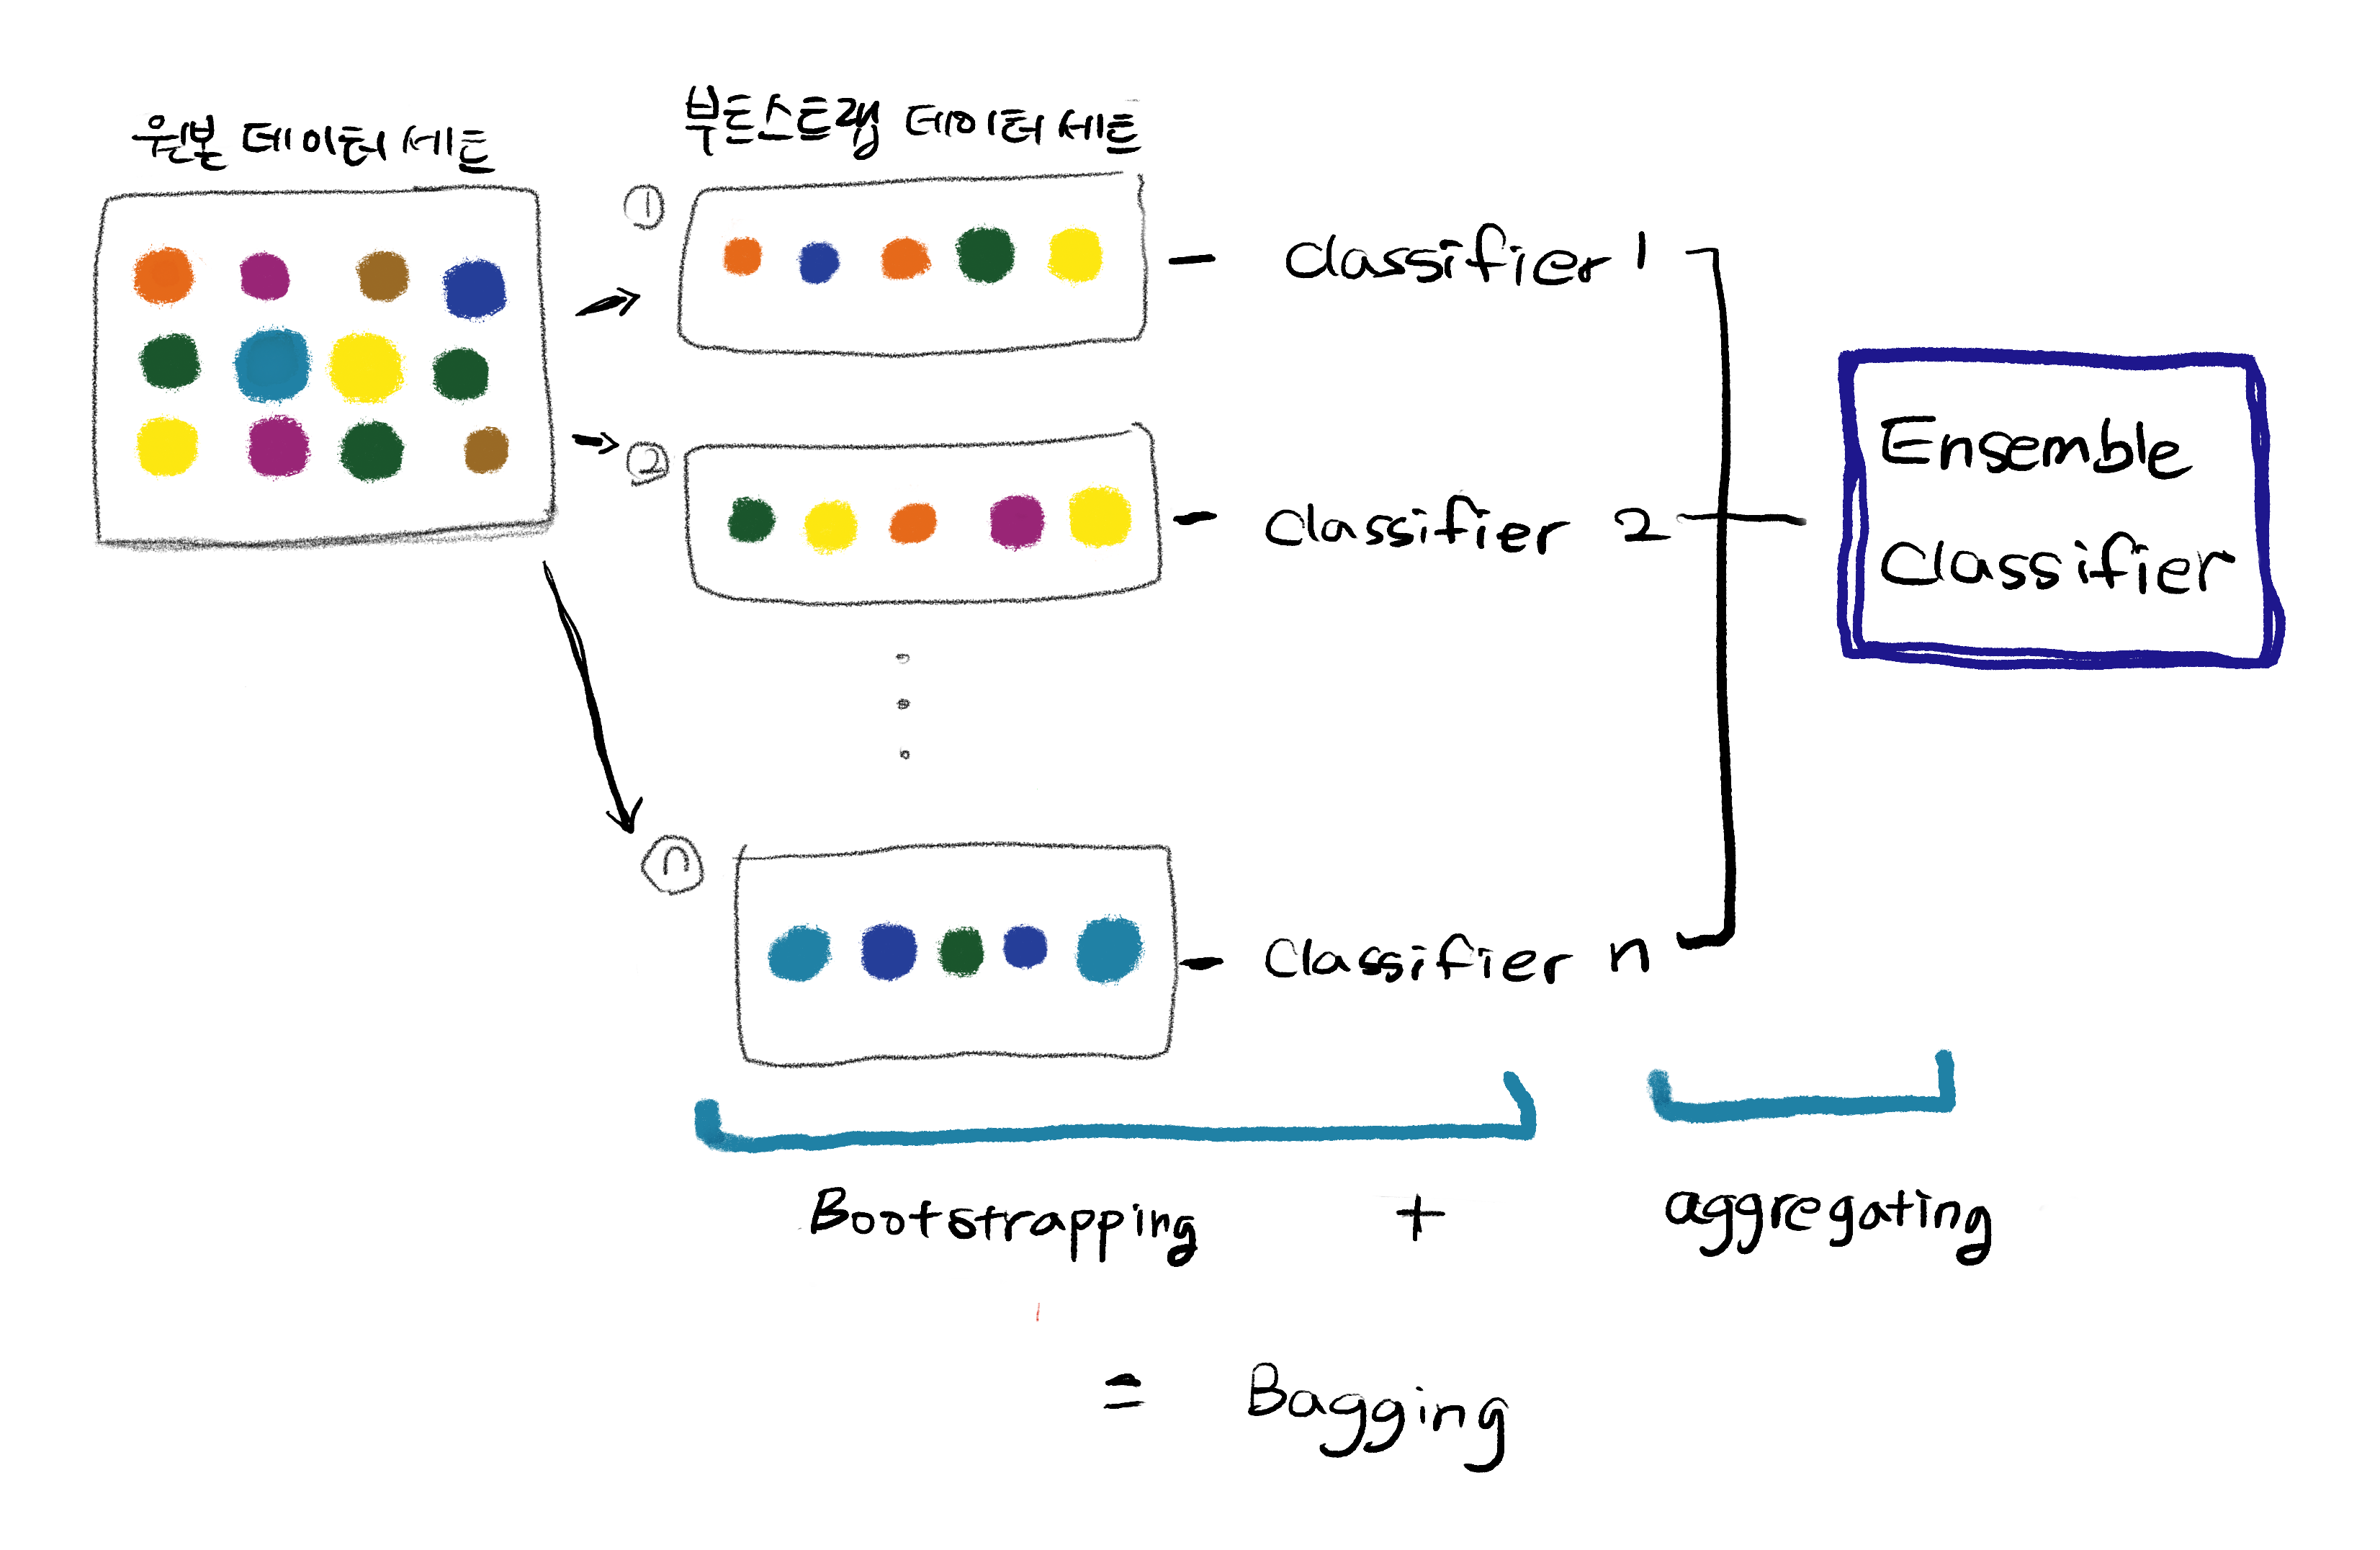
하지만 이렇게 한 데이터세트를 부트스트랩하면 그 데이터세트의 샘플중 1/3은 뽑히지 못하고 부트스트랩 데이터세트에 포함되지 않는다. 그런 샘플을 Out-of-Bag(OOB)라 부른다. 뽑히지 못한 OOB들은 쓸모가 있다. 만들어진 모델의 테스트 데이터로 사용할 수 있다는 것이다. 그렇기 때문에 랜덤 포레스트를 쓸 땐 데이터세트를 학습/시험 두 가지 세트로 나누지 않아도 된다.
그렇다면 이렇게 만들어진 랜덤 포레스트의 장점으로는 무엇이 있을까?
첫 번째, 과적합하는 결정트리의 분산을 낮춰 과적합을 피하고 일반화 성능을 높일 수 있다는 점이다.
두 번째, 데이터의 표본 수가 적을 때 부트스트랩함으로써 새로운 표본 데이터를 무한대로 만들어 낼 수 있다.
개미들도 집단지성을 통해 사람보다 훨씬 크고 복잡한 개미집을 만들어 낸다. 인간 사회에서도 다양한 분야에서 집단지성이 빛을 발한다. 이처럼 머신러닝에서도 하나의 학습 모델보다 여러 학습 모델이 합쳐진 랜덤 포레스트가 단일의 결정트리보다 더 좋은 성능을 발휘하는 것은 꽤나 흥미롭다.
Contributor guide
No contributing guide indexed for this repository
Research direction
Start by reading the Korean article in the issue and confirming whether the intended work is publication, editing, or review; no repository file or test is named. Done should be an agreed, maintainer-approved article with an explicitly defined scope.
Written by the indexing model from the issue text.
Assessment
- Tech stack
- machine-learning
- Domain
- documentation, machine-learning
- Issue type
- Documentation
- Difficulty
- 3/5
- Estimated time
- 1-2 days
- Activity status
- Stale
- Clarity
- Needs clarification
- Newbie friendliness
- 30/100