codestates / codestates/ds-blog
[윤현태] 마이클 조던 VS 르브론 제임스, 누가 더 GOAT 인가?
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
### The G.O.A.T
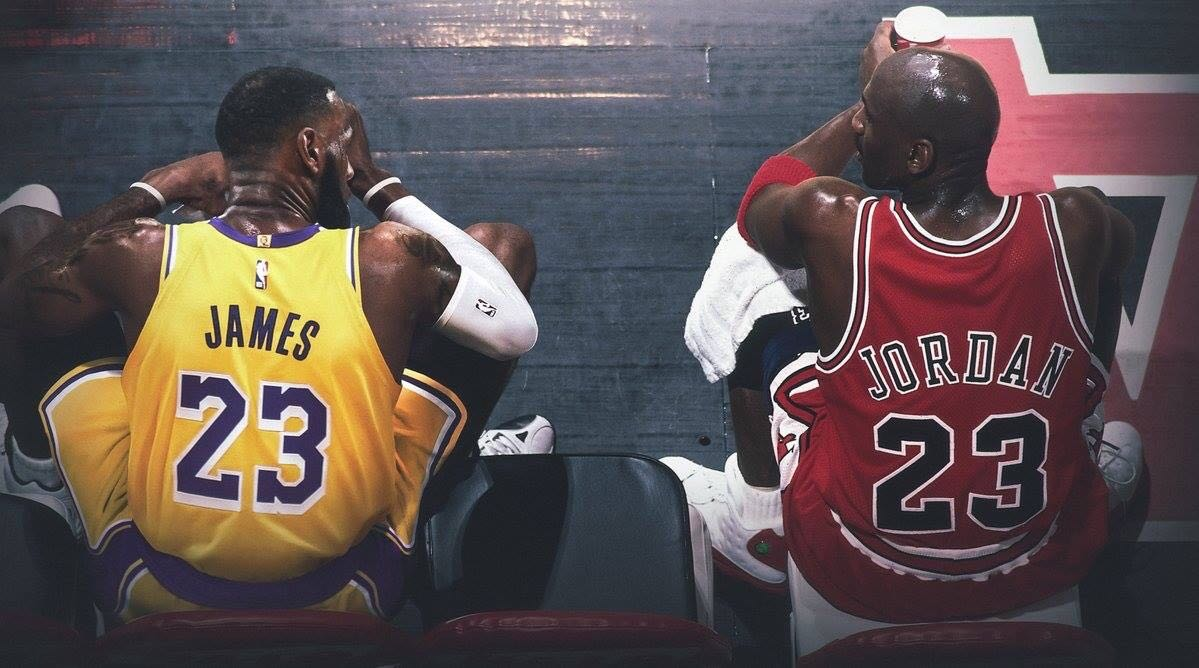
The Greatest of All Time. 스포츠 종목을 불문하고, 사람들은 이것에 대해서 이야기 하기를 즐긴다. 누가 가장 뛰어난 플레이어일까? 축구는 호날두 메시, 테니스는 페더러와 나달, 배구는 김연경, 그러면... 그러면 농구는? 농구하면 떠오르는 것은 Micheal Jordan, A.K.A air jordan. 한 때 한국에서 에어조던 신발 신드롬을 일으켰고, 중력을 무시하는 듯한, 자유투라인에서 뛰어오르며 성공시킨 덩크, 그리고 그보다 더 많은 화려한 플레이로 유명한 마이클 조던과, 너무 많이, 그리고 너무 잘 뛰어서 항상 그자리에 그대로 있는 것 같은, 냉동인간을 보는 것 같은 르브론 제임스. 그래서 둘은 항상 사람들의 비교 대상이 되었다.
실제로도, 둘의 비교는 엄청나고, 많은 사람들의 관심사이다.
그래서 나는 생각했다.
**르브론과 조던이 서로의 스탯을 바꾸면 승패에 얼마나 영향을 미칠까?**
# 들어가기전에, 내가 사용한 Tool, data
##tool
### Random forest
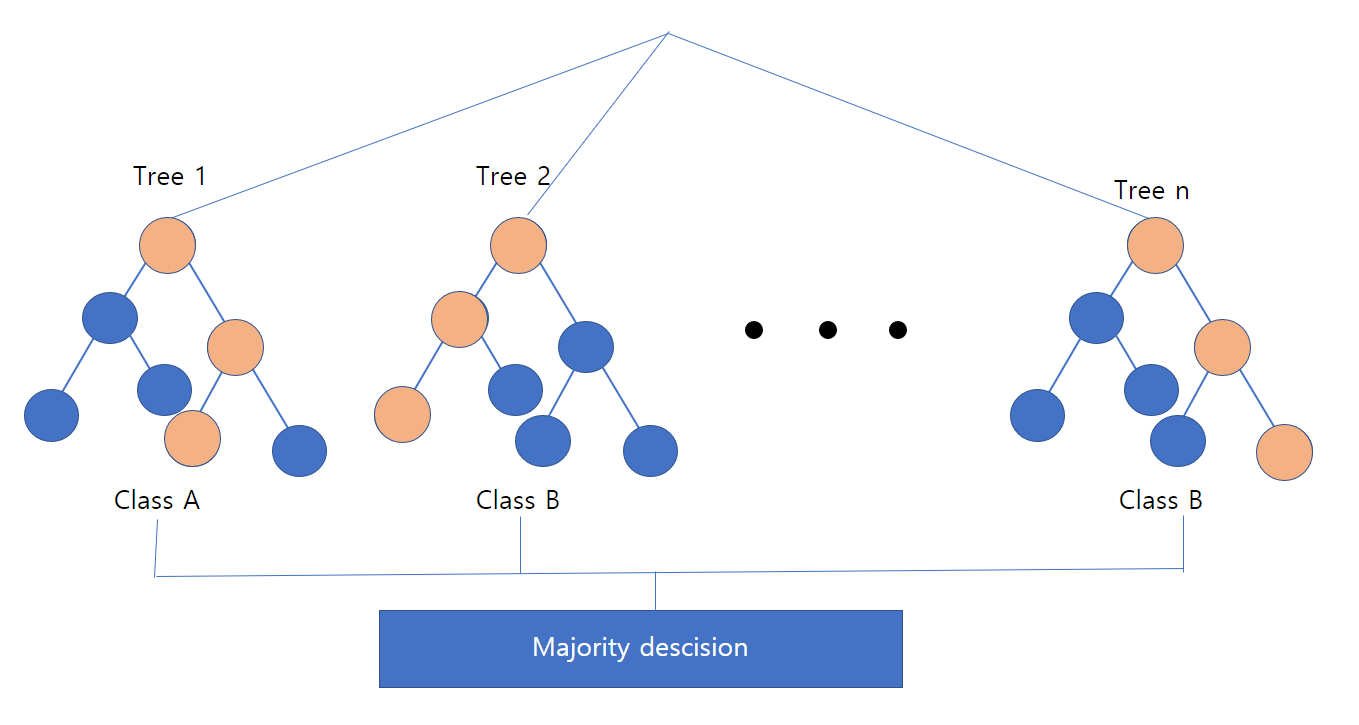
Random forest는 분류, 회귀 분석 등에 사용되는 앙상블 학습 방법의 일종으로, 훈련 과정에서 구성한 다수의 결정 트리로부터
그룹 또는 평균 예측치를 통해서 데이터들을 분류시키는 방법이다. decisiontree는 트리가 하나여서 유연성이 떨어지지만, random forest는 트리의 갯수를 늘림으로써 조금 더 폭넓은 예측을 할 수 있도록 도와준다.
##data
### Jordan vs Lebron
kaggle에 있는 jordan vs Lebron 데이터를 적극 활용했다. nba_api도 있지만 무엇보다 데이터를 받는 속도가 느리기 때문에 kaggle에 있는 데이터를 사용하기로 했다.
### Data 분석 및 feature engnieering
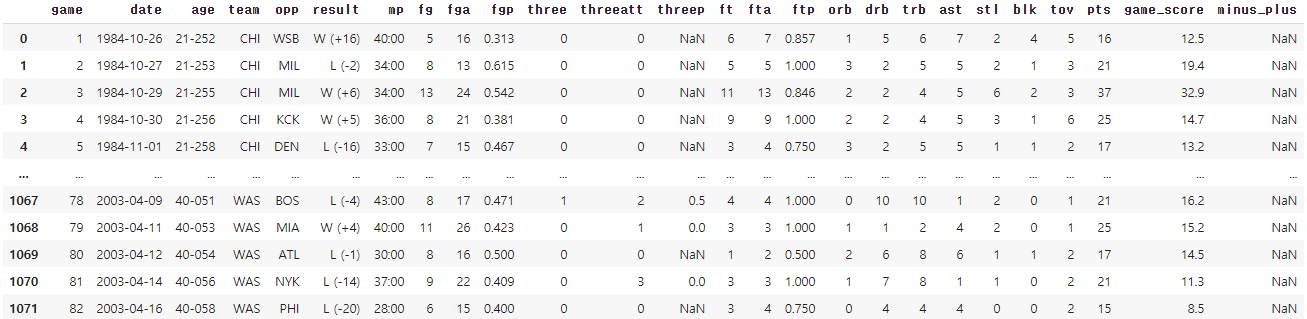
먼저, 농구를 잘 모르는 사람이 있을 수도 있기 때문에, 여기서 feature들이 무엇을 의미하는지를 먼저 설명하고 넘어가야겠다.
우선 game은 각 시즌에 몇번째 게임인지를 나타내고, date, team(현재 소속팀), opp(상대팀),result(경기결과)를 제외하고 설명을 하도록 하겠다.
mp: Minute Played, 몇분 동안 게임을 뛰었는지를 나타낸다.
fg: field goal, 인게임 상황에서 슛을 던져서 몇 번을 성공시켰는지를 나타낸다. 자유투는 제외한다.
fga: field goal Attempt 인게임 상황에서 슛을 몇번 던졌는지를 나타낸다. 자유투는 제외한다.
fgp: fg/fga, 슛 성공률을 나타낸다.
three: 3점슛을 던져서 몇번을 성공시켰는지를 나타낸다. fg에 포함된다.
threeatt: 3점슛을 몇번 던졌는지를 나타낸다.
threep: 3점슛 성공률을 나타낸다. 3점슛을 시도하지 않았으면 자료가 없기 때문에 NaN으로 표시한다.
ft: 슛도중 파울을 얻었을 때 자유투를 얻게 되는데, 슛을 성공시키면 엔드원으로 한번, 성공시키지 못하면 슛 시도 위치에 따라 2번, 또는 3번의 자유투 기회가 주어진다. ft는 자유투 성공횟수이다.
fta: 자유투 시도 횟수이다.
ftp: 자유투 성공확률이다. 자유투를 던진 적이 없으면 NaN으로 표시된다.
orb: offense rebound. 즉 공격코트에서 슛이 던져젔을 때 림을 맞고 튀어오른 농구공을 잡은 횟수이다.
drb: dffense rebound. 즉 수비코트에서 슛이 던져젔을 때 림을 맞고 튀어오른 농구공을 잡은 횟수이다.
trb: total rebound, 전체 리바운드를 잡은 횟수이다.
ast: 슛이 성공되기 전에 마지막에 패스를 한 사람이 얻게 되는 도움 횟수이다. 축구의 assist를 생각하면 편하다.
stl: steel. 수비자가 공격자의 공을 뺏은 횟수를 나타낸다.
blk: 공격자의 슛을 수비자가 손을 비롯한 신체 부위를 사용해 공을 쳐낸 횟수이다.
tov: turn over. 공격자가 스틸을 비롯한 여러가지 이유로 공격권을 상대방에게 넘겨준 횟수이다.
pts: 그 경기에서 총 득점을 나타낸다.
game_score: 축구의 평점과 같다고 보면 된다. 10이면 평균적인 농구선수이고, 40이면 굉장히 잘했다고 평가를 받는다.
minus_plus: 선수가 게임을 뛰고 있을 때 점수차가 벌어졌는지, 줄어들었는지를 나타낸다. 잘 알 수 없으면 NaN을 표시한다.
## 모델링하기.
```py
import pandas as pd
jordan=pd.read_csv("jordan_career.csv")
lebron=pd.read_csv("lebron_career.csv")
jordan.drop(columns=['threep','game','date','team','opp','minus_plus'],inplace=True)
lebron.drop(columns=['threep','game','date','team','opp','minus_plus'],inplace=True)
```
먼저 데이터를 받는다. 그리고 필요 없는 date, game, team, opp와 너무 승패의 영향을 명확하게 보여주는 minus_plus는 제외시켰다. threep는 3점슛을 시도한적이 없을 수도 있기 때문에 NaN의 발생을 피하기 위해 제외시켰다.
##feature engineering
```py
import numpy as np
def engneering(df):
# @@:@@ 으로 표시되어있는 시간을 초로 바꿔준다.
time=df['mp'].str.split(':',n=2,expand=True)
time.columns=['m','s']
df['mp']=time['m'].astype('int')*60+time['s'].astype('int')
# 나이와 일수로 표시된 age를 분리시킨다. 일수는 나이에 365를 곱해 태어난 날 부터 세기로 했다.
df[['age','age_date']]=df['age'].str.split('-',n=2,expand=True)
df['age']=df['age'].astype('int')
df['age_date']=df['age_date'].astype('int')
df['age_date']=df['age_date']+df['age']*365
# team_minus_plus는 승패를 너무 명확하게 보여주기 때문에 제외시킨다.
df[['result','team_minus_plus']]=df['result'].str.split(' ',n=2,expand=True)
df['team_minus_plus']=df['team_minus_plus'].str.replace(pat='(',repl='')
df['team_minus_plus']=df['team_minus_plus'].str.replace(pat=')',repl='')
df['team_minus_plus']=df['team_minus_plus'].astype('int')
# df['minus_plus']=df['minus_plus'].replace(np.nan,0)
df['result'][df['result']=='W']=1
df['result'][df['result']=='L']=0
df['result']=df['result'].astype('int')
# 자유투를 시도한 적이 없을 때는 확률을 0으로 한다.
df['ftp']=df['ftp'].replace(np.nan,0)
return df
lebron=engneering(lebron)
jordan=engneering(jordan)
```
## 데이터 나누기
내가 하고 싶은 건 각각 르브론과 조던의 모델을 만드는 것이기 때문에, 데이터는 hold out으로 나누기로 결정했다. 따로 제외한 200개의 test 데이터는 서로의 모델을 평가할 때 쓰일 예정이다.
```py
from sklearn.model_selection import train_test_split
X_leb,X_leb_t=train_test_split(lebron,test_size=200,random_state=2)
X_jor,X_jor_t=train_test_split(jordan,test_size=200,random_state=2)
target='result'
features = lebron.drop(columns=[target,'team_minus_plus']).columns
y_leb = X_leb[target]
X_leb = X_leb[features]
y_jor = X_jor[target]
X_jor = X_jor[features]
y_leb_t = X_leb_t[target]
X_leb_t = X_leb_t[features]
y_jor_t = X_jor_t[target]
X_jor_t = X_jor_t[features]
```
## 모델 생성 및 평가
```py
from sklearn.ensemble import RandomForestClassifier
from sklearn.pipeline import make_pipeline
model_L=RandomForestClassifier(n_jobs=-1,n_estimators=200,min_samples_split=2,min_samples_leaf=10)
model_J=RandomForestClassifier(n_jobs=-1,n_estimators=200,min_samples_split=2,min_samples_leaf=10)
model_L.fit(X_leb,y_leb)
model_J.fit(X_jor,y_jor)
from sklearn.metrics import accuracy_score, recall_score, precision_score, f1_score
y_pred=model_L.predict(X_leb_t)
print(' model_L f1 검증 정확도: ',f1_score(y_leb_t, y_pred))
y_pred=model_J.predict(X_jor_t)
print(' model_J f1 검증 정확도: ',f1_score(y_jor_t, y_pred))
```
```py
model_L f1 검증 정확도: 0.8389261744966443
model_J f1 검증 정확도: 0.7843137254901961
```
지금 주어지는 데이터는 전부다 선수 개인의 성적을 기반으로 한 것이기 때문에, 르브론의 성적은 조금더 팀 성적과 연관이 되었고, 조던의 성적은 르브론보다는 조금 더 팀 성적과 연관이 없을 수도 있겠다는 생각이 들었다. 그럼 한 번 중요도를 살펴보자.
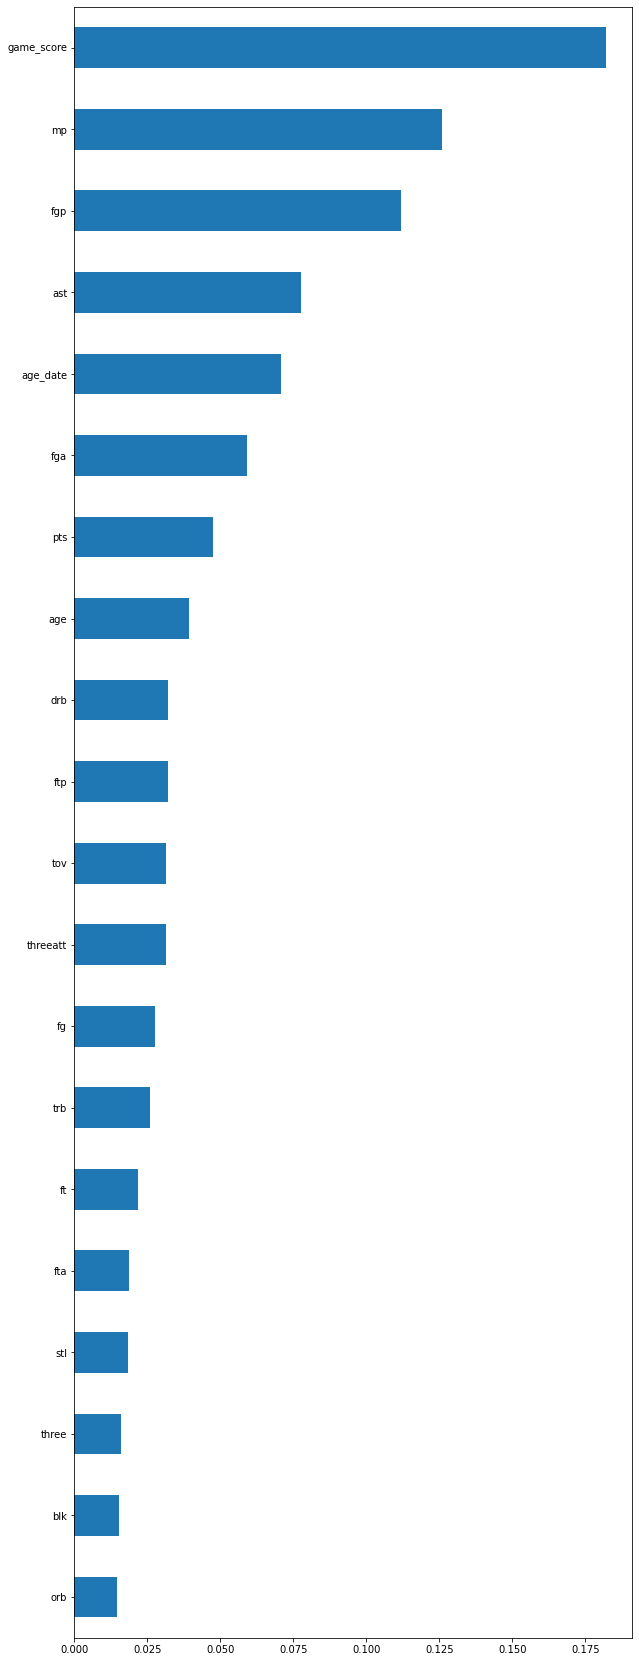
### model_L (르브론 제임스 모델) 특성 중요도 그래프
```py
import matplotlib.pyplot as plt
model_dt = model_L
importances_L = pd.Series(model_dt.feature_importances_, X_leb.columns)
plt.figure(figsize=(10,30))
importances_L.sort_values().plot.barh();
```
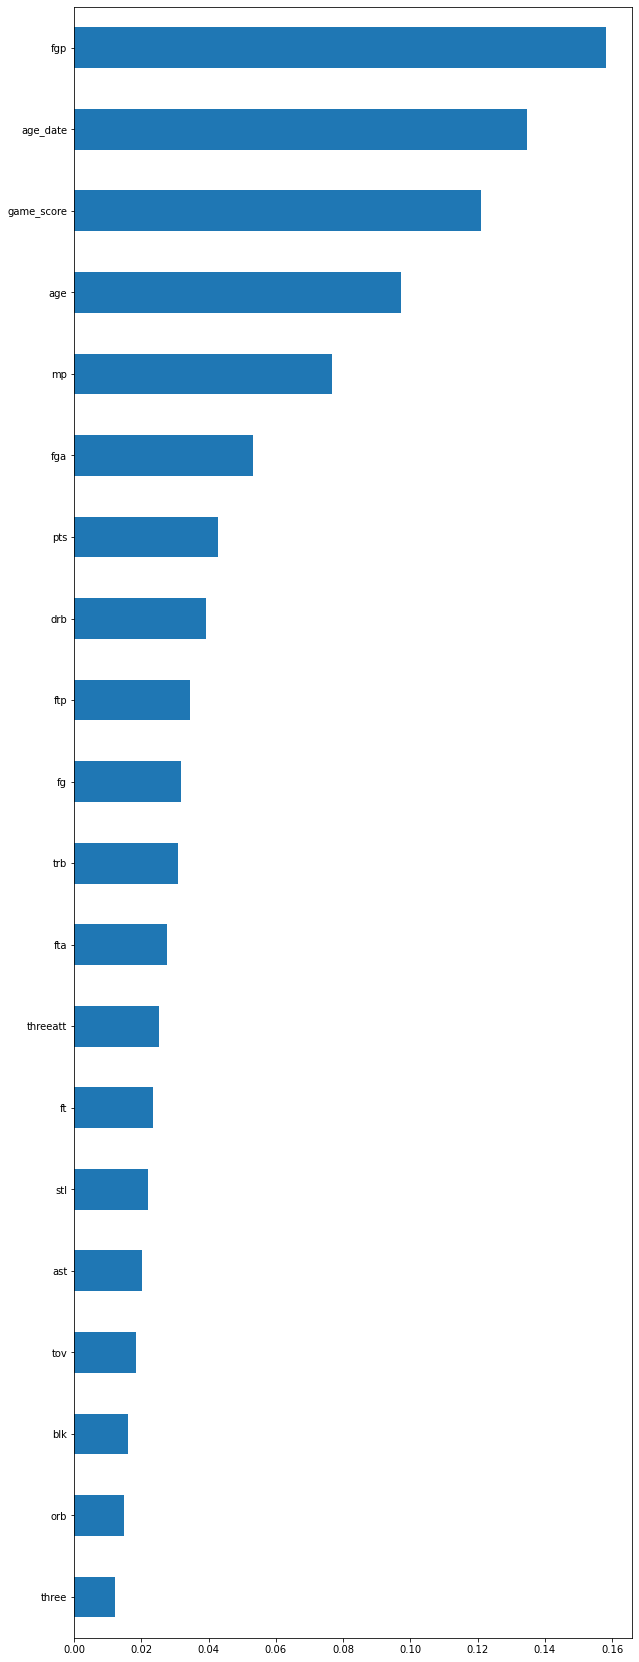
### model_J (마이클 조던 모델) 특성 중요도 그래프
```py
import matplotlib.pyplot as plt
model_dt = model_J
importances_J = pd.Series(model_dt.feature_importances_, X_jor.columns)
plt.figure(figsize=(10,30))
importances_J.sort_values().plot.barh();
```
## 특성 중요도 해석
중요도가 각 선수들의 특성을 어느정도 대표한다고 생각하는데, 마이클 조던은 나이를 먹으면 먹을수록 이길 확률이 높아진다. 심지어 **스리핏(연속 3번 우승)을 달성하고, 야구선수가 되는 것이 아버지의 소원이라며 잠깐 야구를 했다가 농구로 복귀 한다음 다시 한번 쓰리핏의 위업을 달성**한 것을 보면, 어떻게 이기는지에 대한 경험이 중요하게 작용했다고 생각한다.
그에 반해 르브론은 공수에서 모두 잘할 때 좀더 팀의 승리에 기여한다. 득점도 많이 하고, 수비도 많이 하려면 자연스럽게 출전 시간도 중요하고, 슛 성공률도 중요해 진다.
사실 가장 논란이 되는 것은, 각 팀원들의 활용에 있다. 조던의 동료였던 스코티 피펜이나 데니스 로드맨은 특정 부분에서 조던의 부담을 줄여주었고, 조던은 그래서 조금 더 효율적으로 공격을 할 수 있었다. 그러나 반대로 르브론은, **자기 자신이 무엇이든지 할 수 있기 때문에 자신의 영향력이 극대화 되어야 비로소 진가를 발휘하게 된다.** 그리고 이런 부분 때문에 실제로 르브론은 팀원들과 많은 마찰을 만들기도 했고, 또 다른 팀에서는 올스타급의 경기력을 갖춘 선수도 르브론이 있는 팀으로 오면 단순한 롤 플레이어로 쓰이는 경우가 있었다. 물론 그럼에도 불구하고 **NBA final 3회의 우승, 6번의 준우승을 달성했지만, 6번의 준우승에서는 르브론이 체력적인 부담을 느껴서 무너져서 지는 경우가 대부분이었다.**
## 모델 평가 및 해석
```py
y_pred=model_L.predict(X_jor_t)
print(' model_L data_jor f1 recall_score: ',recall_score(y_jor_t, y_pred))
y_pred=model_J.predict(X_leb_t)
print(' model_J data_leb f1 recall_score: ',recall_score(y_leb_t, y_pred))
```
```py
model_L data_jor f1 recall_score: 0.8439716312056738
model_J data_leb f1 recall_score: 0.7328767123287672
```
한번 서로의 스텟이 뒤바뀌었을 때 서로가 얼마나 팀을 우승으로 이끌 수 있는지를 확인해 보았는데, 조던의 데이터가 르브론의 데이터보다 무려 11%나 더 승리할 것이라고 예측을 하였다. 조심스럽게 추측하자면, 모델 조던에서 가장 큰 영향을 미치는 슛 성공률은 조던이 르브론 보다 높지만, 모델 르브론에서 가장 큰 영향을 미치는 game_score은 조던도 똑같이 높은 것은 아닐까 생각해본다.
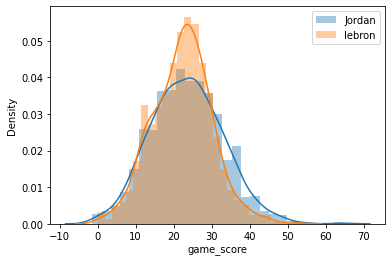
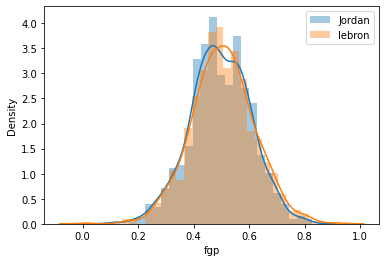
실제로도 분포를 살펴보면, 조던이 르브론 보다 game_score이 높았을 때가 조금 더 많은 반면, 르브론이 조던보다 슛 성공률이 좋은 적은 그다지 많이 없고, 거의 비슷하다. 이 차이는 fga(슛 시도)와 pts(득점)를 보면 조금 더 차이가 날 것이다.
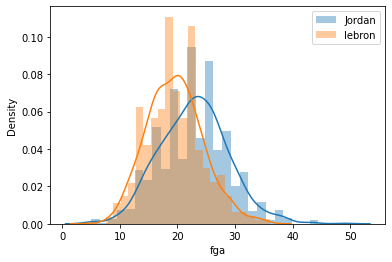
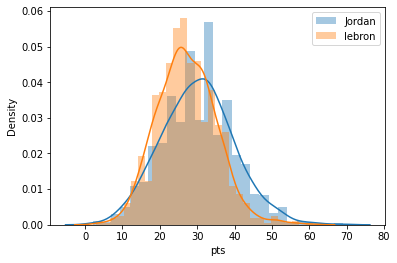
조던이 슛 시도도 훨씬 더 많았고, 득점도 대체적으로 많이 했다. 그래서 이런 차이가 벌어지지 않았나 추측해 본다.
# 맺으며
사실 이렇게 비교하는 것이 두 선수에 대한 실례라고 생각한다. 마이클 조던은 농구의 전설적인 존재지만, 르브론 역시 현재 역사를 써내려가고 있기 때문이다. 그래서 이런 평가는 재미로만 봐줬으면 하는 자그마한 바램이 있다. 다음에는 조금 더 과적합을 시켜서 모델을 진짜 르브론이나 조던 처럼 만들어 보는 것도 재미있겠다는 생각이 들었다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.