codestates / codestates/ds-blog
[최근후] Accuracy vs F1-score 무엇을 써야할까? (feat. 다중분류 모델)
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
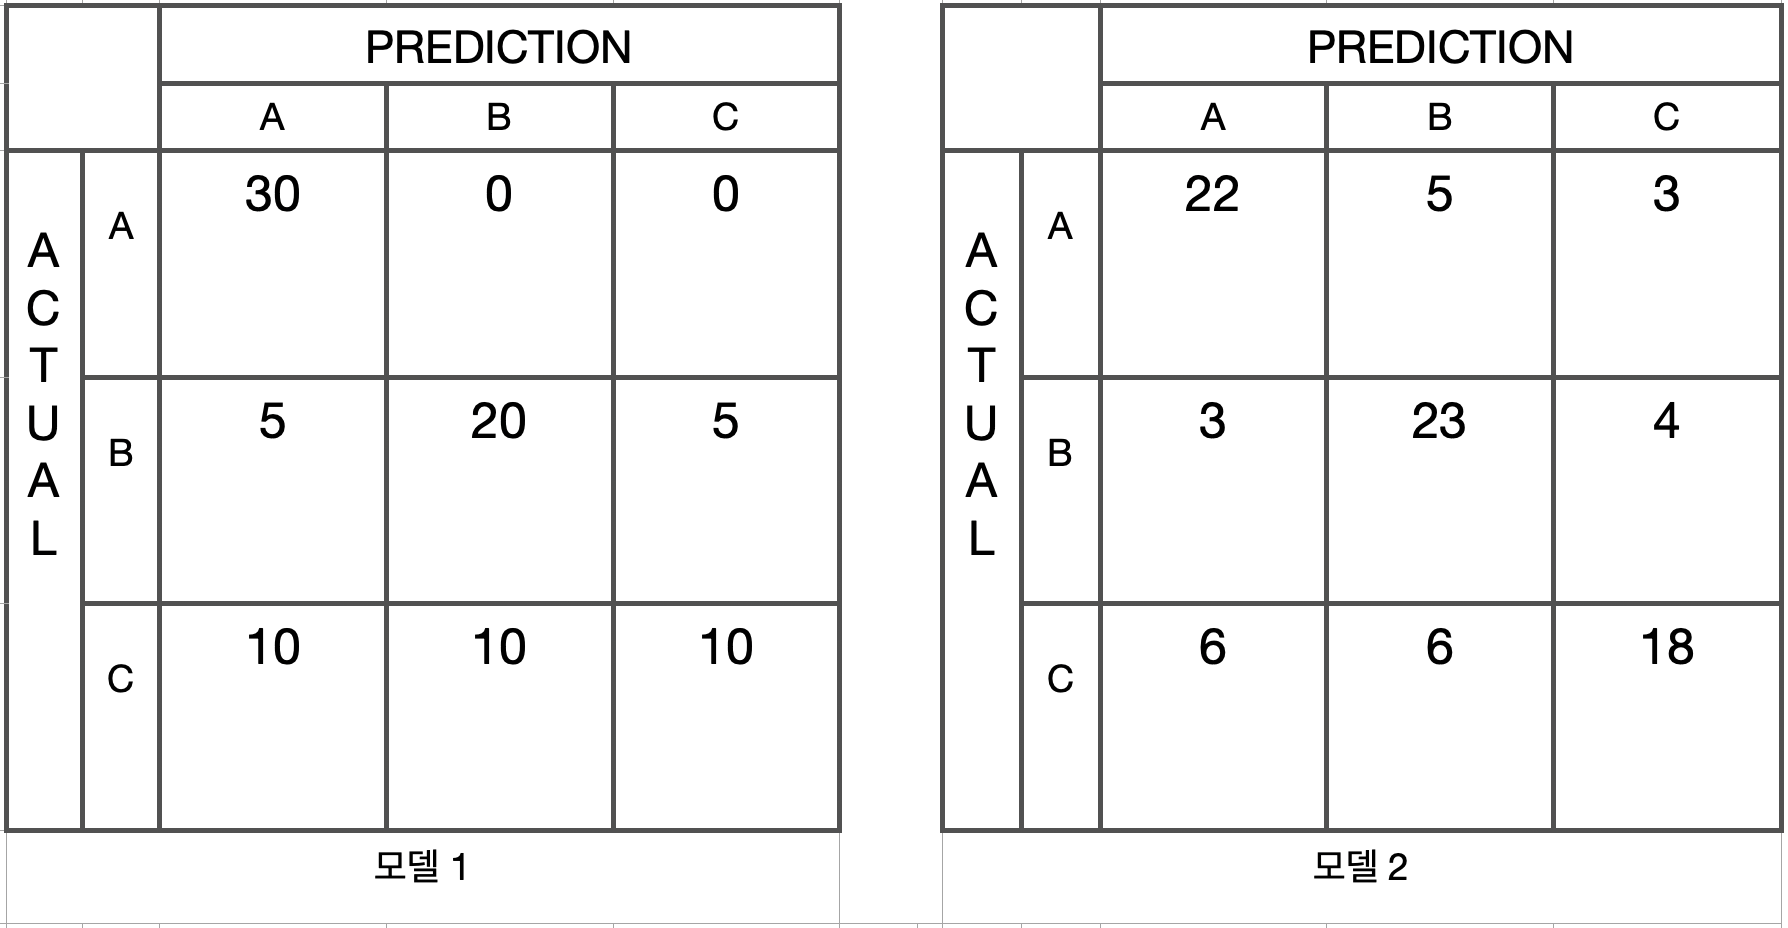
## 위의 모델 1과 모델 2중, 어느것이 더 예측을 잘한다고 말할 수 있을까요?
이것에 대답해기위해선 Accuracy와 F1-score를 알아야합니다! 그리고 Accuracy와 F1-score를 알아낼려면 이 네가지를 먼저 이해해야합니다.
* TP (True Positive) : 실제 Positive값을 Positive로 분류
* TN (True Negative) : 실제 Negative값을 Negative로 분류
* FP (False Positive) : 실제 Negative값을 Positive로 분류
* FN (False Negative) : 실제 Positive값을 Negative로 분류
이진분류에선 Confusion Matrix가 비교적 이해하기 수월하지만, 다중분류에선 조금 이해하기 까다로운 수 있으니 그림으로 보여드리겠습니다!
### 아래 그림은 A클래스에 대한 TP, TN, FP, FN가 다중분류 모델의 Confusion Matrix에 어떻게 나타나는지 보여주는 것입니다.
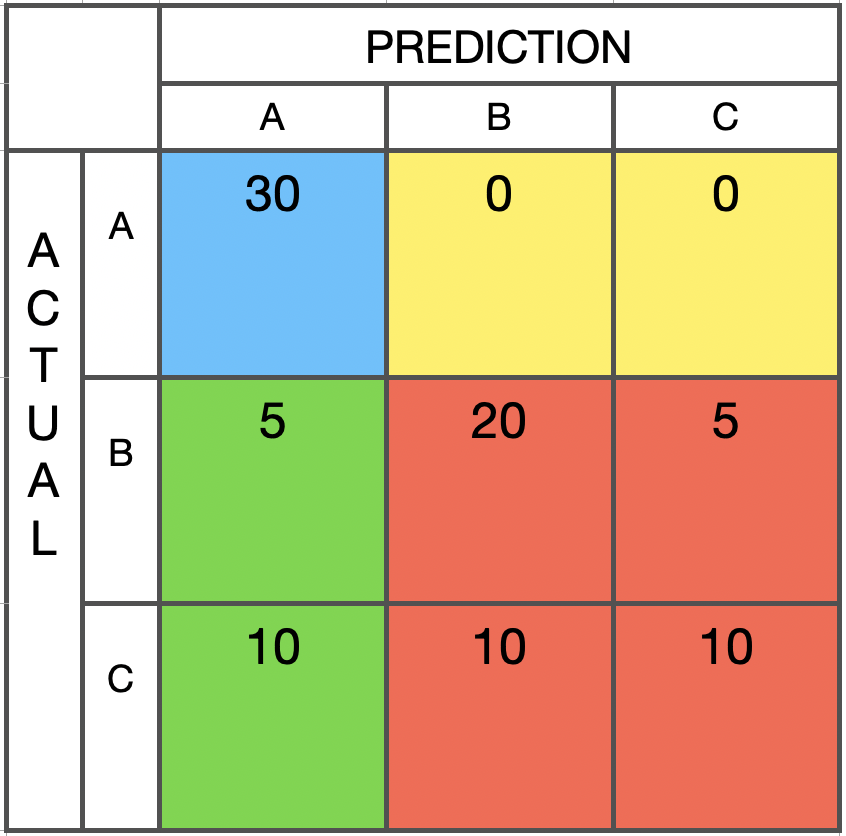
* A클래스에 대한 TP : 파랑
* A클래스에 대한 TN : 빨강
* A클래스에 대한 FP : 초록
* A클래스에 대한 FN : 노랑
## Accuracy : balanced한 데이터에 적합함
Accuracy(정확도) 는 분류모델에서 가장 흔히 쓰이는 measure이고, 이것은 전체 범주를 모두 바르게 맞춘 경우를 전체 수로 나눈 값입니다. 그림으로 구하는 방식을 보겠습니다.
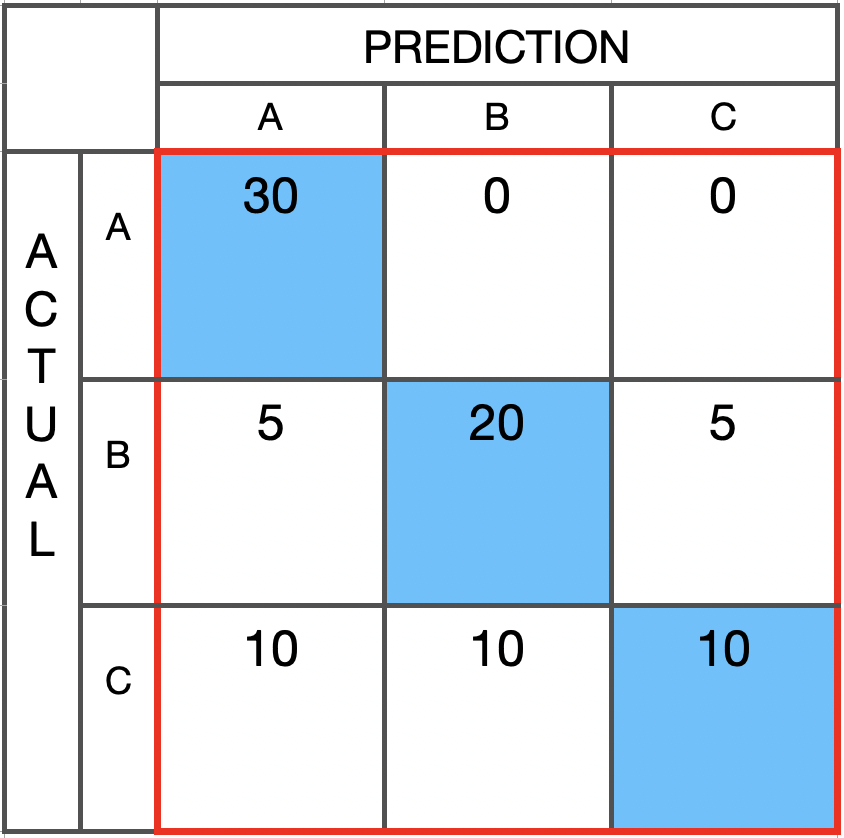
Accuracy : 각 클래스의 TP의 합 / 전체
= 60 / 90
= 0.6666
### 이제 Accuracy를 구하는 방법을 알았으니 첫 질문에 대답할 수 있을 것 같습니다!
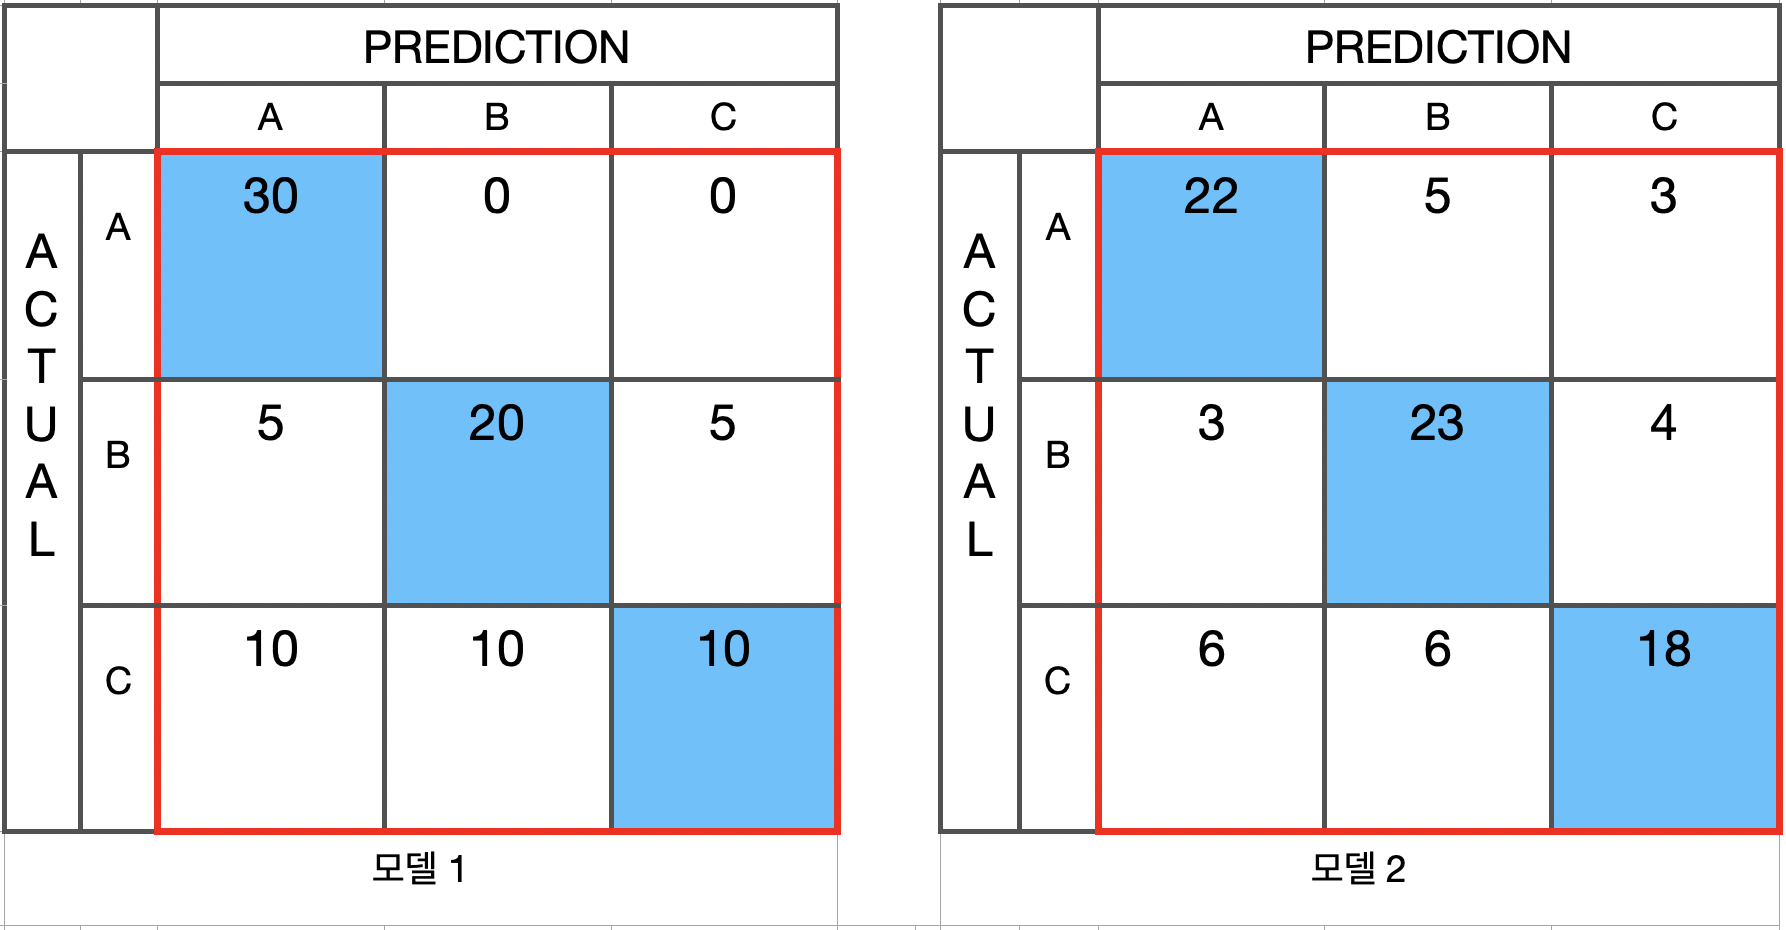
모델 1의 Accuracy = 0.6666
모델 2의 Accuracy = 0.7000
그럼 우리는 Accuracy가 높은 모델 2가 더 성능이 좋다고 판단하고 사용하면 될것같습니다!
### 그렇다면, 아래의 두 모델중엔 어떤것이 더 성능이 좋을까요??
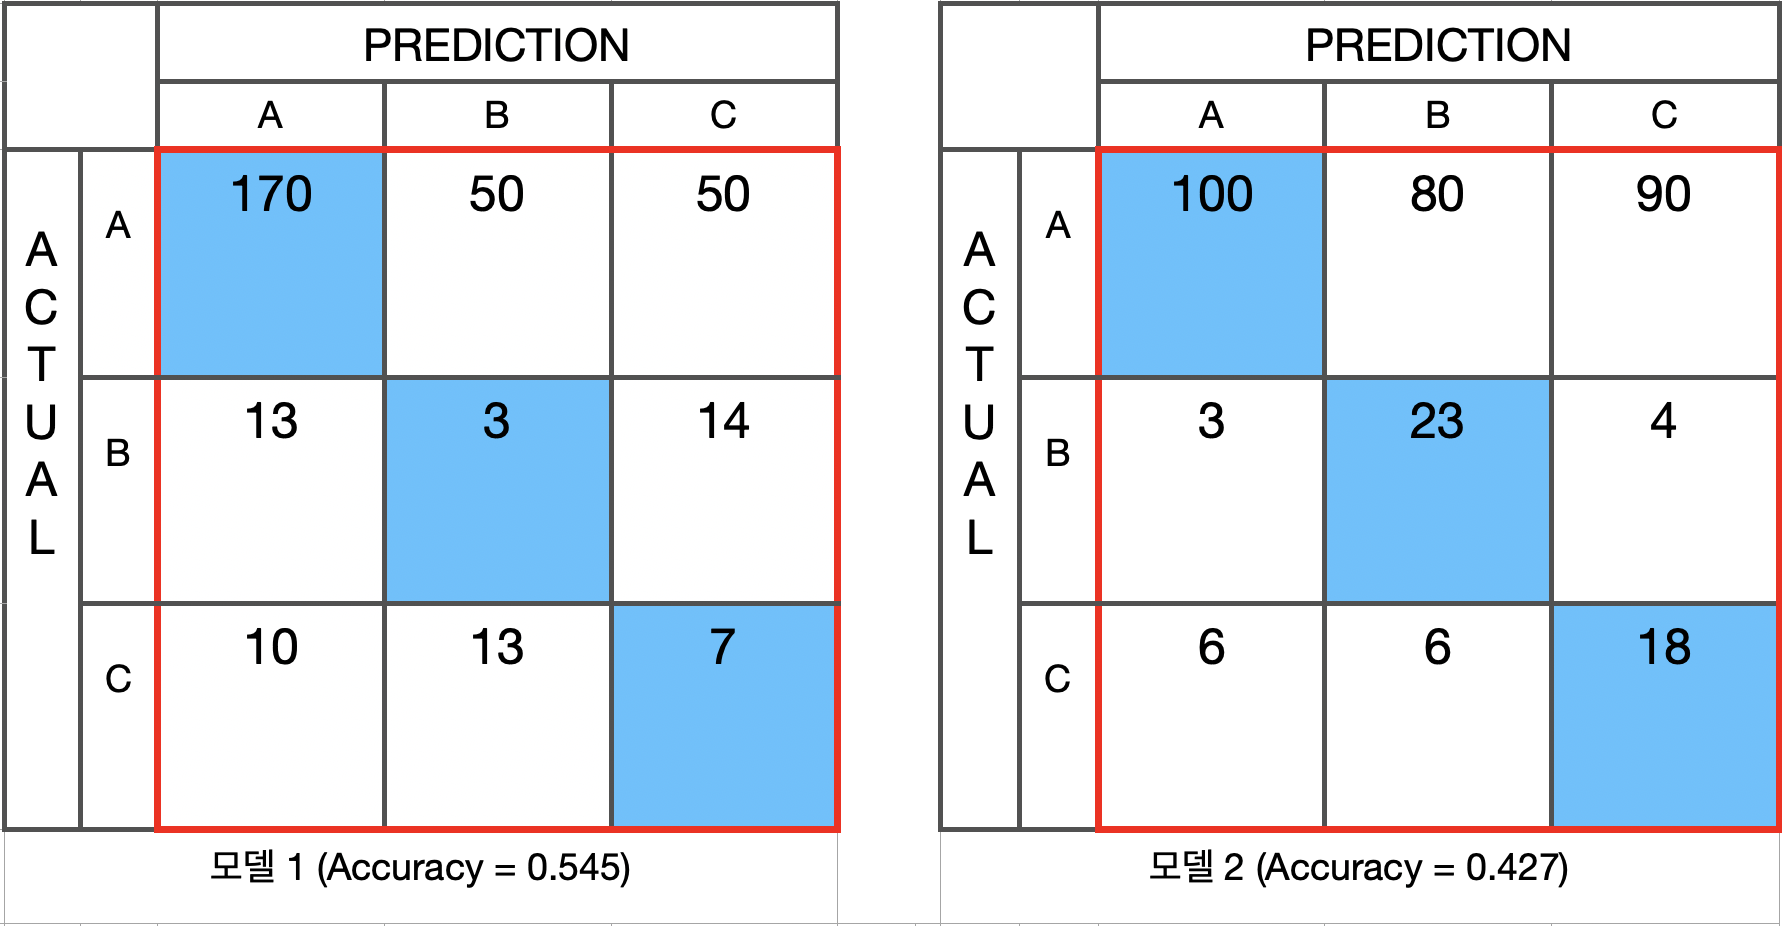
Accuracy 측면에선 모델 1이 더 높으니 모델 1이 성능이 더 좋은 모델일까요?? 여기서 주의해야 할 점은 여기 나오는 데이터는 imbalanced하다는 점입니다. 이전에 Accuracy를 다룰때 봤던 데이터는 A, B, C 각 클래스에 30, 30, 30개의 값이 있었지만, 여기선 270, 30, 30개의 값이 존재합니다! Accuracy는 balanced한 데이터에대한 모델을 평가하는데에는 적절하지만, 여기선 아닙니다 ㅎㅎ! F1-score가 이렇게 imbalanced한 데이터에 대한 모델을 평가하는데 더 좋은 지표라고 하니, 한번 알아보겠습니다!
## F1-score : Imbalanced한 데이터에 적합함
F1-score 를 구할땐 Precision과 Recall을 알아야합니다!
* Precision(정밀도) : Positive로 예측한 경우 중 올바르게 Positive를 맞춘 비율
= TP / ( TP + FP )
* Recall(재현율) : 실제 Positive인 것 중 올바르게 Positive를 맞춘 것의 비율
= TP / ( TP + FN )
* F1-score : 정밀도와 재현율의 조화평균(harmonic mean)
= 2 ( (Precision * Recall) / (Precision + Recall) )
그림으로 F1-score를 구하는 과정을 보겠습니다! 아래의 그림은 F1-score를 계산하기위한 Precision과 Recall을 어떻게 구하는지를 보여주는 것입니다. 각 클래스별로 Precision, Recall을 구하고 그것의 평균을 내면 됩니다!
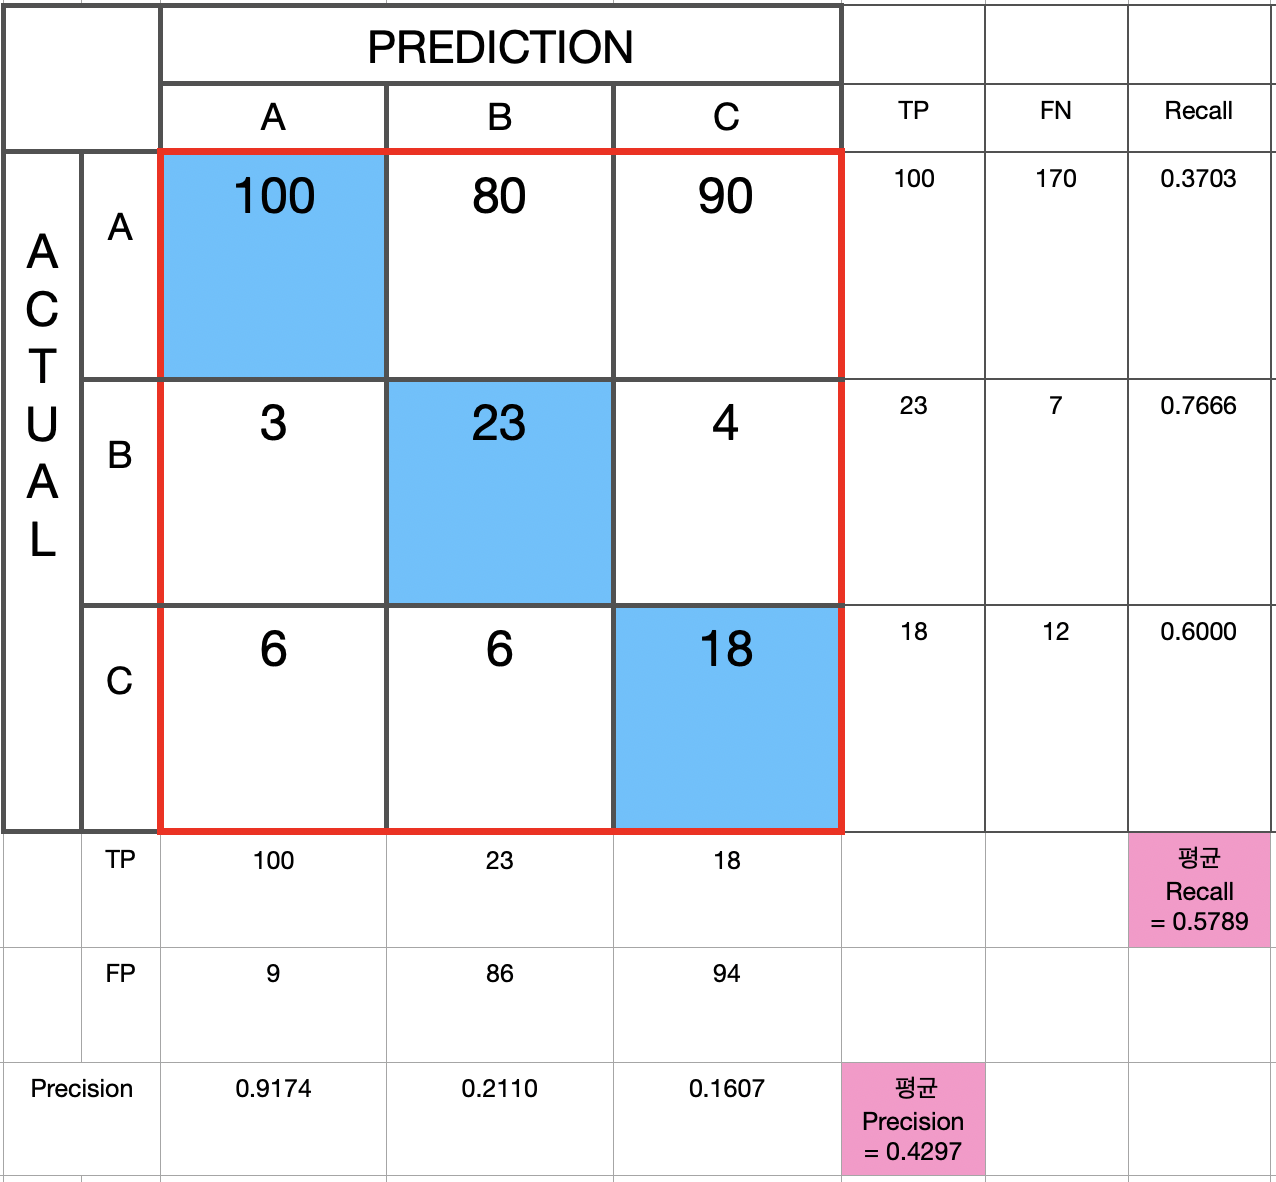
이렇게 구한 Precision과 Recall을 F1-score 식에 넣으면
F1-score = 0.4932
라는 결과를 얻을 수 있습니다!
이제, 위에서 본 두 모델중 성능이 더 좋은것을 판단할 수 있겠습니다!
### F1-score과 Accuracy를 기준으로 본 두 모델의 성능은 이렇습니다.
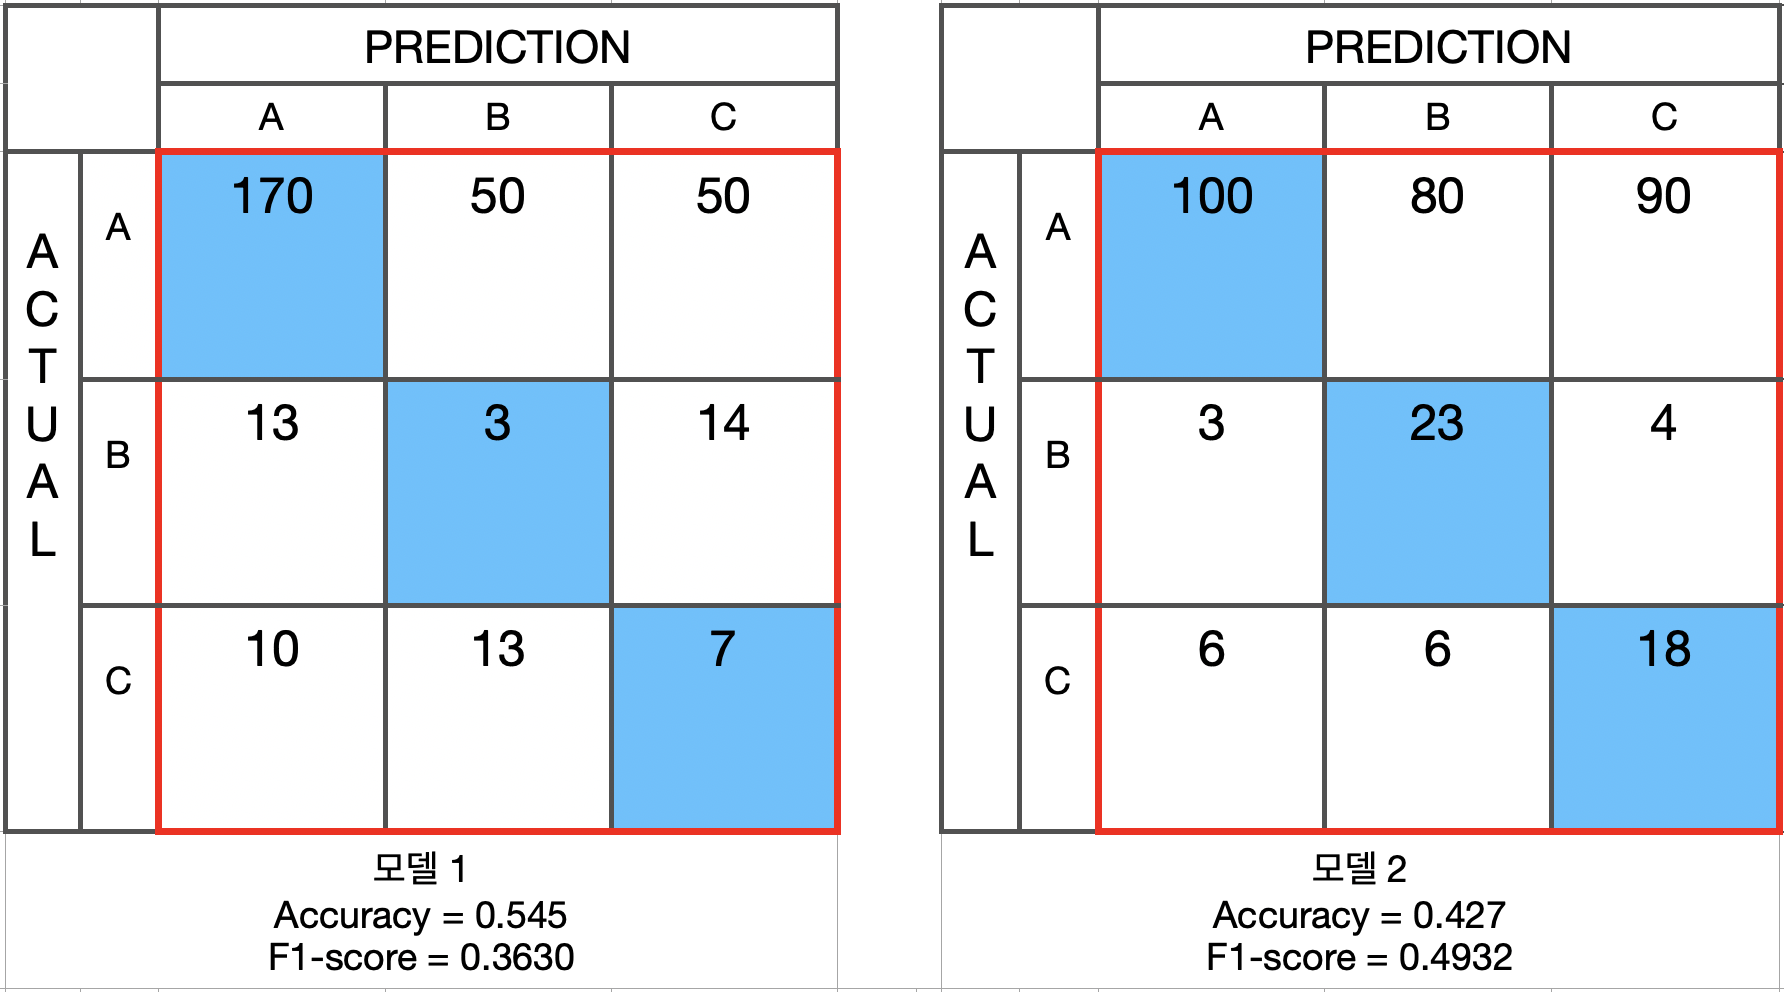
위 데이터가 imbalanced하다는 것을 감안해서, 우리는 F1-score를 기준으로 두 모델의 성능을 평가해야합니다! 그러니 모델2가 Accuracy는 낮지만 F1-score가 더 높으니 더 성능이 좋다고 말할 수 있겠습니다!
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.