codestates / codestates/ds-blog
[윤형준] Decision Tree & Hyperparameter Optimization (결정나무 그리고 하이퍼파라미터 최적화)
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
****
안녕하세요! 오늘은 머신러닝 모델중의 하나인 Decision Tree (결정나무)에 대해서 알아볼게요. Decision Tree 에서도 DecisionTreeClassifier가 있고 DecisionTreeRegressor가 존재하는데, 오늘은 분류를 다루는 DecisionTreeClassifier를 중점적으로 보겠습니다.
****
데이터를 가지고 공부해 보기전에, Decision Tree의 구성에 대해서 먼저 알아보고 가겠습니다. 아래 그림 (*figure 1*)은 Decision Tree를 단순화 한 그림입니다. 우리는 각 매듭을 node라고 칭하며, 최상단에 있는것을 root node, 중간에 있는 매듭들은 internal node, 그리고 맨 끝에 있는 매듭은 leaf node라고 합니다. 이 그림을 거꾸로 뒤집으면 마치 나무와 같이 생겼다고 하여 Decision Tree라고 부르고, node들의 이름 또한 보는 사람에게 직관으로 이해갈수 있게끔 정해졌습니다.
*Figure 1*
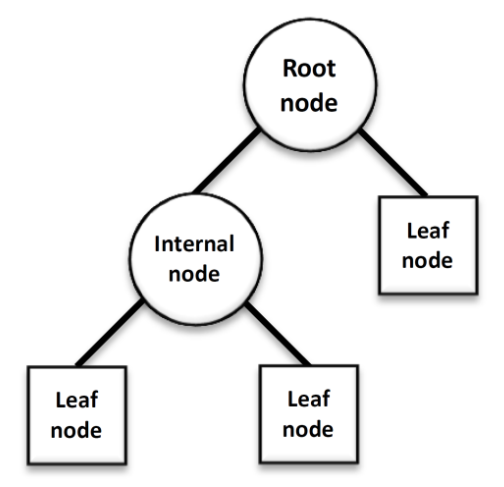
이미지 출처: https://www.researchgate.net/figure/Basic-structure-of-a-decision-tree-All-decision-trees-are-built-through-recursion_fig3_295860754
****
Decision Tree가 작동하는 법은 다음과 같습니다. 예를 들어 우리가 가지고 있는 데이터에 2가지 feature들이 존재한다고 가정해 봅시다. 두 feature들 중 하나를 선택하여 root node를 나누는 조건으로 지정합니다. 만약에 정해진 feature의 데이터가 binary data (이진 데이터)라고 가정하면, 데이터의 해당 feature가 True (또는 1) 인 데이터는 왼쪽 가지로 분류되고, False (또는 0)인 데이터는 오른쪽 가지로 분류됩니다. 그리고 root node에서 선택되지 않았던 feature를 가지고 internal node로 설정합니다. Internal node에서도 위와 같은 방법으로 True와 False로 데이터를 또 나눕니다. (각 node에 어떤 feature를 선택하는지는 나중에 설명하겠습니다.)
Decision Tree Plotting Python Code
```py
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
np.random.seed(10)
feature_1 = np.random.randint(low=0, high=2, size=30)
feature_2 = np.random.randint(low=0, high=2, size=30)
target = np.random.randint(low=0, high=2, size=30)
practice_df = pd.DataFrame({"feature_1":feature_1,
"feature_2":feature_2,
"target":target})
from sklearn.tree import DecisionTreeClassifier
from sklearn.tree import plot_tree
import matplotlib.pyplot as plt
feature_cols = ["feature_1", "feature_2"]
target_col = "target"
X_train = practice_df[feature_cols]
y_train = practice_df[target_col]
prac_clf = DecisionTreeClassifier()
prac_clf.fit(X_train, y_train)
fig, ax = plt.subplots(figsize=(12, 8))
plot_tree(prac_clf, feature_names=X_train.columns, filled=True);
ax.set_title("Decision Tree (Binary Data)", fontsize=20, fontweight="bold");
```
*figure 2*
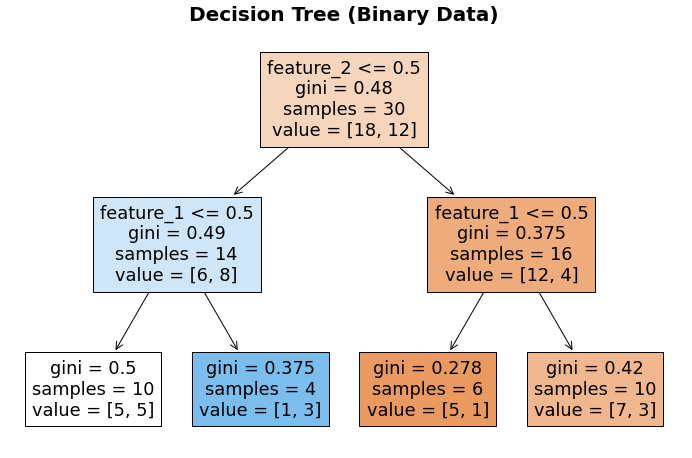
Decision Tree에 대한 기본적인 계념을 이해한 상태에서 다음 그림 (figure 2)을 같이 보겠습니다. 다음 그림은 데이터에 2개의 feature가 모두 이진 데이터로 이루어져있고 target 값도 이진 데이터로 이루어진 데이터를 기반으로 그린 Decision Tree입니다.
위의 그림 (figure 2)에서 feature 2가 root node의 분류 조건으로 선택되어있습니다. 조건은 데이터에 feature_2가 0.5보다 작거나 같다를 충족하면 True로 분류하여 왼쪽 가지로 보냅니다. 조건을 충족하지 않는다면 오른쪽으로 보냅니다. 우리는 총 30개의 데이터로 시작을하여, root node의 조건을 충족하는 데이터는 14개, 충족하지 못하는 데이터는 16개 입니다.
그럼 이번엔 왼쪽 internal node를 보겠습니다. Root node에서의 조건에 충족된 (true) 14개의 데이터에서 왼쪽 internal node조건에 충족되는 (true) 10개의 데이터는 왼쪽 leaf node로 보내집니다. 조건에 충족되지 못한 (false) 4개의 데이터는 오른쪽 leaf node로 보내집니다.
그럼 이번엔 각 leaf node들을 좀더 자세히 보겠습니다. 첫번째 leaf node는 root node부터 internal node까지 조건이 [True, True]로 분류되어있는 데이터들 입니다. 두번째 leaf node는 조건이 [True, False], 세번째는 [False, True], 네번째는 [False, False] 입니다.
DecisionTreeClassifier의 알고리즘을 이해하기 위해서는 그림에 value 값들을 이해해야 합니다. 맨 왼쪽에 있는 leaf node의 value는 [5,5]입니다. 이 뜻은 첫번째 leaf node로 분류된 데이터는 target값이 0인 데이터가 5개, target 값이 1인 데이터가 5개입니다. 두번째 leaf node로 분류된 데이터는 target 값이 0인 데이터가 1개, target 값이 1인 데이터가 3개입니다.
DecisionTreeClassifier는 각 leaf node에 있는 value값에 더 많은 비율을 차지하고 있는 class를 예상값으로 지정합니다. (참고: 만약에 value 값이 똑같이 나누어져 더 많은 비율을 가져가는 class가 없을시 예상값은 default로 0이 지정됩니다.)
[True, True] -> 0
[True, False] -> 1
[False, True] -> 0
[False, False] -> 0
그럼 위에서 설명과 같이 예상값이 나오는지 시뮬레이션을 한번 해보겠습니다.
- 두 조건이 [True, True] 이려면, 데이터의 feature_1 과 feature_2가 모두 0이여야 합니다.
- 두 조건이 [True, False] 이려면, 데이터의 feature_1 는 0, feature_2은 1이여야 합니다.
- 두 조건이 [False, True] 이려면, 데이터의 feature_1 는 1, feature_2는 0이여야 합니다.
- 두 조건이 [False, False] 이려면, 데이터의 feature_1 과 feature_2가 모두 1이여야 합니다.
```py
true_true = np.array([0,0]).reshape(1,-1)
true_false = np.array([0,1]).reshape(1,-1)
false_true = np.array([1,0]).reshape(1,-1)
false_false = np.array([1,1]).reshape(1,-1)
print("[true, true]:", prac_clf.predict(true_true))
print("[true, false]:", prac_clf.predict(true_false))
print("[false, true]:", prac_clf.predict(false_true))
print("[false, false]:", prac_clf.predict(false_false))
```
위의 코드를 실행해보고 우리가 예상했던 값이 나오는지 한번 확인해 보세요!
****
Figure 2 그림에 root node를 보면 feature_2를 0.5라는 임계값을 기준으로 데이터를 나누고 있습니다. 직관적으로는 feature_2의 데이터가 이진 데이터로 이루어져, 0과 1을 나누는 기준을 0.5로 나누는 것이 당연하게 여겨집니다. 이 기준점은 임계값, 즉 threshold는 gini impurity라고 하는 값을 통해서 이루어집니다.
(Gini Impurity는 무엇인가? 참고자료: https://victorzhou.com/blog/gini-impurity/)
Gini Impurity의 공식은 다음과 같습니다.
**Gini = Σ P(i) * (1-P(i))**
feature 값이 [0,1]로 이루어진 데이터에서 threshold를 정하는 방법은 다음과 같습니다.
0 과 1의 평균을 구한다음 그 평균을 기준으로 데이터를 나누었을때 나눠진 데이터들의 타겟값들이 얼마나 잘 나누어졌는지를 보여주는 수치가 gini impurity 입니다.
feature 값이 [0,1]로 이루어진 데이터는 threshold가 0.5로만 나눠질수 있습니다. 하지만 feature 값이 [0,1,2]로 주어진 경우에는 두가지 threshold 옵션 두가지가 생깁니다: 0.5 & 1.5.
mean(0,1) = 0.5
mean(1,2) = 1.5
0.5를 기준으로 나누었을때의 gini impurity와 1.5를 기준으로 나누었을때의 gini impurity를 비교해서 더 낮을 값을 주는 threshold로 우리는 선택을 합니다.
참고자료: https://youtu.be/7VeUPuFGJHk?t=839
예시:
gini impurity = left_weight * left_gini + right_weight*right_gini
위 공식을 통해 임계값 옵션 0.5 와 1.5의 gini를 각각 구하고 비교해서 더 낮은 것으로 root node에 있는 조건의 threshold를 정합니다.
**<각 Node에 feature 선택과정 >**
우리가 가지고 있는 모든 feature들의 threshold를 위의 과정을 통해 정합니다. 각 feature 마다 threshold가 정해진 상태에서 feature별 gini impurity를 구해서 비교를 하고, gini impurity가 가장 낮게 나온 feature를 root node로 정합니다. Root node를 정한후에는 internal node에 할당될 feature를 정해야 할텐데, 여기서는 root node에 정해진 feature를 뺀 나머지 feature들을 가지고 같은 방법으로 internal node를 설정합니다.
Gini Impurity를 통해 Root node 선택 과정 예시
figure 2 의 예시로 설명:
feature_2= 0 일때 타겟 값 (0,1) 의 분포: value = [6, 8]
feautre_2=1 일때 타겟 값 (0,1) 의 분포: value = [12,4]
Gini_feature_2 = weight_0 * (6/14)*(1-(6/14)) + weight_1 * (12/16)*(1-(12/16))
같은 방식으로 feature_1의 gini를 구해서 비교하고 더 낮은 것으로 root node를 선택합니다.
참고자료:https://youtu.be/7VeUPuFGJHk?t=217
**<데이터를 활용하여 DecisionTree 구현>**
데이터를 가져와서 데이터를 보면서 설명을 해보도록할게요. 데이터는 아래 사이트에서 다운받아보세요.
https://www.kaggle.com/uciml/pima-indians-diabetes-database
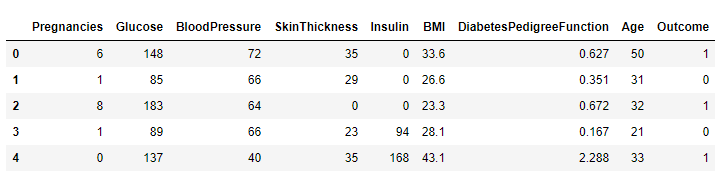
해당 데이터는 8개의 특성들이 존재하고, 마지막 열에 우리가 알고자 하는 타켓값이 있습니다. 타겟값은 0 과 1로 이루어진 binary 데이터 입니다. 데이터를 제공한 캐글 사이트의 설명에 따르면, 이 데이터는 사람들의 나이, 혈압, BMI 지수등을 포함하고 있고 마지막 행에는 해당 사람이 당뇨병이 있는지 없는 지를 나타내고 있습니다. 따라서 타겟값이 1이라면 해당 사람이 당뇨병을 가지고있는 것입니다. 우리가 여기서 DecisionTreeClassifier라는 알고리즘을 사용하여 가지고 있는 데이터를 학습시키고, 그 후에 새로운 데이터를 학습된 DecisionTreeClassifier를 사용하여 해당 사람이 당뇨를 앓고있는지 아닌지를 예측해볼수 있습니다.
아래 시뮬레이션 코드 5가지가 있습니다. 순차적으로 실행해 보세요.
Simulation Code 1
```py
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
path = 'C:\\Users\\shawnyoon\\Downloads\\diabetes.csv'
df = pd.read_csv(path)
columns_dict = {"Pregnancies":"preg", "Glucose":"gluc",
"BloodPressure":"bp", "SkinThickness":"st",
"Insulin":"is", "BMI":"bmi",
"DiabetesPedigreeFunction":"dpf",
"Age":"age", "Outcome":"outcome"}
df = df.rename(mapper = columns_dict, axis=1)
train = df.sample(frac=0.7, random_state=30)
test = df.drop(index=train.index)
train_df = train.sample(frac=0.7)
val_df = train.drop(index=train_df.index)
test_df = test
target = "outcome"
features = train_df.columns.drop(target)
X_train = train_df[features]
y_train = train_df[target]
X_val = val_df[features]
y_val = val_df[target]
X_test = test_df[features]
y_test = test_df[features]
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score
from sklearn import tree
```
우리는 sklearn 패키지에서 제공하는 DecisionTreeClassifier라는 기능을 통해 Decision Tree model을 구현 할수 있습니다.
```py
from sklearn.tree import DecisionTreeClassifier
```
Simulation Code 2
```py
clf_1 = DecisionTreeClassifier(criterion="gini", max_depth=1, random_state=0)
clf_1.fit(X_train, y_train)
X_val_pred_1 = clf_1.predict(X_val)
fig, ax = plt.subplots(figsize=(8, 6))
tree.plot_tree(clf_1, fontsize=15, feature_names=X_train.columns, filled=True, label="all");
acc_score = round(accuracy_score(y_val, X_val_pred_1),5)
ax.set_title(f"Accuracy Score: {acc_score}", fontsize=20, fontweight="bold")
```
다음은 위의 데이터를 가지고 예시로 간단한 Decision Tree를 만들어 보았습니다. 현 모델의 정확도는 0.75로 보여집니다.
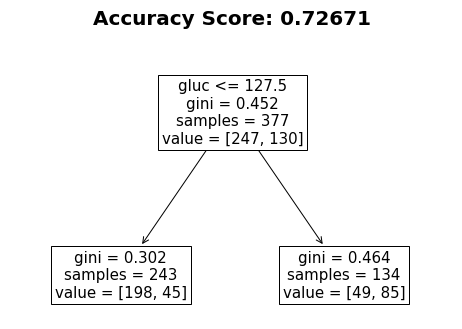
이 모델에서는 Decision Tree의 depth를 1로 설정하여 한번만 분류를 하였습니다. 여기서 분류를 몇번 하느냐에 따라서 정확도가 달라집니다.
```py
# 위 코드에서 아래와 같이 적혀진 부분이 있습니다.
# 여기서 DecisionTreeClassifier에 max_depth 라는 변수가 있는데 이렇게 우리가 설정할수 있는 변수를 hyperparameter라고 합니다.
clf_1 = DecisionTreeClassifier(criterion="gini", max_depth=1, random_state=0)
```
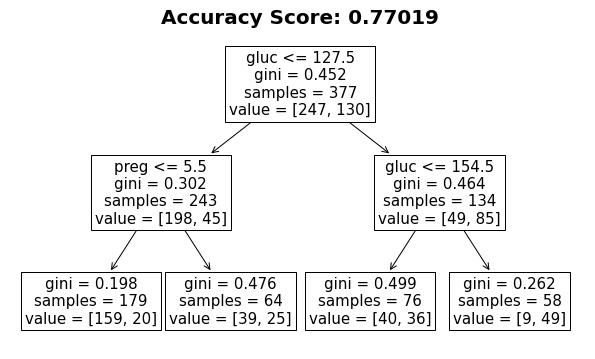
이번엔 max_depth 이라는 hyperparameter를 2로 두고 정확도를 한번 보겠습니다.
Simulation Code 3
```py
clf_2 = DecisionTreeClassifier(criterion="gini", max_depth=2, random_state=0)
clf_2.fit(X_train, y_train)
X_val_pred_2 = clf_2.predict(X_val)
fig, ax = plt.subplots(figsize=(10, 6))
tree.plot_tree(clf_2, fontsize=15, feature_names=X_train.columns,filled=True);
acc_score = round(accuracy_score(y_val, X_val_pred_2),5)
ax.set_title(f"Accuracy Score: {acc_score}", fontsize=20, fontweight="bold")
```
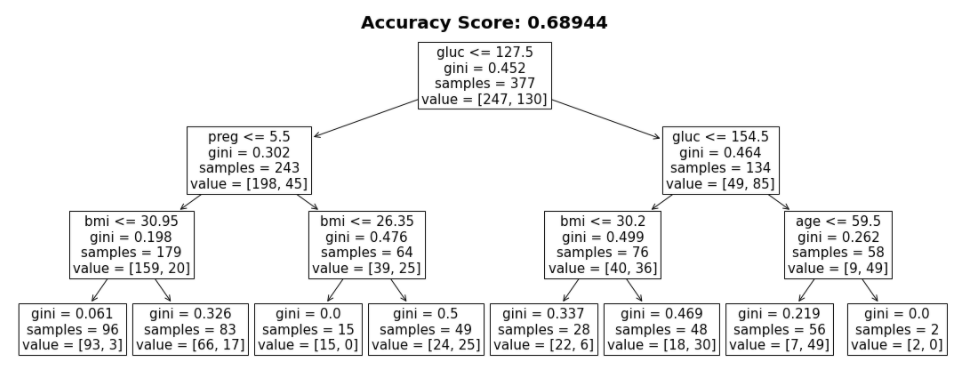
이번엔 max_depth 이라는 hyperparameter를 3로 두고 정확도를 한번 보겠습니다.
Simulation Code 4
```py
clf_3 = DecisionTreeClassifier(criterion="gini", max_depth=3, random_state=0)
clf_3.fit(X_train, y_train)
X_val_pred_3 = clf_3.predict(X_val)
fig, ax = plt.subplots(figsize=(19, 7))
tree.plot_tree(clf_3, fontsize=15, feature_names=X_train.columns, filled=True);
acc_score = round(accuracy_score(y_val, X_val_pred_3),5)
ax.set_title(f"Accuracy Score: {acc_score}", fontsize=20, fontweight="bold")
```
이번엔 max_depth 이라는 hyperparameter를 4로 두고 정확도를 한번 보겠습니다.
Simulation Code 5
```py
clf_4 = DecisionTreeClassifier(criterion="gini", max_depth=4, random_state=0)
clf_4.fit(X_train, y_train)
X_val_pred_4 = clf_4.predict(X_val)
fig, ax = plt.subplots(figsize=(21, 10))
tree.plot_tree(clf_4, fontsize=15, feature_names=X_train.columns, filled=True);
acc_score = round(accuracy_score(y_val, X_val_pred_4),5)
ax.set_title(f"Accuracy Score: {acc_score}", fontsize=20, fontweight="bold")
```
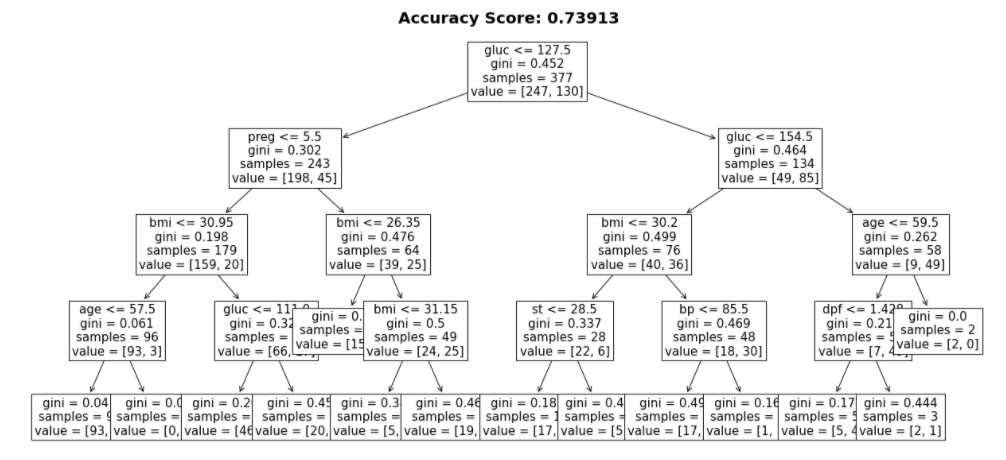
max_depth라는 hyperparameter를 1부터 4까지 변화시키면서 정확도를 보니 max_depth가 꼭 크다고 좋은것이 아닌걸 알 수있습니다. 현 데이터와 현 모델의 셋업에서는 max_depth를 2로 설정했을때 accuracy가 가장 좋게 나옵니다. 하지만 우리가 이렇게 매번 수작업으로 max_depth를 변화 시키면서 최적의 max_depth가 무엇인가 알아내기는 여간 번거로운 일이 아닙니다. 따라서 우리는 sklearn pacakge에서 제공하는 RandomizedSearchCV라는 기능을 통해 해당 hyperparameter의 최적값을 찾아낼수 있습니다.
****
그렇다면, 앞서 말한 RandomizedSearchCV를 통해 max_depth을 무슨 값으로 설정해야 좋을지 시뮬레이션을 해보겠습니다.
```py
from sklearn.model_selection import RandomizedSearchCV
param_dist = {"max_depth":[1,2,3,4,5,6,7]}
clf = DecisionTreeClassifier()
clf_cv = RandomizedSearchCV(clf, param_dist, cv=50)
clf_cv.fit(X_train, y_train)
print(clf_cv.best_params_)
print(clf_cv.best_score_)
```
위 코드를 실행해보면 max_depth를 4로 설정하는 것이 accuracy score metric상 가장 좋다고 보여집니다. 그렇다면 왜 우리가 수작업으로 찾은 결과와 다를까요? RandomizedSearchCV는 우리가 accuracy를 확인하는 작업과 조금 다릅니다. 우리는 일반적으로 train 데이터로 학습한 내용을 validation set에 적용해서 예측값을 도출하고, 그 도출한 예측값을 실제 validation target값과 비교해서 accuracy를 확인했습니다.
하지만, RandomizedSearchCV가 사용하는 기술은 train 데이터셋을 가지고 내부적으로 cross validation을 하기 때문에 우리가 확인한 값과는 조금 다를수 있습니다. 말하자면 방법의 차이입니다. 그리고 우리는 가지고 있는 데이터 내에서만 학습을 하기때문에 새로운 데이터를 예측해야할때 어떤 방법을 통해 얻은 model의 hyperparameter가 더 정확할 것이라는 확신은 할 수 없습니다. 다만 시간적인 측면에서는 수작업 보다는 RandomizedSearchCV를 통해 최적의 hyperparameter를 구하는 것이 더 효윩적인 코딩이라고 할 수 있겠습니다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.