codestates / codestates/ds-blog
[김태헌]_Decision Trees(결정 나무)
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
이번엔 Decision Trees, 한국말로는 결정나무 또는 의사결정나무 라고 하는 모델에 대해서 알아보려한다.
이름부터가 이미 모든걸 얘기해주듯, 나무처럼 가지치기를 통해서 최적의 의사걸졍을 해주는 모델이다.
물론 아무거나 대충 던져놓고 알아서 결정하라그러면 결정나무도 주인닮아 결과를 대충 던져놓는다. 신중하게 그나마 괜찮은 납득이 가는 의사결정 결과를 얻기위해서는 최대한 정제되고 데이터를 이쁘게 다듬어서 결정나무에게 준다음 최적에 값을 알려달라고 빌어야하는게 맞는듯하다..
글만으로는 이미지가 너무 나무에 치우쳐있어 Decision Trees의 예시그림을 가져왔다.

결정나무는 데이터를 분석하여 그 속에 존재하는 패턴을 예측 가능한 규칙들의 조합으로 나타냅니다.
쉽게 얘기하면 데이터를 가지고 스무고개를 하는 느낌입니다. 조금더 이해하기 쉬운 이미지를 가져와 보겠습니다.
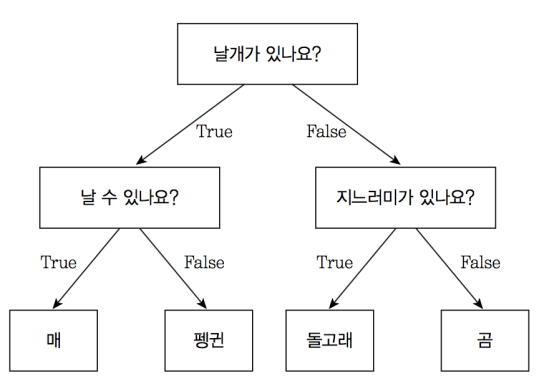
조금더 극단적인 예로 yes or no 로 되어있는 정말 스무고개와 같은 예시를 가져와보았습니다.
너무 극단적인가요? 하지만 제일 직관적인 예 이기도 합니다.
## 결정나무의 특징
### 장점
1. 결과를 설명하기가 쉽다.
2. 두개 이상의 독립변수가 종속변수에 어떤 영향을 주는지 쉽게 확인할수있다.
3. 큰 용량의 데이터도 빠르게 처리할수있다.
4. 불필요한 변수가 있어도 크게 영향을 주지 않는다
5. 수치형과 범주형 모두 적용가능하다.
### 단점
1. 연속형 변수를 비연속적 변수로 취급하기때문에 예측오류가 클 가능성이 있다.
2. train데이터에대한 의존도가 매우 크기때문에, 새로운(모르는)자료의 예측에 대해선 불안정하다.
3. train데이터를 제대로 일반화 하지 못할경우 복잡한 트리가 만들어진다.
### 가지치기(pruning)
특성이 한개에 행의 개수가 10개인 데이터를 가지고 분석하기 어려워서 결정나무에 부탁하는일은 없으리라 믿고
특성과 행의 개수가 많은 데이터를 결정나무에 주고 결과값을 도출할때, 그냥 돌리게 되면 가지가 엄청 많이 생성이 되고,
과적합이라는 결과가 나올 가능성이 높아진다. 과적합이란, 학습데이터(train데이터)를 과하게 학습해서 정확도가 100%에 가까워지는것을 뜻한다.
정확도가 100%면 좋은것 아니냐? 라는 의문을 가질수있다. 그리고 나는 당연히 아니라고 대답할수있다.
쉽게 생각해서 우리가 수능을 보기위해 공부를 하는데, 기출문제집으로 문제푸는 연습을 한다고 가정하자.
우리의 최종 목표는 수능시험 만점인데 하나의 기출문제집만 100번을 훓어서 문제집에 나온 문제들을 달달 외워서 기출문제집에있는 문제를 풀면 100점을 받는다. 그럼 실전인 수능은? 당연히 기출문제집만 달달 외웠으니 점수가 잘 나올수 없다.
조금 일반화가 되어있는 예시지만 이러한 느낌이란것만 알고 넘어가면 좋겠다.
이러할때 사용하는것이 가지치기이다.
나무의 크기가 너무 과하게 커지지않게 크기를 임의로 조절해 주는것이다.
### 불순도
불순도는 그림 하나로 쉽게 설명할수있고 이해할수 있다.
그림을 보기전, 질이 좋은 질문은 어떤것일까? 라는 질문을 던지고 보면 더 이해하기 쉽다.
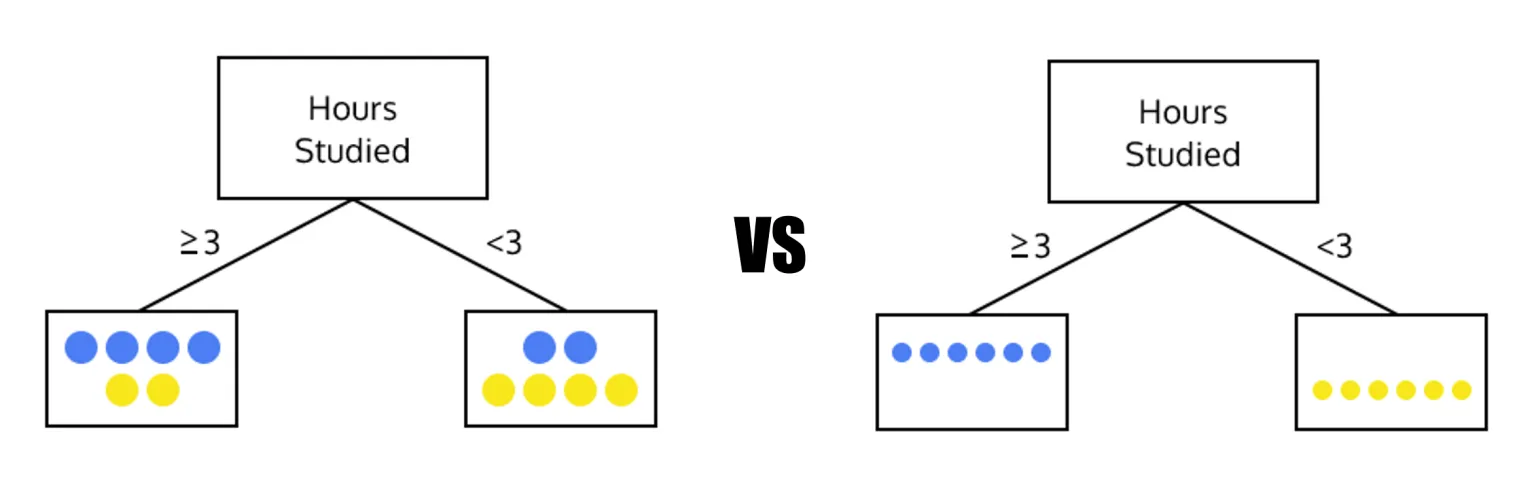
왼쪽그림을 보면 왼쪽질문은 파랑4 노랑2, 즉 질문은 6개를 했는데 그중 2개는 전혀 상관없는 막말이었다 라고 생각하면 되겠다.
반대로 오른쪽 그림의 왼쪽 질문은 파랑6. 질문을 6개를 하고 그 6개 모두가 필요한 질문이었다는 것이다.
예를들어 4개의 데이터 세트에서 레이블A가 3개, B가 1개 포함되어있다면, 불순도를 확인하는 공식은 아래와 같다.
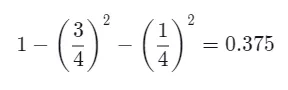
1에서 '전체 데이터 개수 중 각 레이블이 차지하는 개수의 비율' 을 제곱한뒤 빼주면 된다.
불순도의 값은 작을수록 질이 좋은 질문을 거쳐 분할된 데이터라는 의미이다.
오늘은 여기까지..
다음엔 결정나무와 이어지는 앙상블기법에대해 알아보려한다.
Contributor guide
No contributing guide indexed for this repository
Research direction
No file, test, or entry point is named. Start by clarifying whether this Korean Decision Trees draft is meant to become a blog post and what edits or publication format are required; completion cannot be determined from the issue alone.
Written by the indexing model from the issue text.
Assessment
- Domain
- content, documentation, machine-learning
- Issue type
- Documentation
- Difficulty
- 3/5
- Estimated time
- 1-2 days
- Activity status
- Stale
- Clarity
- Needs clarification
- Newbie friendliness
- 35/100