codestates / codestates/ds-blog
[김지연]선형회귀를 사용하여 한국의 지니계수 예측 연습
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
서문
---
책 '팩트풀니스'를 보면 세계의 불평등은 점점 나아지고 있으며 세상은 좀 더 살만한 곳이 되어가고 있다고 한다. 하지만 하루하루 팍팍하게 살다 보면 정말 불평등이 없어지고 있는 건가 생각이 드는 것이 소시민의 마음이다. 지니계수(가장 널리 사용 되는 사회의 불평등 정도를 나타내는 숫자)를 확인해보면 조금씩이지만 불평등 정도가 감소하는 것도 확인할 수 있다.
대학 때부터 경제적 불평등에 관심이 있던 나..그렇게 지니계수에 대한 집착은 커져갔고, 민주주의지수, 국민소득 같은 사회의 지표들이 지니계수와 상관관계가 있을까? 있다면 사회의 지표들로 지니계수를 예측해보는 것도 가능할지 그런 것들이 궁금해졌다.
부트캠프에서 선형회귀 모델을 배웠고 나는 사회의 지표들을 이용해 지니계수를 예측해보고 예측이 얼마나 정확한지 테스트를 해보기로 결심했다.
데이터 탐색
---
예측에 들어가기에 앞서 데이터들이 어떤 모양을 하고 있는지 알아보자!
데이터는 5개의 데이터세트로 이뤄져있다. [(GapMinder에서 제공한 kaggle 데이터셋)](https://www.kaggle.com/psterk/income-inequality)
- 지니계수 : 경제적 불평등을 나타낸 지수로 숫자가 높을수록 불평등 정도가 심한 것이다.
- 민주주의 지수 : '선거절차 및 다원주의’, ‘시민의 권리’, ‘정부의 기능’, ‘정치 참여’, ‘정치 문화’ 다섯 가지 범주에 대한 지수로 높을수록 좋은 지수이다.
- GDP 중 투자 비율 : 말그대로 GDP 중 투자가 차지하는 비율
- GDP 중 세금 비율 : GDP 중 세금이 차지하는 비율
- 1인당 GDP : GDP를 인구수로 나눈 것
일단 한국의 1950년부터 2016년까지의 지니 계수 데이터를 잘라 그래프로 그려보았다.
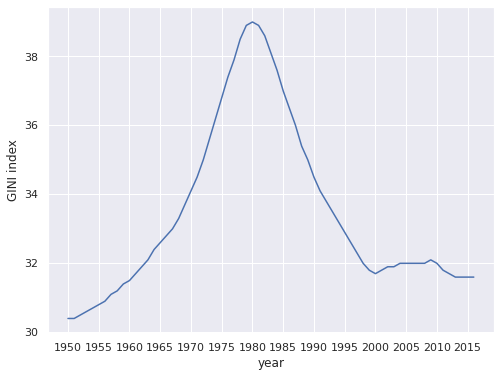
1980년 대 급격하게 증가했다가 그 이후로 낮아지고 있는 모습을 보이는데 이는 경제적으로 빠른 발전을 하며 소득분산이 제대로 되지 않은 것으로 예상된다.
그렇다면 민주주의 지수(Democracy Index)를 나타낸 그래프를 확인해보자.
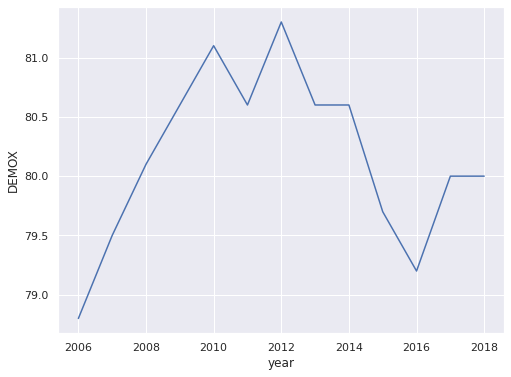
그래프를 확인하면 보수정권 하에 민주주의 지수가 높아지는 것을 확인할 수 있다.
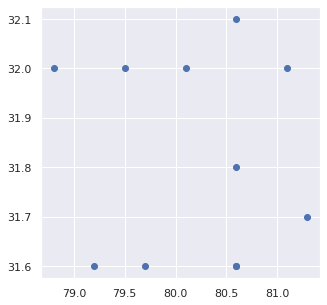
이 지수 데이터의 경우 2006년부터의 자료 밖에 없어서 지니 계수와 민주주의 지수를 scatter plot으로 그렸을 때(아래 그래프) 큰 상관관계를 발견하진 못했다.
그렇다면 1인당 GDP와 지니계수는 어떤 식으로 움직일까?
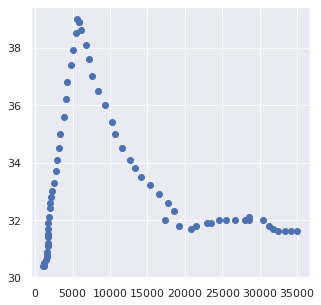
그래프의 x축은 1인당 GDP, y축은 지니계수로 국민소득이 7,000달러 정도일 때 가장 높은 지니계수를 보이고 1인당 GDP가 점점 높아질수록 지니계수는 낮아짐을 확인할 수 있다.
GDP 대비 투자와 세금 비율도 지니 계수와의 관계를 scatter plot을 그려 확인해왔는데 큰 상관관계를 찾을 수 없었다.
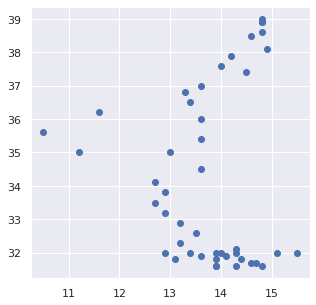
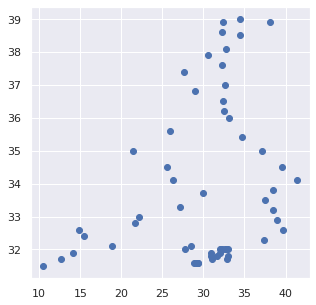
위에는 GDP 대비 세금 비율 아래는 GDP 대비 투자 비율이다.
눈으로 확인한걸 믿을 수 없어 correlation matrix를 확인해봤다.
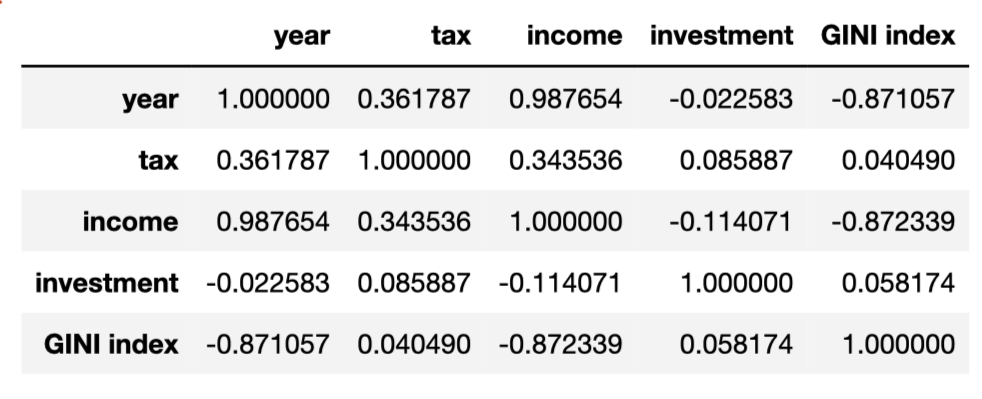
matrix에서 확인할 수 있듯 어떤 데이터도 지니 계수와 큰 상관관계를 보이진 않는듯 보인다. 지니 계수와 소득, 연도의 상관관계를 보면 -1에 가까운데 이는 시간이 지나고 소득이 증가하며 지니계수는 낮아졌기때문이다.
회귀분석
---
이번 분석에서는 다중선형회귀모델을 사용했다. 선형회귀모델을 사용한 이유는 목표가 지니계수라는 continuous값을 예측하는 것이었고 ridge regression을 사용할 만큼 특성이 많진 않았기 때문이다.
2004년 이전의 데이터를 train 세트으로 정하고 그 이후는 test 세트로 나누었다. train 세트에 적용한 모델을 test 세트에 적용하였고 검증을 위해 MSE, RMSE, MAE, R2 값을 구해보았다.
회귀모델 평가지표
---
- MSE(Mean Square Error) : 오차에 제곱을 평균하여 제곱근 한 값으로 값이 작을수록 추정의 정확도가 높은 것이지만 제곱을 하기 때문에 outlier에 민감하다.
- RMSE(Root Mean Square Error) : MSE에 루트를 씌운 값으로 비교하는 값과 단위가 비슷하므로 사용하기에 용이하다.
- MAE(Mean Absolute Error) : 모델의 예측값과 실제값의 차이의 절대값을 모두 더한 값이다. MSE에 비해 outlier에 덜 민감하다.
- R2(R-Squared) : 0부터 1의 값으로 . 1에 가까울수록 추정을 잘 한 것으로 이해하면 된다.
MSE: 8.944627569061046
RMSE: 2.990757022738732
MAE: 2.7889480305260346
R2: -245.19577510933598
평가지표 MSE, RMSE, MAE를 보면 우리나라 지니계수가 30점대인 것을 감안하면 꽤나 크게 나왔다고 할 수 있다. R2의 경우 0부터 1의 값이 나와야 하는데 -245가 나온 것을 보면 내가 사용한 모델이 이 예측과 잘 안맞는다는 것을 확인할 수 있다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.