codestates / codestates/ds-blog
[오예은] 최적의 모델을 찾아라! -bias vs. variance 관점에서
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
최적의 모델을 찾으려면... 런웨이 현장으로 ㄱ....
[드라마 <청춘기록> 중 모델 사혜준]
(조심합니다...)
.
.
.
.
.
머신러닝에서 지도학습(Supervised Learning)에 대해서 이야기를 할 때는
사람이 정해준 정답이 있고, 컴퓨터가 그 정답을 잘 맞추는 방향으로 모델을 훈련(training) 시킨다.
머신러닝에서 좋은 모델이란 데이터의 패턴을 잘 학습하여 실제와 가깝께 예측하는 모델이라고 할 수 있다. 상황에 따라, 문제에 따라 어떤 데이터는 간단한 모델로 학습할 때가 적합하고, 어떤 모델은 복잡한 모델로 학습하는 때가 더 효과가 좋다. 물론, 양질의, 많은 양의 데이터가 있다면 최적의 모델을 만들 수 있다. 하지만 현실에서는 그것이 어렵기 때문에 만든 모델을 계속해서 개선하는 작업이 필요하다.
이번 글에서는 어떤 모델이 더 좋은 모델인지를 평가하기 위한 이론 중에 하나인 **편향(Bias)-분산(Variance) Tradeoff**에 대해서 다뤄보고자 한다.
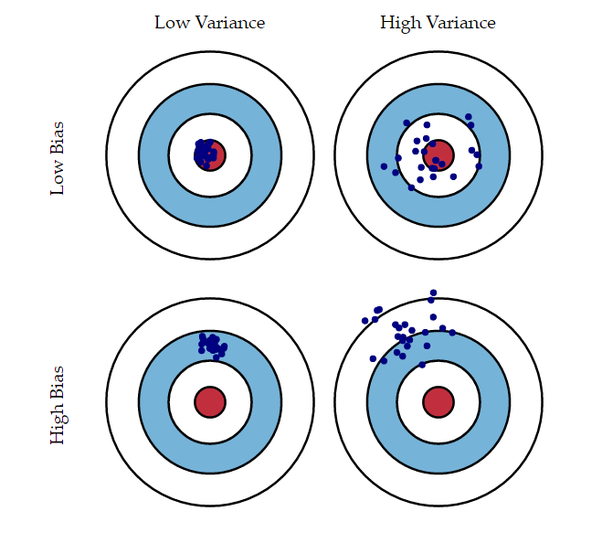
실제 값을 맞추기 위해 컴퓨터는 여러 번의 예측값 내놓는데, 컴퓨터가 내놓은 예측값의 모습을 표현한 것이 '편향' 과 '분산' 이다.
#### 편향(Bias)
평균적으로 우리의 모델(의 예측값)이 얼마나 실제값과 떨어져 있느냐에 대한 문제이다. 즉, bias가 낮을수록 실제 값에 가까우며, bias가 높을수록 실제 값과 멀어진다.
#### 분산(Variance)
모델의 예측값들이평균에서 얼마나 멀리 떨어져있느냐를 의미하는데, variance가 높을수록 데이터들이 평균과 멀리 떨어져있고, variance가 낮을수록 데이터들은 평균과 가깝게 분포한다.
재미있는 점은 이 둘이 완전한 trade-off관계를 가지고 있다는 것이다. 주어진 데이터에 대해 bias가 낮으면 variance가 높고, bias가 높으면 variance가 낮다.
이때 bias가 낮으면 과적합(overfitting) 되었다고 하는데, 이 경우에는 학습 데이터에만 너무(over) 맞춰져서(fitted) 새로운 데이터가 들어왔을 때 정확도가 떨어질 수 있다. 그리고 이때 variance는 높아지는데 모델이 모든 특징을 세밀하게 설명할 수 있을 만큼 유연성이 충분하지만, 학습(훈련) 데이터의 잡음까지 반영하고 있는 경우이기 때문에 너무 낮은 bias 혹은 높은 variance를 피해야한다.
그렇다고 bias가 높은것이 좋은 것은 아니다. 이 경우를 과소적합(underfitting)되었다고 한다. 모델이 모든 특징을 적절하게 설명할 수 있을 만큼 유연하지 않은 경우로 데이터의 특성을 충분히 예측할 수 없다.
### Bias vs. VarianceBias와 Variance 조정하기
이 부분에 관해서는 [Article](http://scott.fortmann-roe.com/docs/BiasVariance.htm)을 번역한 글로 대신한다. 필자가 익숙하지 않은 개념이 있어 문장이 어색할 수 있으니 원문을 읽어보는 것을 추천한다.
#### 당신의 본능과 싸우라
많은 사람이 '분산'의 비용이 있음에도 편향을 최소화해야한다는 고집을 가지고 있다. 그들은 편향이 있다는 것이그들의 모델과 알고리즘이 기본적으로 잘못됐다는 것을 알려준다고 생각한다. 그렇다. 그들은 인정한다. 분산도 좋은 것은 아니지만 높은 분산을 가진 모델은 적어도 평균을 잘 예측할 수 있고, 적어도 "근본적으로" 잘못된 것은 아니란 말이다.
이것은 잘못된 논리다. 'high variance and low bias' 모델이 멀리봤을 때 평균같은 종류에서 성능이 좋다는 것은 사실이다. 그러나, 실제 모델러들은 데이터셋의 하나의 현실화를 다룬다. 이런 경우에는 장기적 평균과 관계없이 당신이 실제로 가지고 있는 데이터의 모델의 성능이 가장 중요하며, 이 경우 편향과 평균은 동등하게 중요해서 다른 하나를 희생해가며 어떤 한가지를 개선시켜선 안된다.
#### Bagging and Resampling
Bagging and resampling 기법은 모델 예측에서 분산을 줄이는 데 이용할 수 있다. bagging (Bootstrap Aggregating)에서는, 무작위 선택과 교체를 이용하여 원본 데이터셋의 많은 복제가 만들어진다. 각각의 파생 데이터셋은 새로운 모델을 만들기 위해 쓰이고, 모델은 앙상블로 조합된다. 예측을 하기 위해, 앙상블의 모든 모델들을 조사하여 그들의 결과를 평균화한다.
강력한 모델알고리즘의 하나인 랜덤포레스트는 Bagging의 좋은 예시이다. 랜덤 포레스트는 원본 데이터를 다르게 재샘플링한 데이터를 기초로 한 수많은 의사결정나무를 학습하는 방식으로 동작한다. 랜덤포레스트에서 전체 모델의 편향은 단일 의사결정 나무의 편향과 동일하다.(하나의 의사결정나무가 높은 분산을 가지고 있을지라도!)
이런 나무들을 여러개 만들면서 "forest"효과가 발생하면 그들을 평균화 하여 최종 모델의 분산을 하나의 나무보다 크게 감소시킬 수 있다. 실행시에 forest의 크기의 유일한 한계점은, 무한정의 나무 수가bias의 증가 없이 variance를 감소시키면서 훈련하는데 걸리는 계산 시간이다.
#### 알고리즘의 점근적 속성
통계 분야의 학문적인 글들에서는 예측 알고리즘에 대해 "asymptotic consistency"와 "asymptotic effiecncy"에 대한 논의를 자주 한다. 이것이 암시하는 것은 당신의 학습 데이터의크기가 무한정으로 늘어나면 모델의 bias는 0이 될 것이고(asymptotic consistency), 그 모델은 당신이 쓸 수 있는 어떤 다른 모델보다 나쁘지 않은 variance를 가지게 된다는 것(asymptotic efficiency)이다.
두 개념 다 우리가 모델에 적용하고 싶은 속성이다. 그러나 우리가 무한 샘플 크기가 있는 세상에 살고 있지 않으니 현실에서의 실용성은 매우 적다. 백만번에서 bias가 거의 없는 알고리즘이더라도 몇 백번의 데이터 지점에선 큰 bias가 생길 수 있다. 더 중요한 것은, asymptotically consistent and efficient 알고리즘이 실제로 작은 표본 사이즈에선 두 속성이 없는 알고리즘보다 나쁜 성능을 보일 수 있다는 것이다. 그러므로 현실의 데이터를 가지고 일을 할 때 가장 좋은 방법은 이론적인 개념일랑 내버려두고 주어진 시나리오에서 정확도에 집중하는 것이다.
#### Understanding Over- and Under-Fitting
처음으로 돌아가보면, bias와 variance의 문제는 결국 과적합(overfitting)과 과소적합(underfitting)을 다루는 문제이다. Bias는 줄어들고 variance가 늘어나는 것은 모델의 복잡성과 관련이 있다. 모델에 파라미터가 계속 추가될 수록 모델의 복잡성은 증가하고 bias는 급격히 떨어지겠지만 variance가 우리의 주된 걱정거리가 된다. 예를들어, 선형회귀에서 다항식의 항이 추가되면 모델의 복잡도는 높아진다. 즉, 모델이 복잡해지면 bias가 일단 낮아지고 후에 variance가 상승 곡선을 그린다. (그래프 참조)
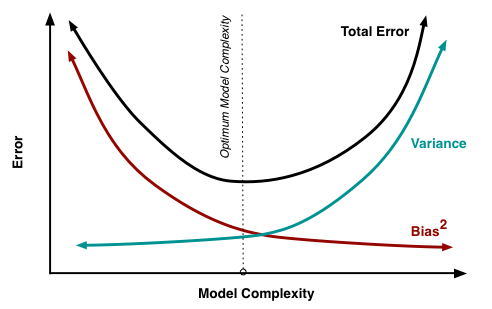
만약 모델 복잡성이 그래프상의 최적점을 넘는다면 over-fitting 효과가 있다. 반면에 최적점에서 떨어진다면 under-fitting된 모델이다. 실제적으로 이 위치를 찾는 분석방법은 없다. 대신에 우리는 예측 오차의 정확성을 이용하고, 모델 복잡도의 레벨을 조절해가면서 전체적인 오차범위를 줄이는 복잡도를 선택할 수 있다. 이 과정의 포인트는 자칫 우리를 속일 수 있는 부정확한 측정치를 피해정확한 오차 측정법을 선택하는 것이다. 이것은 교차검증법과 같은 방법을 이용할 수 있다.
### 결론
머신러닝을 이용해 모델을 만들고 어떤 값을 예측하는 과정에서 최적의 모델을 찾기 위해서는 새로운 데이터가 들어왔을 때 그 값을 얼마나 예측할 수 있는지가 중요하다. 현재 가지고 있는 데이터에만 국한(overfitted)된 데이터보다 다른 상황이 주어졌을 때 그것을 잘 반영할 수 있는 유연하고 일반화된 모델을 만드는 것이 모델을 개선할 때 계속해서 이용할 수 있는 최적 모델을 만들 수 있지 않을까 생각한다.
#### 참고사이트
http://sanghyukchun.github.io/59/
http://scott.fortmann-roe.com/docs/BiasVariance.htm
https://isme2n.github.io/devlog/2017/10/27/machine-learning-3/
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.