codestates / codestates/ds-blog
[송지]valueerror: could not convert string to float - 원핫인코딩부터 특성 선택까지 -
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
이번주에 여러가지 회귀모델을 이용해 데이터셋을 학습 시켰다.
알고보니 정말 간단하지만 나를 함정에 빠뜨린 코드 에러를 다시 복기해보고자 한다.
제목의 *valueerror: could not convert string to float*를 수없이 구글링 했으나 입맛에 맞는 답변을 찾지 못했다.
(해결하고 보니 찾을 수 없는게 당연한 것 같기도..)
### 결론부터 말하자면,
>1. 원핫인코딩
>2. 데이터를 train/test 셋으로 무작위로 나누기(train/test = 80%/20%)
>3. 특성 선택(SelectKBest 이용)
>4. 선택한 특성을 사용하여 회귀모델 만들기
이 순서대로 작업하던 중 특성선택에서 위 에러가 떴고, 앞서 원핫인코딩을 한 데이터를 가져다 특성을 선택했어야 했는데, 맨 처음 원본데이터의 특성을 그대로 가져다 썼기 때문에 자꾸만 에러가 떴다.
무슨 말인지 모르시겠다구요?
저도 그랬습니다. 여러번 설명을 들어도 당최 아무런 실수를 찾을 수 없었단 말입니다.
나처럼 원핫인코딩에 트라우마가 생겨서ㅋㅋ 이해는 커녕 코드 복사+붙여넣기로 넘어간 사람들을 위해(응 과거의 나) 원핫인코딩이 뭔지 요약X, 구구절절 말해본다.
---
### One-hot encoding
회귀모델은 숫자만 이해한다. 범주형 데이터를 넣으면 모델을 돌릴 수 없다.
그렇다면 데이터셋의 수많은 요소 중 target 에 영향을 미치는 feature가 오직 숫자형으로만 이루어져 있을까?
절대 아니다. 예측에 필수적일 것 같은 feature가 범주형 데이터일때, **One-hot encoding**을 사용하면 된다.
원핫인코딩은 범주형 데이터를 숫자형 데이터로 바꿔주는 인코더 중 하나다.
대체 문자를 어떻게 숫자로 바꾼다는걸까?
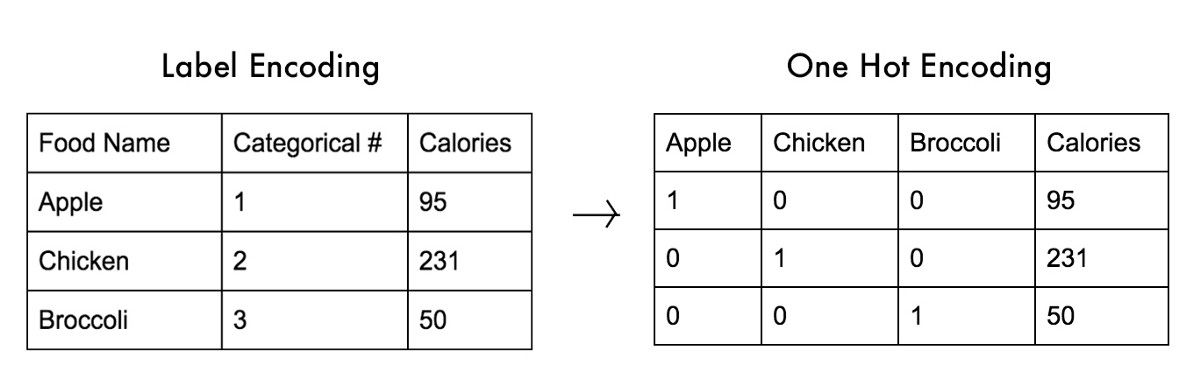
'Food Name'이라는 feature에는 Apple, Chicken, Broccoli라는 세가지 범주가 있다.
잠깐 여기서 범주형 데이터(categorical data)에 대해 언급하고 넘어가자.
범주형데이터는 순서가 없는 명목형(nominal), 순서가 있는 순서형(ordinal) 이 두가지로 나뉜다.
회귀모델은 숫자의 크고 적음을 인지한다. 즉 1 ,2 3 같은 숫자를 매기면 이를 '순서'로 인지한다.
그러나 위의 'Food Name'의 범주들은 순서가 필요하지 않다.
이 세 범주에 1, 2, 3 이라는 숫자를 부여하면 컴퓨터는 Apple에 우선순위를 두게 되고 예측 모델은 엉망이 될 것이다.
우측에 원핫인코딩을 돌린 결과를 보자. 세 범주가 각각 하나의 특성이 되었고 숫자 0과 1로 구분된다.
그리고 원래 숫자형 데이터였던 'Calories' 특성은 그대로 출력됐다.
원핫인코딩은 *알아서* 범주형 데이터만 숫자형으로 바꿔주고 나머지는 그대로 둔다.
---
```python
target = 'Price'
X_train = train.drop(columns=target)
y_train = train[target]
X_test = test.drop(columns=target)
y_test = test[target]
```
- **valueerror: could not convert string to float** 경우
```python
# 원핫인코딩
import OneHotEncoder
from category_encoders import OneHotEncoder
encoder = OneHotEncoder(use_cat_names = True)
X_train = encoder.fit_transform(X_train)
X_test = encoder.transform(X_test)
# train/test 데이터셋 나누기(80%/20%)
train = df.sample(frac=0.8, random_state=1)
test = df.drop(train.index)
# 특성 선택
from sklearn.feature_selection import f_regression, SelectKBest
selector = SelectKBest(score_func=f_regression, k=20)
X_train_selected = selector.fit_transform(X_train, y_train)
X_test_selected = selector.transform(X_test)
```
원핫인코딩까지는 문제 없다.
그런데 데이터셋을 나눌때 갑자기 원본 데이터프레임을 가져와서 거기서 train과 test를 나눈다.
원핫인코딩까지 처리한 데이터프레임에서 train과 test로 나눠야 하는데 말이다!
이렇게 말로만 보면 더 혼란스러우니 아래 코드를 확인해보자.
- 올바로 특성선택이 된 경우
```python
# 원핫인코딩
import OneHotEncoder
from category_encoders import OneHotEncoder
X = df[features]
encoder = OneHotEncoder(use_cat_names=True)
X_encoded = encoder.fit_transform(X)
# train/test 데이터셋 나누기(80%/20%)
train = X_encoded.sample(frac=0.8, random_state=2)
test = X_encoded.drop(train.index)
# 특성선택
from sklearn.feature_selection import f_regression, SelectKBest
selector = SelectKBest(score_func=f_regression, k=20)
X_train_selected = selector.fit_transform(X_train, y_train)
X_test_selected = selector.transform(X_test)
```
원본 데이터프레임의 특성들만 'X'라고 지정해주었다. (새로운 데이터프레임을 생성했다)
이 'X'에 원핫인코딩을 적용한 결과(한번에 훈련과 적용을 실행했다)를 'X_encoded'라고 지정했다.
결국 원본 데이터프레임의 특성들만 뽑아낸 것에 원핫인코딩을 해준 '새로운' 데이터 프레임을 또 만든것이다.
이 'X_encoded'에서 train과 test 데이터를 나누어 주고 다음 특성선택으로 넘어가니 문제없이 잘 실행되었다.
예기치 못한 오류가 난 이유 중 이렇게 이름을 잘못 지정해준 경우가 많았다.
나의 방법이 엄청 효율적인것 같진 않지만, 적어도 헷갈림은 덜하다.
만약 원핫인코딩 전에 데이터셋을 나누었다면 첫번째 코드처럼 실행해도 잘 됐을 것이다.
그냥 코드 복붙만 하다보니 이런 실수가 나고 해답을 찾지 못해 너무 시간을 끌었다.
처음부터 차근차근 하나씩 실행해봤으면 괜찮을텐데.. 결국 천천히 가는길이 지름길이었다.
***valueerror: could not convert string to float***
이 오류가 난 경우 높은 확률로 나같은 실수를 했을 것이다.
인코딩 된 데이터셋을 특성선택에 사용해야 한다는 점을 잊지 말자.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.