codestates / codestates/ds-blog
[윤현태] 데이터 사이언티스트는 생물학자가 될 수 있을까? (feat. covid-19)
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
## 목차
#### 들어가며
#### 사전조사
#### 활용한 데이터
#### 알아내고자 하는 것
#### 데이터 전처리
#### 1. 그룹 계통과 확진자간의 관계
#### 2. 그룹 계통과 치사율간의 관계
#### 결론
## 들어가며
Covid-19 바이러스가 처음 터져 나왔을 때, 내가 처음 접했던 것은 Youtube와 뉴스였다. 굉장히 많은 이야기들이 있었는데, 그 중에서도 한 의사 분이 나와서 논물을 우리에게 풀어서 설명해 주시는 채널이 있었는데, 그것을 읽으면서 Covid-19 바이러스에 대해서 어느정도 알 수 있었다. 하지만 내가 생물학자 전공도 아니고, 거기서 나온 모든 것들을 이해할 수 없었지만, 지금 나에게는 '통계'라는 무기가 있다.
그리고 그 때 당시 아직 3개월 밖에 지나지 않은 시점이었지만, 어떤 뉴스 기사에서 GISAID site에 대해서 소개를 했고, 나는 가끔씩 그 Site에 들어가보며 돌연변이가 얼마나 생겨났는지 알아보았다.
(ref: https://www.youtube.com/watch?v=jJwYMrUUeXA)
그런데 시간이 지나면 지날 수록 돌연변이의 숫자들은 점점 늘어나, **약 1만 7천여개가 넘는 돌연변이**들이 (2020.10.04 기준) 생성되었다고 하는데, 과연 생물학자들만 이런 데이터들을 통해서 원하는 것을 얻어낼 수 있을까? 통계만으로 어떤 insight를 얻어낼 수 있지 않을까? 라는 생각이 들었다. 진짜 그런지, 어디 한번 시작해 보자.
## 사전조사
https://www.youtube.com/watch?v=BtN-goy9VOY&t=92s
아무리 데이터만 사용한다고 해도, 바이러스가 뭔지 조차 알지 못하면 의미가 없다. 위 youtube영상은 covid-19 바이러스를 제일 잘 설명한 것 같은데, 영상을 요약하면 다음과 같다.
1. Covid-19 바이러스는 RNA 바이러스이다.
2. 바이러스는 몸에 있는 세포를 사용해서 증식을 한다.
3.RNA가 갖고 있는 수산기(-OH)는 화학 반응에 적극적이라는 특성이 있다.
4.다양한 결과를 낳는다는 불안정하다는 특성을 대변한다.
5. RNA와 비교하여 DNA는 다른 원소와 잘 반응하지 않는다. 즉 안정적이다.
6.1~5번과 같은 이유로, RNA바이러스의 돌연변이가 생성될 확률이 높아진다.
아하! 일단 RNA 바이러스가 돌연변이가 많은 것을 알았다. 그럼 이걸 어떻게 나눠?
### Clade(계통)
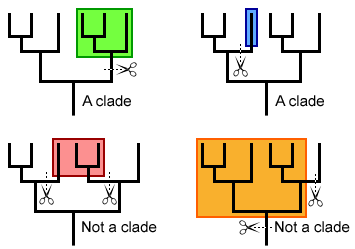
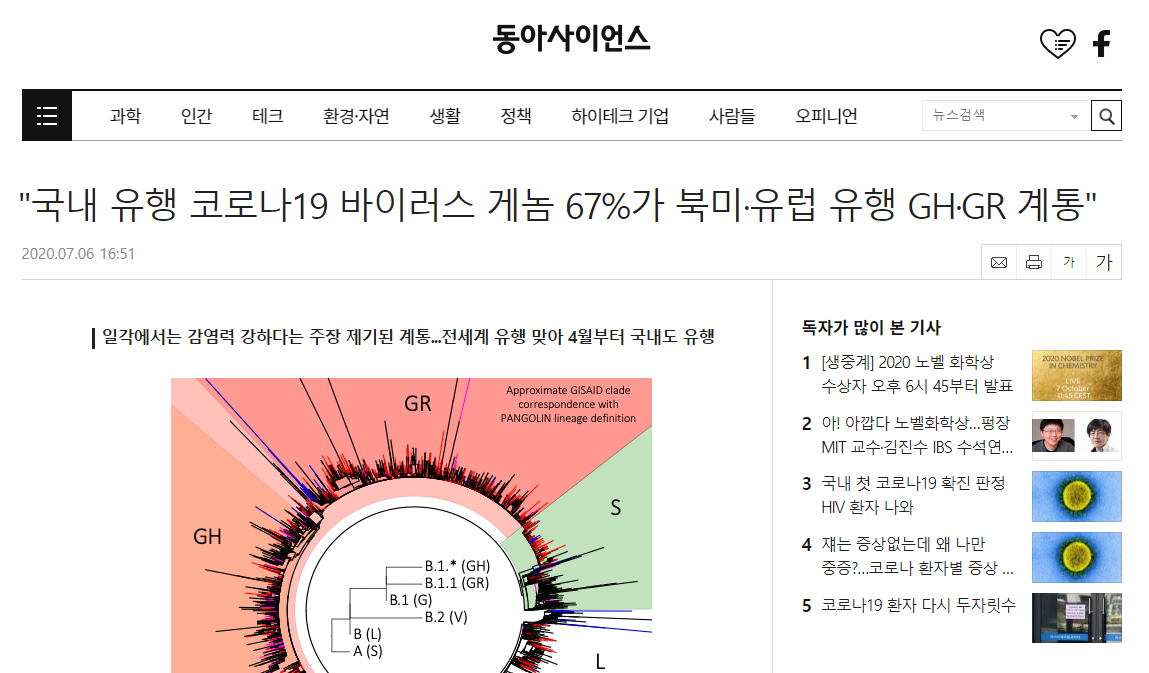
모든 생물은 DNA,혹은 RNA로 이루어져 있다. 이 때 Clade, 우리나라 말로 하면 계통인데, Clade는 코로나 바이러스의 유전자를 구성하는 염기 2만 9903개중 **그 바이러스의 특성이 잘 나타난 부분**을 라벨링하고, 기존에 존재하는 바이러스들과 비교해서 대부분의 특징이 비슷하다면 같은 clade, 완전히 다른 특징이 있으면 다른 clade로 분화시킨다. 내가 사용한 clade는 GISAID에서 임의로 지정한 GISAID clade를 사용했는데, 이것말고도 19A,19B,20A,21A같은 clade들로 나타내기도 하지만, 전문가가 아닌 이상 이게 뭘 의미하는지 모르니까 GISAID clade를 사용해 보도록 하겠다.
# 활용한 데이터
## 1. GISAID
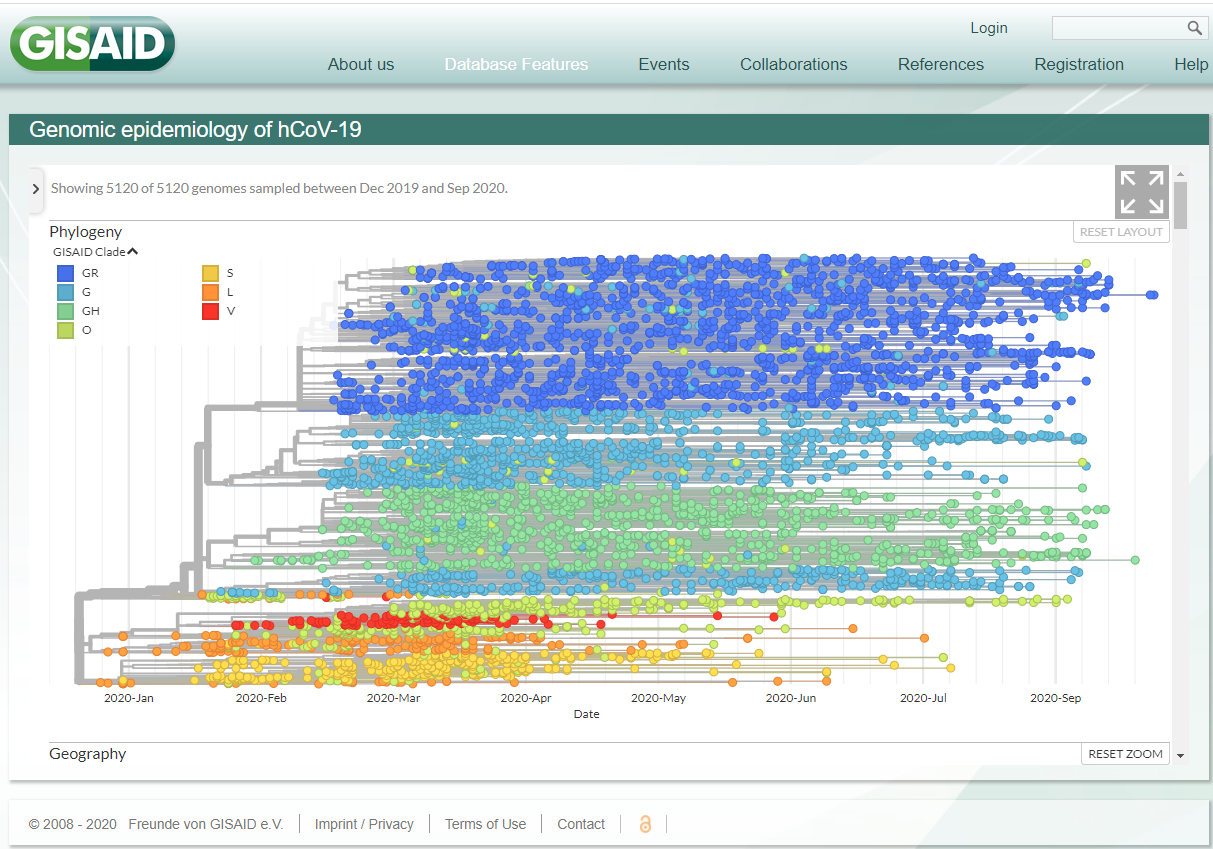
우선 GISAID는 아무래도 돌연변이 발생과 계통군을 표시하는데에 더 큰 중점을 두다 보니, 데이터가 몇천개 단위 밖에 없는데도 그래프가 너무 복잡해진다. 이런 것들을 방지하기 위해 GISAID는 발견된 돌연변이를 대륙별로 나누고, 특정 대륙 외에 있는 것들은 국가로 표시하지 않고 단순히 타 대륙으로만 표시해서 Tree plot이나 graph plot이 보여주는 복잡성을 줄이려고 노력했다. 그렇기 때문에, 자세한 clade들에 대한 자료를 얻고 싶다면 모든 대륙들에 대한 clade data를 받아야 한다.
## 2. Covid-19 case data
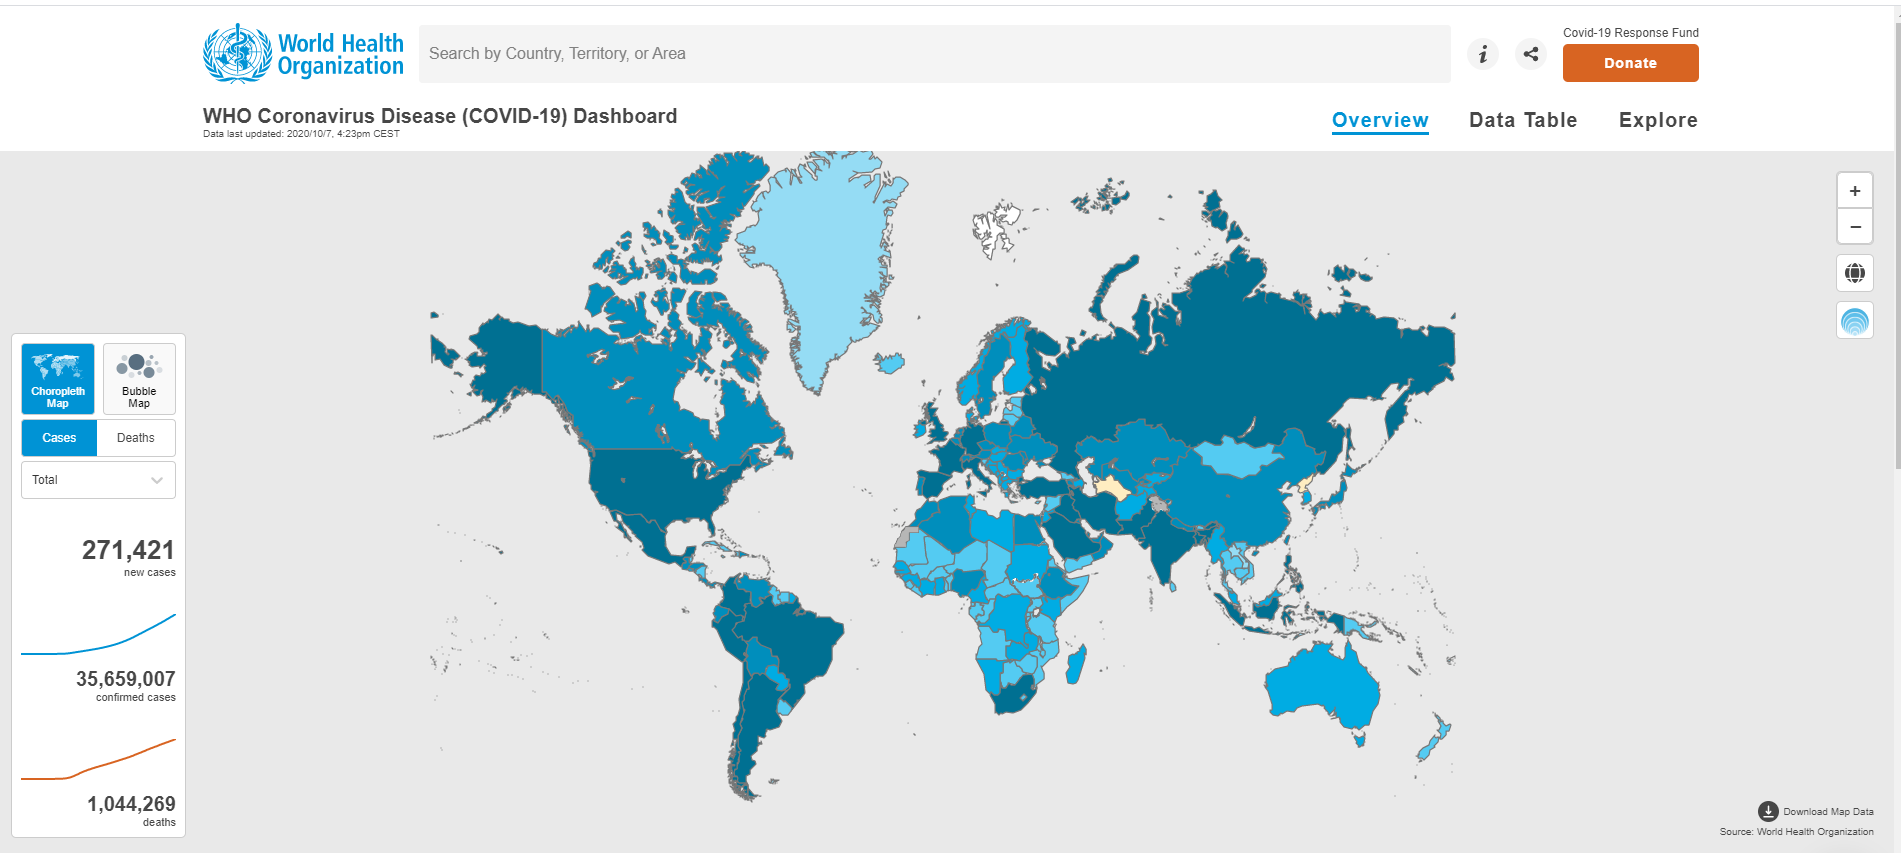
WHO에서 제공한다는 점에서 공신력이 있지만, 아쉽게도 성비나 나이같은 자세한 자료는 얻을 수 없었다. 그런 자료는 각 나라의 보건복지부를 찾아보는게 더 좋을 것이다.
### 들어가기전... 데이터에 관한 대전제
내가 찾은 데이터들은 단순히 이 때 이런 clade의 바이러스 돌연변이가 생겨났고, 이 때 몇명의 확진자, 사망자가 나타났는지만 나와서 모든 확진자들의 바이러스 계통을 알고 있으면 필요가 없는 전제지만, 우리가 알고 있는 건 새로운 계통의 출현 시기와 일일 확진자 수 밖에 없으므로 이런 가설 설정이 불가피 하다.
1. 이미 한 번 그 나라(대륙)에서 발견된 바이러스 계통은 발견된 시점에서부터 지속적으로 발생한다.
2. 확진자가 없거나, 아직 밝혀진 계통이 없다면 계통을 특정할 수 없으므로 데이터에서 제외한다.
## 알아내고자 하는 것
우리가 알아내고자 하는 것은 간단하다. 바이러스 Clade와 확진자 수의 관계, 즉 전파 속도에 관한 것과, 바이러스 clade와 치사율에 관련된 것이 두번 째이다. 정리하면 다음과 같다.
### 1. 바이러스 Clade와 확진자간의 관계
계통에 따라서 바이러스 전파 속도가 달라지는가?
### 2. 바이러스 Clade와 치사율간의 관계
계통에 따라서 바이러스 치사율이 달라지는가?
# 데이터 전처리
## 계통 통계 데이터와 확진자 수 통계 데이터의 비교
GISAID에 모든 나라의 돌연변이 정보가 없기 때문에, 아쉽지만 우리는 가지고 있는 정보들만 활용해야 한다.
돌연변이(새로운 계통)가 발견된 국가의 수: 115
돌연변이가 발견된 국가 중 WHO에 데이터가 있는 국가의 수: 112
제외된 국가및 지역: ['Hong Kong', 'Taiwan', 'Crimea']
왜 세가지의 국가에 대한 정보를 WHO에서 제공하지 않았는지 찾아봤는데, 아래 두가지 이유는 순전히 필자의 추측이다.
1. Taiwan, Hong Kong: WHO에서 정보를 제공하지 않지만 구글에서는 정상적으로 데이터 제공을 하고 있다. 아마도 china에 흡수
되어서 발표되는 것 같다.
2. Crimea: 러시아가 실효 지배하고 있지만 국제 사회에서 인정하지 않고 우크라이나 소유라고 인정을 하기 때문에 논란의 소지가 있어서 WHO에서도 제외된 것으로 보인다.
그래서, 최종적으로 112개 국가에 대해 clade 데이터와 covid-19 virus data를 활용하게 되었다.
그리고 이번에는 Clade에 대해서 얘기해보자면,
Clade는 G 그룹과 L그룹의 **가장 결정적인 차이**는 바이러스와 체내 세포의 결합력을 높여주는 D614G
스파이크 단백질의 구조 변화 유무와 관련이 있다.
Clade는 G,GR,GH,L,O,S,V 총 7개의 계통중에, G 계열인 G,GR,GH를 하나로 묶어서 G-Group,
L,O,S,V그룹을 하나로 묶어서 L-Group이라고 지칭하도록 하겠다.
# 1. 그룹 계통과 확진자간의 관계
## 시간 경과에 따른 6개 대륙의 신규 확진자 수
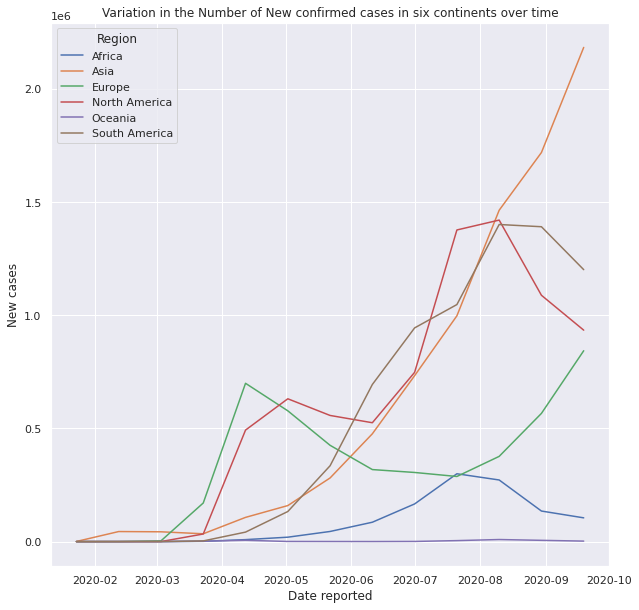
신규 확진자 수는 일일단위로 하기에는 확진자의 수가 너무 많이 변화하기 때문에, 1일 단위로 하면 톱니바퀴 모양이 되어서 데이터를 거의 읽을 수 없게 된다. 그래서 20일 단위로 끊어서 나타냈다.
### 계통 그룹(G-Group, L-Group)별 6개 대륙의 신규 확진자 수의 평균
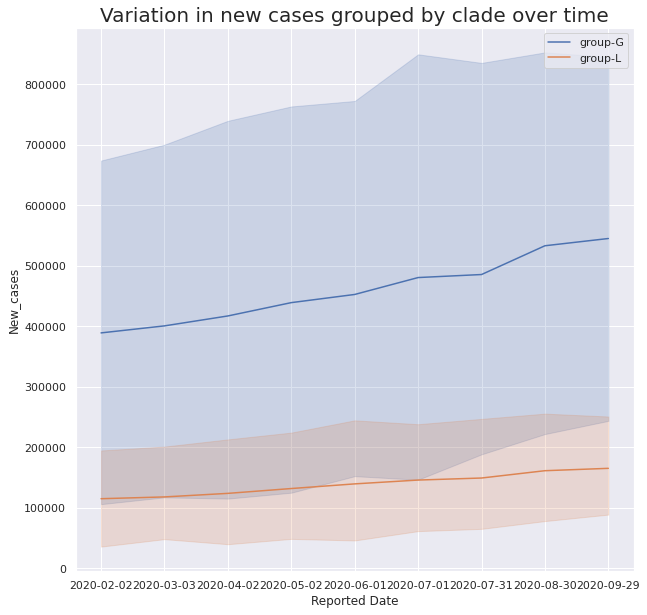
Group-G와 Group-L의 확진자 수 평균을 비교해보면, Group-G가 Group-L보다 항상 많은 수의 신규 확진자를 받고 있는 것을 볼 수 있다.
# 2. 그룹 계통과 치사율간의 관계
치사율은 해당 질병에 걸렸을 때 얼마나 치명적인지, 즉 사망에 이를 수 있는지를 알 수 있는 지표이다. 때문에 가장 민감한 정보가 바로 이 치사율이 아닐까 싶다. 치사율이 굉장히 낮다면, 이건 계절 독감, 감기와 다를 바가 없지만, 불행하게도 코로나 바이러스는 순간적으로 엄청난 치사율을 보여준다. 치사율 공식은 다음과 같다.
# 치사율 공식
X= 치사율
D= 누적 사망자
C= 누적 확진자

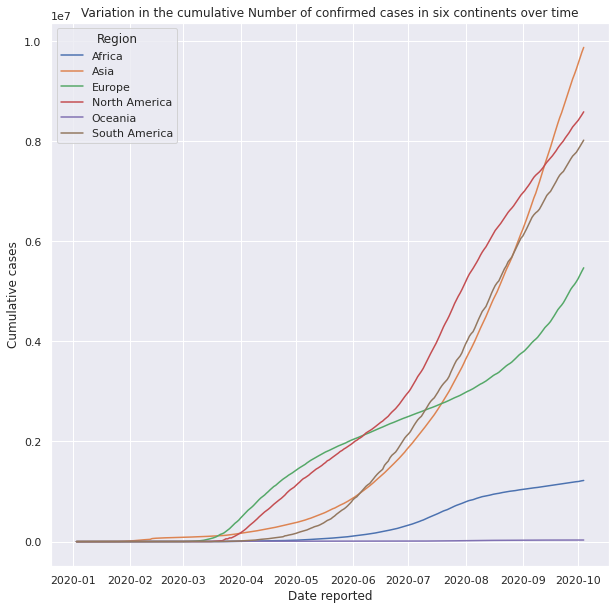
## 시간 경과에 따른 6개 대륙의 누적 확진자 수
##시간 경과에 따른 6개 대륙의 누적 사망자 수
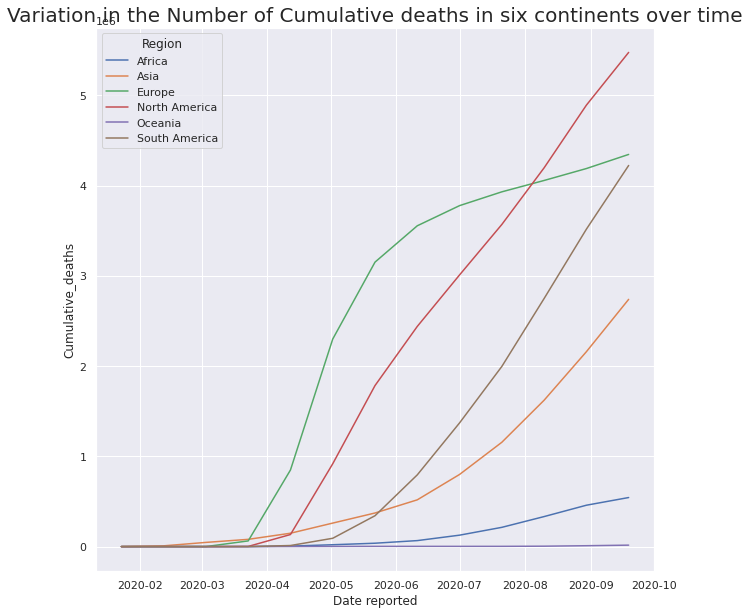
두 그래프를 보기에도, 신규 사망자, 확진자 보다는 훨씬더 안정적인 변화를 보여준다.
###
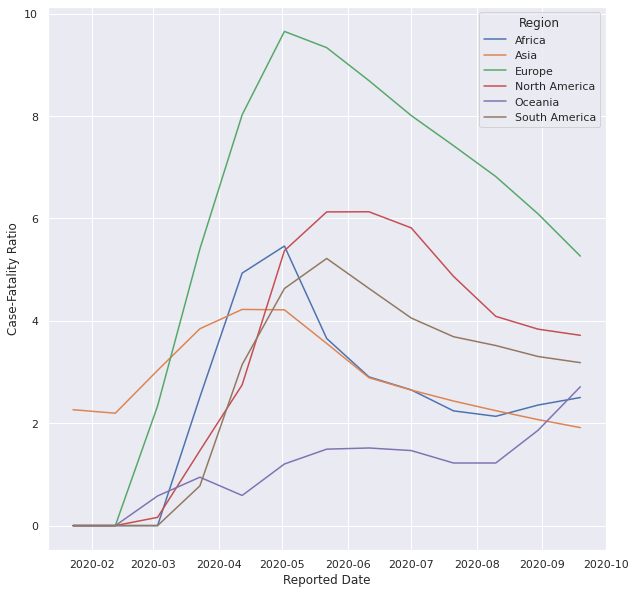
## 시간 경과에 따른 6개 대륙에서의 치사율 변화
## 시간 경과에 따른 6개 대륙에서의 치사율 분포
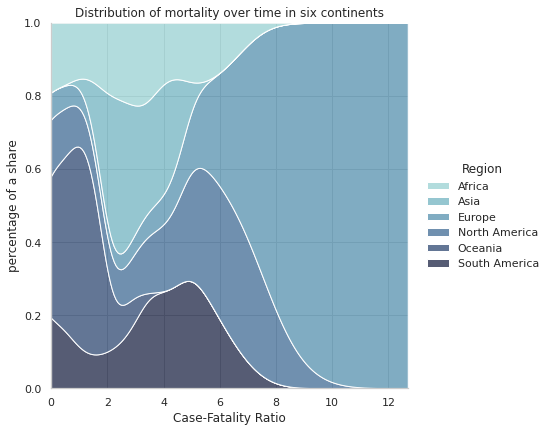
가장 높은 치사율을 보유하고 있는 것은 유럽 대륙이고, 그리고 북미,남미, 아프리카,아시아, 오세아니아가 가장 낮은 치사율을
가지고 있다. 그러면 10월 4일 기준으로 계통 그룹 비율은 어떻게 될까?
## 대륙과 계통 그룹 비율 (2020.10.04 기준)
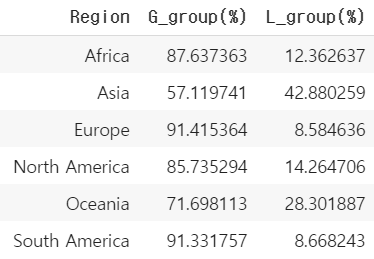
분명 G-group이 많으면 치사율이 높게 보이기는 하지만, 조금 더 정확한 상관 관계를 알기 위해서 correlation test를 진행해 보였다.
## 계통 및 계통 그룹 별 전체 치사율 상관 관계
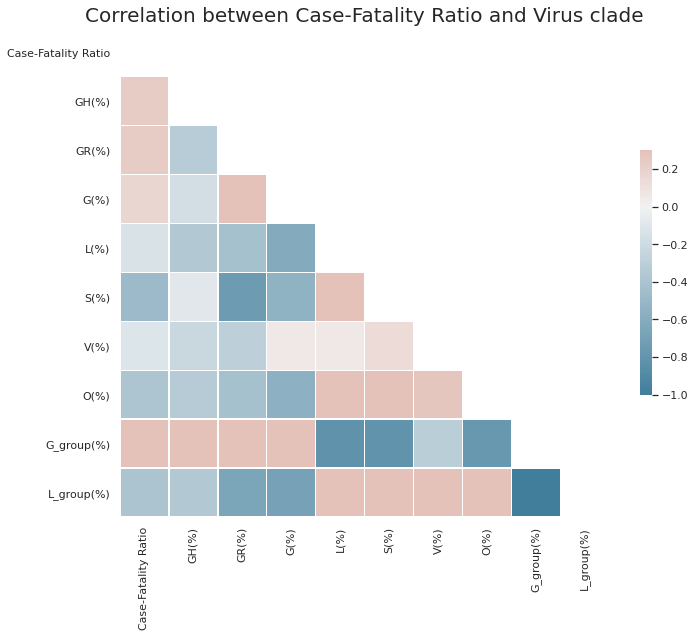
매우 명백하게도, 붉은 빛을 띄는 G group은 양의 상관 관계를, 푸른 빛을 띄는 L-group은 음의 상관 관계를 갖는다.
## 결론
### 1. G-group이 L-group 보다 훨씬 더 전파력이 높을 것이다.
### 2. G-group이 L-Group보다 더 많은 비율을 차지하고 있을 때 치사율이 올라간다.
### 3. 따라서 G-group은 L-group 보다 전파력도 빠르고 치사율도 높을 수 있다.
### 4. 그러나 더 정확한 결과를 얻고 싶다면 조금 더 구체적인 데이터가 필요하다.
## 맺으며
한 때 난제라고 불렸던, 4색 지도 색칠문제가 있다. 컴퓨터 공학에서 굉장히 유명한 문제였는데, 어떠한 경우에서도 4가지 색으로 서로 인접한 국가들이 같은 색을 가질 수 없도록 칠할 수 있는지에 대한 문제다. 그런데 한 사람이 컴퓨터를 이용해서 모든 경우의 수를 체크하고 가능하다는 결론을 내렸지만 당연히 학계의 반발이 있었다. 무조건 정형화된 알고리즘이나 다른 무언가가 필요하다는게 사람들의 생각이었다.
하지만 정말 데이터로 결론을 내는 것이 의미가 없을까?
나는 생물학자가 아니다. 생명과학에 대한 전문적인 지식도 없고, 많은 양의 논문을 읽은 것도 아니다. 하지만 내게는 데이터가 있고, 데이터는 앞으로 방대해지고 더욱 더 구체적인 정보를 담고 있을 것이다. 이렇게 했는데도 어느정도 의미 있는 상관 관계가 나왔는데, 앞으로 먼저 통계를 적용해서 생명공학의 길을 제시해주고, 생물학자들이 그 길을 검증해주는 공생관계가 되지 않을까? 조심스럽게 예상해본다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.