codestates / codestates/ds-blog
[윤현태] mpg 데이터 분석해보기 (feat. PCA, k-means clustering)[미완성]
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
### 들어가며
이번 시간에 여러가지를 배웠는데, 그 중에서도 가장 기억에 남는 것은 PCA, 그리고 K-means clustering이다. 그래서 mpg 데이터를 분석하면서 PCA와 K-means clustering에 대해서 알아볼까 한다.
###K-means clustering 에 대해서 간단하게 알아보자.
K-means clustering은 대표적인 군집화 과정중 하나로, 군집화는 네가지 방법으로 이루어진다.
step 1, 내가 하고자 하는 군집 수 만큼 임의의 데이터들을 선택한다.
step 2, 각각의 데이터들을 내가 선택한 데이터들과의 연관성 계산(대표적으로 가우시안 거리 계산법)을 통해 가장 가까운 군집으로 할당한다
step 3,각각의 군집에 대해서 중앙점들을 계산한다.
step 4, step 2, step 3 방법을 반복하고, 더이상 중앙점들이 바뀌지 않을 때 군집화가 종료된다.
단점: 초기값 위치, 데이터 분포 크기, 데이터 밀도, 데이터 분포 형태에 따라서 제대로 된 군집화가 이루어지지 않을 수 있다.
### PCA는 무엇인지 간단하게 알아보자.
PCA는 우리말로 하면 주성분분석으로, 최대한 분산을 잘 보존하면서 서로 직교하는 기저(축)을 찾아, 고차원(feature들이 많은)의 데이터들을 선형 연관성이 없는 저차원으로 낮추는 역할을 한다. 이해를 돕기 위해서 다음과 같은 그림을 준비해 봤다.
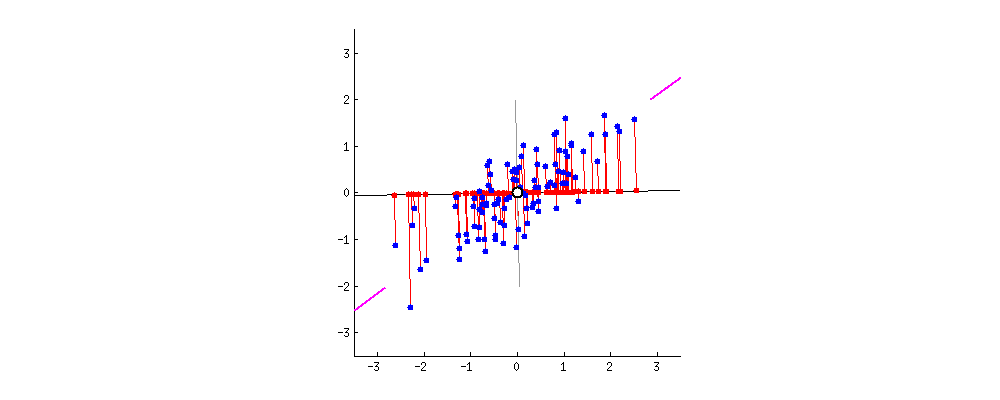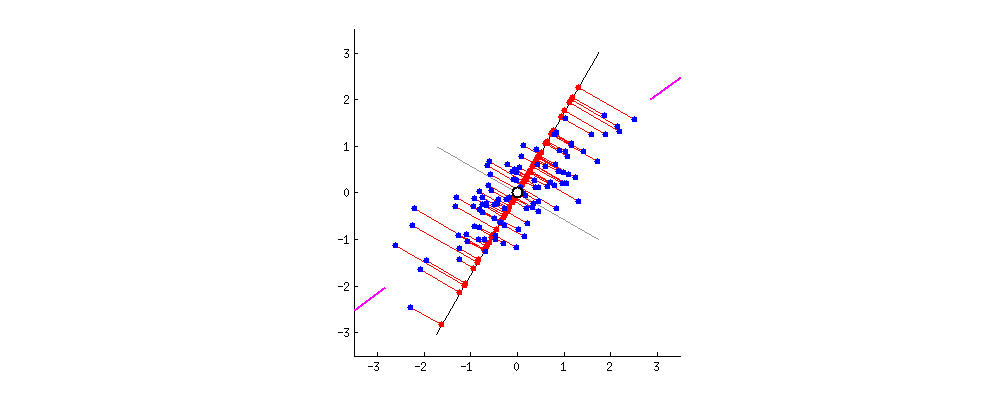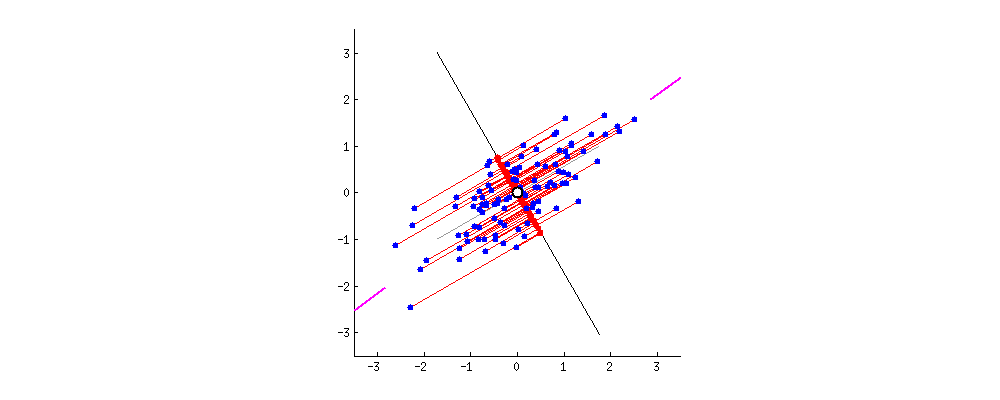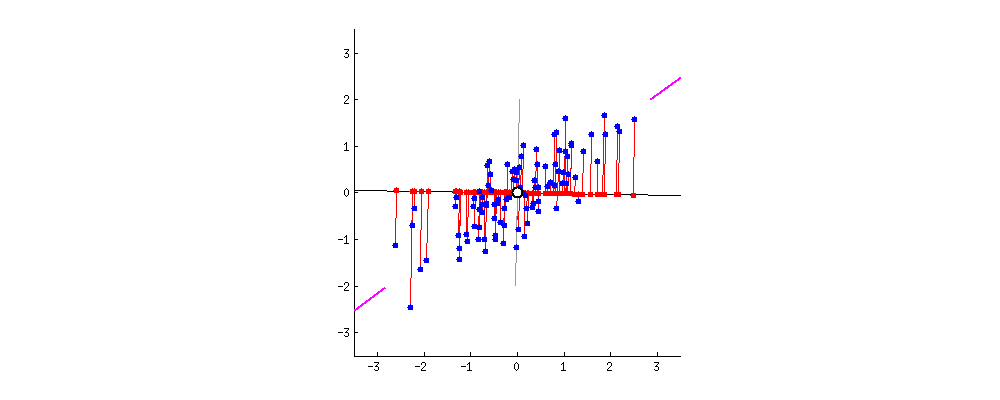
PCA하면 굉장히 많이 등장하는 gif인데, 2차원에 존재하는 데이터들의 각각의 축에 대한 평균 값을 구한다음, 그 점을 기점으로 하나의 선을 그어서 최대한 많은 분산을 가져서 데이터의 원형을 최대한 보존할 수 있도록 한다. 당연히 고차원 공간에 있는 데이터를 저차원으로 압축하면 그에 따른 특징의 손실이 일어나게 되며, 대체로 90%정도의 형태를 보존할 수 있는 주성분 까지 선택하는 편이다. 그래서 필자는 mpg 데이터를 가지고 PCA를 해보려고 한다.
###mpg데이터에 대해서 간단하게 알아보자.
mpg는 (miles per gallon)으로, 70,80년대 미국, 일본, 유럽에서 생산되었던 차들에 대한 데이터이다. 데이터의 column으로는
mpg | cylinders | displacement | horsepower | weight | acceleration | model_year | origin | name
-- | -- | -- | -- | -- | -- | -- | -- | --
이 있고, 자동차의 기본적인 특징, 특히 성능들을 나타내고 있다.
PCA를 하면 어떻게 될까 간단하게 예상해볼 수 있는데, 어떤 나라가 특출난 규격 외의 자동차를 만들지 않는다면, 자동차들은 많이 나뉘지는 않을 것이다. 그래도 혹시 모르니, PCA를 통해 한번 알아보자.
먼저 mpg 데이터를 준비한다.
```py
import pandas as pd
import seaborn as sns
df=sns.load_dataset("mpg")
df.dropna(inplace=True)
df=df.drop(['name'],axis=1)
```
그리고 PCA를 하기 위해서는 특별한 라이브러리가 필요하다. 바로 sklearn.decomposition과 sklearn.preprocessing인데,
decomposition 에는 PCA가 존재하고, sklearn.perprocessing에는 정규화가 존재한다.
PCA를 할 데이터이니 categorical data type인 'origin'은 미리 없애주자.
```py
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler
import matplotlib.pyplot as plt
from numpy import array
import numpy as np
df_n=df.drop(['origin'],axis=1)
```
먼저 데이터들의 규격들을 정규화 한다.
```py
scaler=StandardScaler()
zlist=array(df_n.values.tolist())
```
여기서부터는 조금 복잡할 수 있는데, 우선 데이터의 feature들은 7개가 있으므로 주성분도 최대 7개까지만 할 수 있다. 미리 column name tag로 사용할 PC1~PC7을 만들어준다.
```py
col=[]
for i in range(1,8):
col.append('PC'+str(i))
```
그리고 PCA함수를 사용해 mpg 데이터를 주성분이 7개까지 있는 데이터로 재편성한다.
```py
pca=PCA(n_components=7)
pc=pca.fit_transform(df_n)
pc_df=pd.DataFrame(data=pc,columns=col)
vals=pca.explained_variance_ratio_
```
그리고 PC1부터 PC7까지 각각 얼마나 varinace를 설명해줄 수 있는지에 대한 정보가 vals에 담겨져 있는데, 이것을 이용해 순차적으로 더해지는 scree plot을 그린다.
```py
#주성분 개수 뽑아내기
num_components=len(pca.explained_variance_ratio_)
ind=np.arange(num_components)+1
plt.figure(figsize=(10,10))
ax=plt.subplot()
cumvals=np.cumsum(vals)
plt.bar(ind, vals, color = '#abcbfe')
plt.plot(ind, cumvals, color = '#fecbee')
for i in range(num_components):
ax.annotate(str(np.round(vals[i]*100,1))+'%',
(ind[i],vals[i]),
va="bottom",
ha="center",
fontsize=3)
ax.set_xlabel("Number of PC")
ax.set_ylabel("Variance (%)")
plt.title('Scree plot');
```
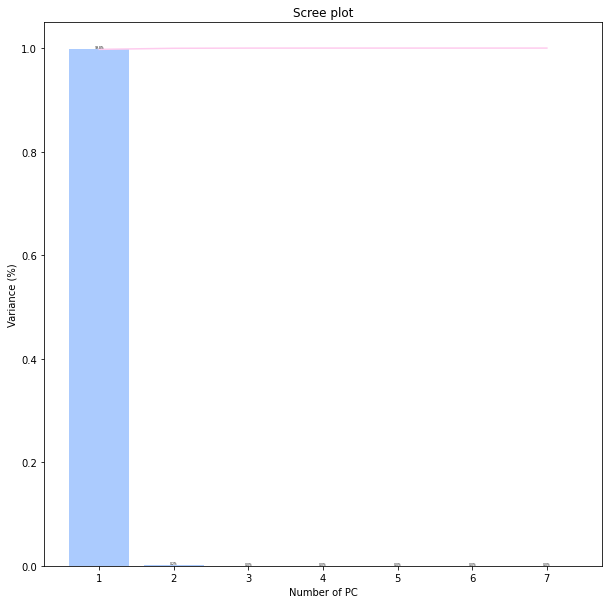
PCA7까지 분석해봤지만, 사실상 PCA1이 거의다 데이터를 설명해주고 있다. 그러나 PCA2가 조금 있는 걸로 봤을 때, 규격외의 자동차가 아주 조금 있는 것 처럼 보인다. 그럼 자동차들이 나름대로 규격화 되었다면, 어떻게 나누는 것이 가장 좋은지를 알아보기 위해, 우선 K-means clustering을 해보자.
```py
from sklearn.cluster import KMeans
sum_of_squared_distances = []
K = range(1,10)
for k in K:
km = KMeans(n_clusters=k)
km = km.fit(df_n)
sum_of_squared_distances.append(km.inertia_)
plt.plot(K, sum_of_squared_distances, 'bx-')
plt.xlabel('k')
plt.ylabel('Sum_of_squared_distances')
plt.title('Elbow Method For Optimal k')
plt.show()
```
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.