codestates / codestates/ds-blog
선형대수학, 내 지식의 파편을 clustering 해보자.
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
# 선형대수학, 내 지식의 파편을 clustering 해보자.
## 선형대수학.
자신의 백그라운드가 어디냐에 따라서 익숙하게 접해봤을 수도, 생소할 수도 있는 이 이름. 선형대수학을 대학교를 다닐때 수업을 들었었지만 알아듣기가 어려워 포기했던 기억이 있다. 극복하려는 마음도 없었으니 진정한 '선포자(선형대수학 포기자)'였던 셈이다. 그런데 요즘 데이터 사이언스를 공부하면서 요즘 만나게 된 호적수가 있으니 그 이름이 바로 '선형대수학'.
그래서 내가 요즘 공부하고 있는 선형대수학(이라고 할 수 없을 정도로 단편적이지만)에 대해 스스로 개념을 정리할 겸 선형대수학에 대해 얘기해볼까 한다. 다만 하나의 단독 학문으로서 다뤄지고있을 만큼 선형대수학은 너무 광범위하고 또 내가 아직 그만큼 잘 알지도 못하기 때문에 지금 공부하고 있는 데이터 사이언스 분야에서 내가 이번주에 공부한 내용이 어떻게 사용되는지, 어떤 의미를 가지고 있는지에 대해 소개하려고 한다.
------
먼저 선형대수학이라는 학문이 왜 데이터를 다룰때 필요한지에 대해 간략하게 짚고 넘어가자면, 우리가 컴퓨터에 작업을 명령할 때 효율적으로 작업할 수 있게 명령할 수 있는 방법은 데이터 구조를 통해 가능하며 이런 부분을 더욱 빠르고 효율적으로 최적화 하는 것에 대한 부분을 컴퓨터 과학이라고 한다. 따라서 방대한 양의 데이터를 다룬다는 말은 곧 효율적으로 컴퓨터를 다룬다는 말과 다르지 않고 컴퓨터로 대형연산을 효율적으로 실행하기 위한 수단으로 선형대수를 공부해야 하는 것이다.
나는 작은 단위부터 큰 단위를 공부해나갔지만 일주일간의 축적된 지식을 활용해서 배운내용을 거꾸로 거슬러 올라가볼까 한다. 처음 배울 때는 왜 이걸 하는지 몰랐지만 지금은 '아 이런걸 하기 위해서 그때 그런 것을 배운거구나'라는 생각이 드는만큼 큰 단위에서 작게 파고들어가는 것이 독자들의 이해를 도울 수 있을 것 같다.
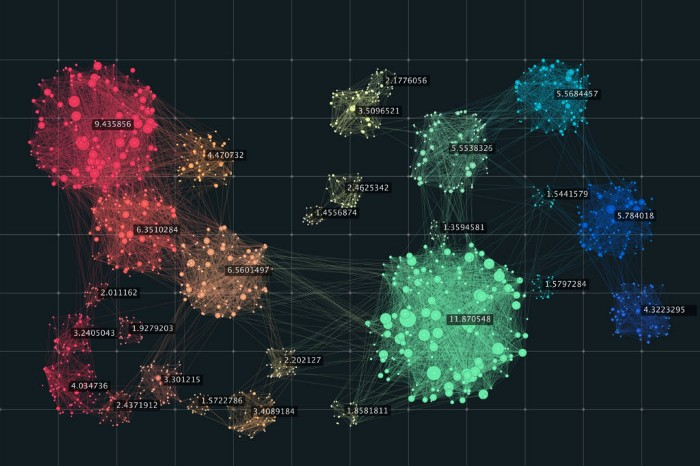
먼저 우리가 현실에서 데이터를 다룰 때, 자원적인 측면에서 모든 데이터를 개별적으로 살펴볼 수가 없기 때문에 데이터들을 clustering(군집화)해야 한다. 위의 사진에서처럼 흩어져 있는 데이터들을 대표성을 띄는 군집으로 묶어주기 위해 **유사도**를 측정하고, 어떤 기준으로 유사도를 결정할 것이냐 하는 문제에서 **Euclidean** 거리계산 방식을 활용한 것이 **K-means clustering**이다.
그러면 이렇게 K-means clustering을 하는 과정에서 원래의 데이터에서 수많은 차원으로 흩어져있는 데이터들을 연산을 빠르게 하기위해 데이터를 가볍게 만들어줄 필요가 생기게 된다. 이때 고차원의 데이터를 feature extraction의 차원축소 방법론 중 하나인 **PCA(Principal Component analysis** method를 사용하여 차원을 축소하게 되고 원래의 데이터에서 차원을 축소하면서 생기는 정보의 손실을 최소화하기 위해 데이터의 누적분산을 고려하여 원래의 데이터를 어느정도 유지하면서 차원을 축소할 것인가를 결정한다.
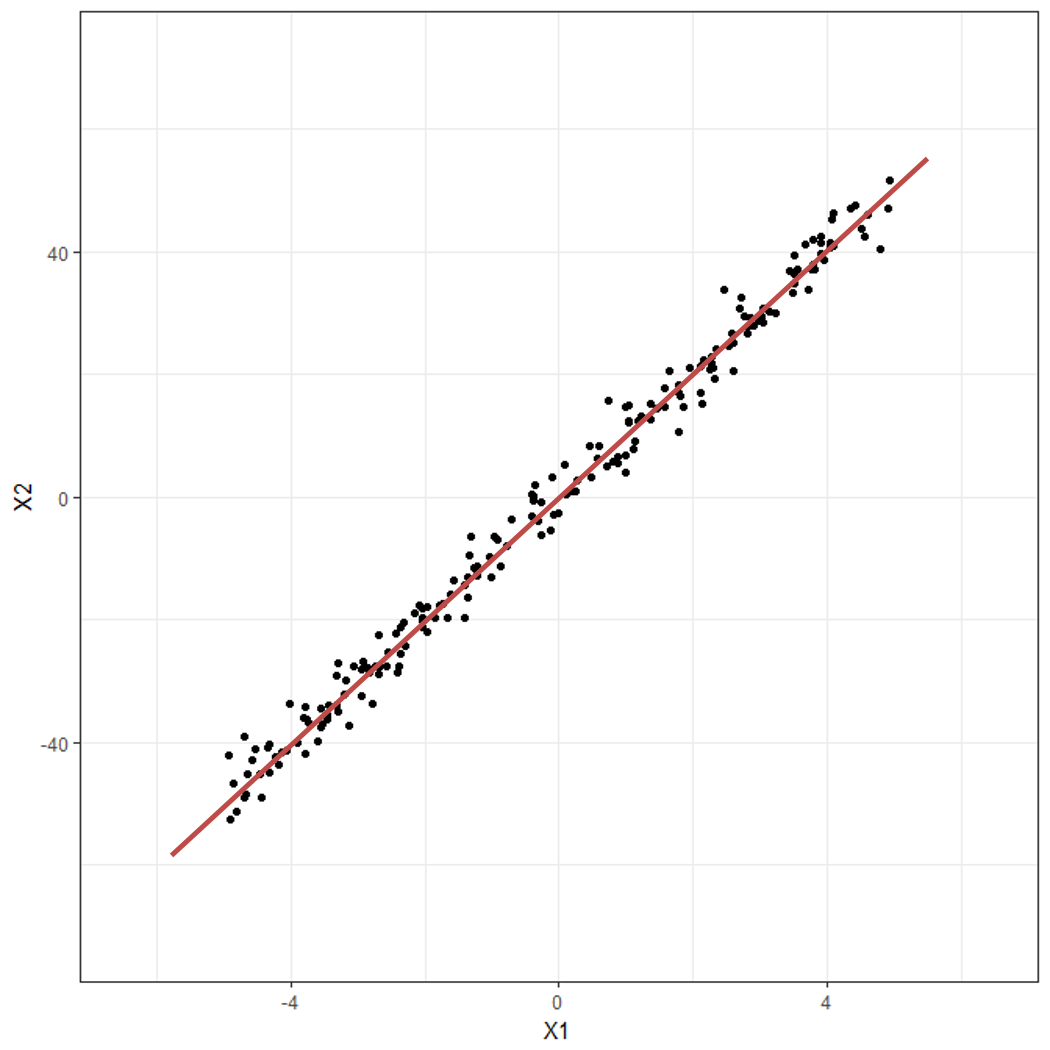
여기서 PCA를 시행한다는 의미는 고차원의 데이터가 주어졌을 떄 원래의 고차원 데이터와 가장 비슷하면서 더 낮은 차원의 데이터를 찾아내는 방법을 말한다. 더 낮은 차원의 데이터값의 변화가 높은 차원의 데이터값의 변화를 설명할 수 있다는 것은 복잡해보이는 고차원 데이터의 변화를 단순한 몇가지의 원인으로 설명할 수 있다는 말과 같다.
이를 설명하기 위해서는 벡터라는 개념을 짚고 넘어가야 하는데 필자는 벡터라는 말을 고등학생 때 처음 들어봤다. 수학의 정석 책에서 '스칼라와 벡터'라는 뭔가 멋있어 보이는 단어를 접했다. 그때는 뭔가 있어보이지만 어려웠던 개념이 대학교에 진학해서 역학을 배우면서 차츰 개념이 이해되기 시작했다.
우리가 배우던 일반적인 고등학생 수준의 수학에서 크기만으로 정해지는 양을 스칼라라고 하는데 평면 또는 공간에 있는 어떤 물체에 힘을 줄 때, 힘의 크기에 따라 물체는 다른 운동을 한다. 또 같은 힘을 준다고 해도 힘이 작용하는 방향에 따라 그 물체의 운동은 달라진다. 따라서 힘에 대해서는 그 크기와 방향을 함께 생각할 필요가 있고 이것이 바로 벡터라는 개념이다.
다시 차원축소로 돌아가서,
차원축소라는 개념은 고차원의 벡터를 더 낮은 차원의 벡터공간에 투영하는 문제로 바꿔서 생각해볼 수 있는데 이때 고차원의 데이터에서 원래 데이터의 정보를 최대한 반영할 수 있도록 최대 분산의 방향을 찾아 작은 차원으로 투영하는 것이다. 여기서 데이터들의 분산이 가장 크게 유지시키면서 투영할 수 있는 축을 찾아야 하고 이 축이 바로 **Eigen Vector(고유벡터)** 와 **Eigen value(고유값)**이다.
Eigen vector는 선형변환을 이루더라도 크기만 변화하고 방향은 변하지 않는 벡터를 의미한다. 즉 원래정보를 담고있는 고차원벡터가 낮은차원으로 투영될 때 최대 분산을 유지할 수 있도록 해주는 축이며 이때 원래의 벡터에서 변하는 스칼라값이 바로 고유값이 된다.
바로 이런 개념들을 이해하기 위하여 선형대수학을 공부하면서 초반부에는 행렬과 벡터의 기본적인 연산에 대해 공부하게 된다. 오늘은 의미없어보이는 벡터와 행렬을 왜 공부해야 하는가에 대해 생각해보는 시간을 가졌다. 정확한 정보를 전달해야하는데 내가 이해하는 바가 틀린점이 있다면 기탄없는 지적을 부탁드림과 동시에 긴글을 읽어준 그대에게 깊은 감사를 보낸다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.