codestates / codestates/ds-blog
[송지] 이번주에 배운 선형대수 정리
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
나는 문과생이었다. '기하와 벡터'라는 과목이 있는건 알았지만 나와는 상관이 없었고, '확률과 통계' 또한 마찬가지였다.
입버릇처럼 사칙연산만 하면 되지 왜 이렇게 까지 배워야 해? 계산은 계산기가 해주잖아! 라고 외치는 one of 수포자였단 말이다.
본격적인 강의를 들은지 3주차, 선형대수를 시작하면서 특히 어제는 그동안의 의욕이 풀썩 무너진 날이다.
강의는 세숫대야의 물방을 하나 정도로 추리고 추린 내용만 짚고 넘어가는데 '벡터'의 개념 자체를 처음 들어본 나로써는 정말 고역이었다. 그치만 공부하면서 이런 생각도 처음 들었다.
**"그래서 이걸 사용하는 목적이 뭐지? 뭘 위해 이 개념들이 필요한거지?"**
그동안 매일 과제 해결에만 급급했던 내 모습은, 고등학교때 수학 공부를 하던 모습 그대로였다.
일단 답만 맞추면 되잖아. 이해는 나중에 하자.
수험생활이 끝날때까지 이 부채감을 해결하지 못했던, 그 무거운 기억이 떠올랐다.
> ### 선형대수를 왜 배워야할까?
데이터 분석 시, 기존의 수집된 데이터를 가지고 전처리를 한 후 미래의 데이터를 예측하거나 데이터에서 인사이트를 뽑아낸다.
많은 경우, 데이터의 종류가 너무 방대하여 계산이 너무 느려지는데, 중요한 데이터만 뽑아내는 차원 축소, 딥러닝, 추천 알고리즘 등은 모두 그 기본이 행렬 벡터 공간에서 이루어진다.
데이터 분석에 활용되는 *수많은 알고리즘들의 기반*이 선형대수, 즉 벡터 공간에서 정의되는 것이 대부분이다.
### 1. 선형이란?
복잡한 정보를 간단한 직선으로 바꾸는 것을 선형화(Linearize)라고 한다.
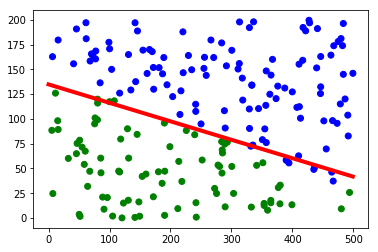
위와 같은 그림을 볼때, "x축 0-100사이에 초록색 점이 20여개가 있고, 파란점은 15개 정도가 있는데, 각 점들의 y축은 25개씩 선을 그었을때 골고루 분포해 있다." 라는 식으로 하나하나 살펴보진 않는다.
보통은 직관적으로 초록색 점들의 무리와 파란색 점들의 무리를 사이에 선을 그어 선 아래는 초록색, 선 위는 파란색이 있구나 라는 식으로 단순화 시켜 생각하게 된다. 이런 방식을 **선형 분류(Linear Classification)** 라고 한다.
어떠한 데이터를 가지고 있다면, 간단한 직선 하나로 경향성을 파악할 수 있다. 이를 **선형회귀(Linear regression)** 이라 한다.
### 2. 공분산과 상관관계
**공분산(covariance)** 은 두 개의 확률변수에 대한 흩어짐의 정도가 양의 방향으로 되있는지, 음의 방향으로 되있는지 나타내는 수치를 말한다.
두 변수는 서로 변한다. 쉽게 말해 x가 변하면 y는 어떻게 변하는지를 표현하는 것이다.
우리가 쉽게 생각하는 분산은 변수가 평균으로부터 얼마나 퍼져있는지, 평균으로부터의 '거리'를 보여준다면,
공분산은 어떤 모양으로 퍼져있는지, 그저 두 변수가 관계를 가지는 *방향성* 만을 보여준다.
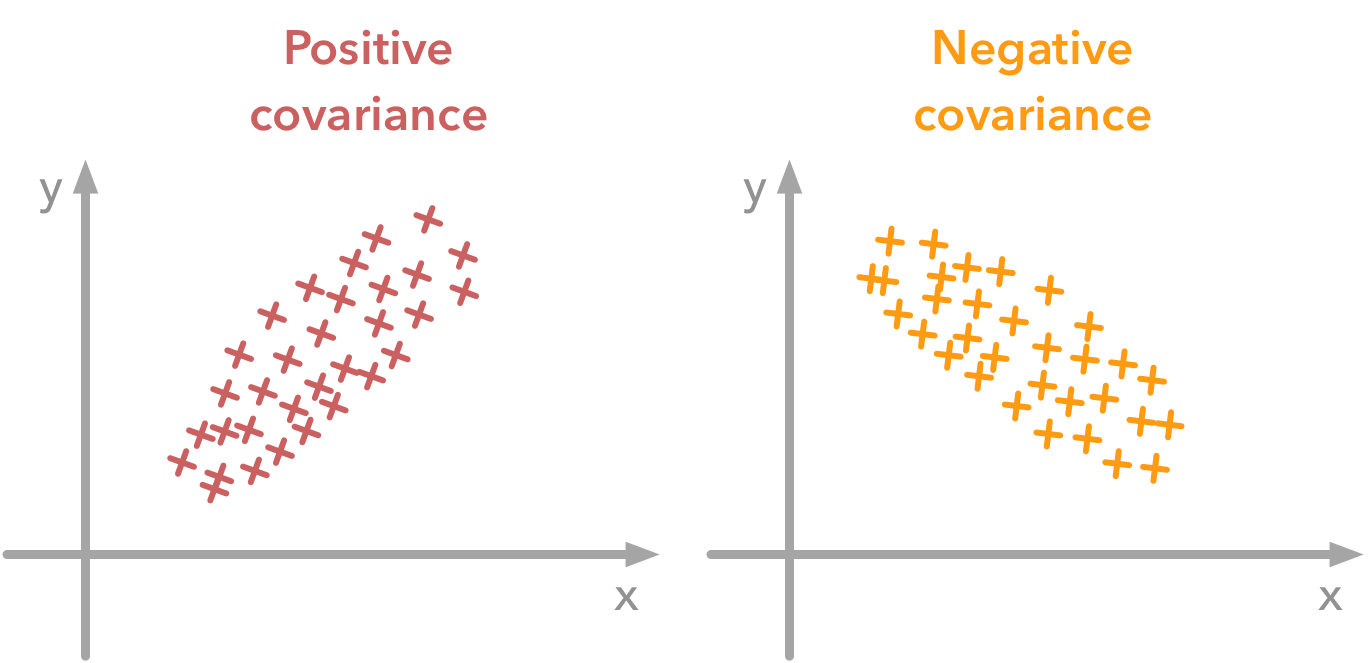
x가 증가하면 y도 증가하는 양의 방향, 혹은 x가 증가하면 y는 감소하는 음의 방향
그러나 공분산은 단위의 문제가 있기 때문에 공분산이 크다고 상관관계가 크다고 말할 수 없다.
실제 데이터들의 공분산 값을 비교했을 때, 공분산 값이 더 크면 더 강한 선형관계를 가져야 하는데 반드시 그렇지는 않다.
**상관관계(correlation)** 의 상관계수는 강도를 말해주지 못하는 공분산의 문제점을 해결하기 위해 만들어졌다.
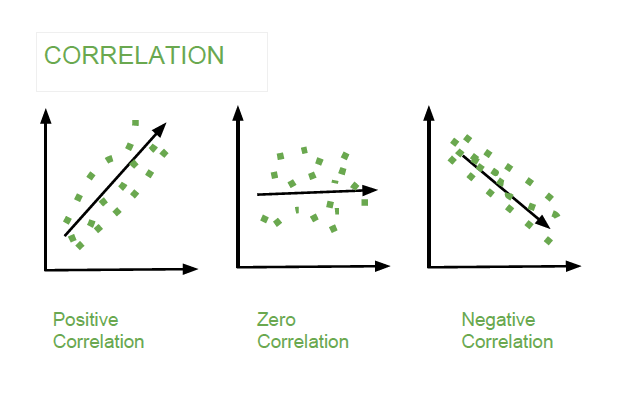
**상관계수(correlation coefficeint)** 는 공분산의 단위를 -1 ~ 1 사이로 표준화한 값이다.
상관계수가 -1일 때 완전한 음의 선형관계, +1일 때 완전한 양의 선형관계, 0 일 때에는 선형관계가 존재하지 않는다
### 3. PCA(주성분 분석)
PCA는 방대한 데이터셋에서 중요한 데이터만 뽑아내는 차원축소의 기술 중 하나다.
원본 데이터의 정보를 최대한 유지하면서 낮은 차원의 데이터셋으로 '변환' 시킨다.
데이터의 여러 feature들 가운데서 가장 분산을 크게 하는 가상의 features를 만드는 것인데,
벡터 공간에서의 모양을 생각하면 주어진 분포에 대해서 중요한 방향을 **직선** 으로 분석하는 것이라고 말할 수 있다.
(참고로 데이터 작업 시 'feature를 뽑는다'는 말은 차원 축소를 한다는 말이다.)
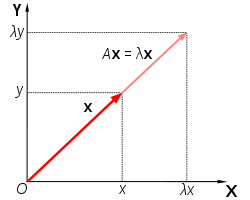
이때 **고유값(Eigenvalue)** 과 **고유벡터(Eigenvector)** 의 개념이 들어간다.
고유벡터는 주어진 데이터에 대해 분산을 가장 크게 유지시키는 역할을 한다.
고유값은 변환(Transformation) 도중 늘어나고 줄어드는 정도의 배수이고, 고유벡터는 span하는 선 위에 머무르며 회전해서 벗어나는 일이 없다.
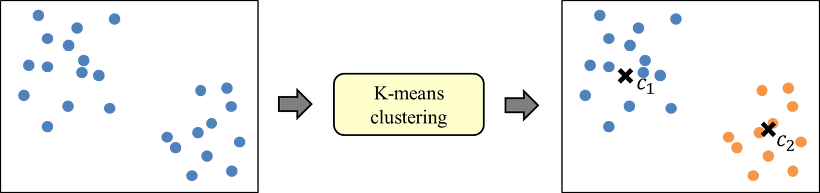
### 4. K-means clustering
K-means clustering은 데이터를 입력받아 이를 소수의 그룹으로 묶는 알고리즘이다.
Label이 없는 데이터를 입력받아 각 데이터에 label을 할당함으로써 군집화를 수행한다.
K-mean 클러스터링의 과정을 이해하는데 [이 영상](https://www.youtube.com/watch?v=9TR54u08IGU&t=19s)이 크게 도움되었다.
> 리뷰
- 선형대수에서도 아주 몇몇 개념만 추려서 배웠는데, 그래도 한번 정리하고 나니 내가 뭘 배웠는지 기억할 수 있어서 좋다.
- 일단 받아들이고 넘어가려고 부단히 노력하였으나, 혼자 복습을 하다보면 근데 이게 뭘 위한거지? 하는 생각이 불쑥 들었다. 한번씩 목적 혹은 목표를 상기하면 덜 헤매게 되는 것 같다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.