codestates / codestates/ds-blog
[최근후] 차원축소란? (동그라미, 세모, 네모와 친구되기)
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
# Intro
### 우선, 차원 축소의 개념을 예를통해 이해해보자~
우리는 3차원 공간에 살고있다. 우리가 보는 모든것은 3차원이기 때문에 4차원을 절대 이해할 수 없다. 예를들어, 3차원에 존재하고있는 내가 2차원에있는 동그라미, 세모, 네모랑 친구가 되고싶어서 내가 3차원에서 어떻게 생겼는지 아무리 열심히 설명을 해줘 봤자 그들이 볼 수 있는건 2차원에 닿고있는 내 발바닥모양 일것이다.
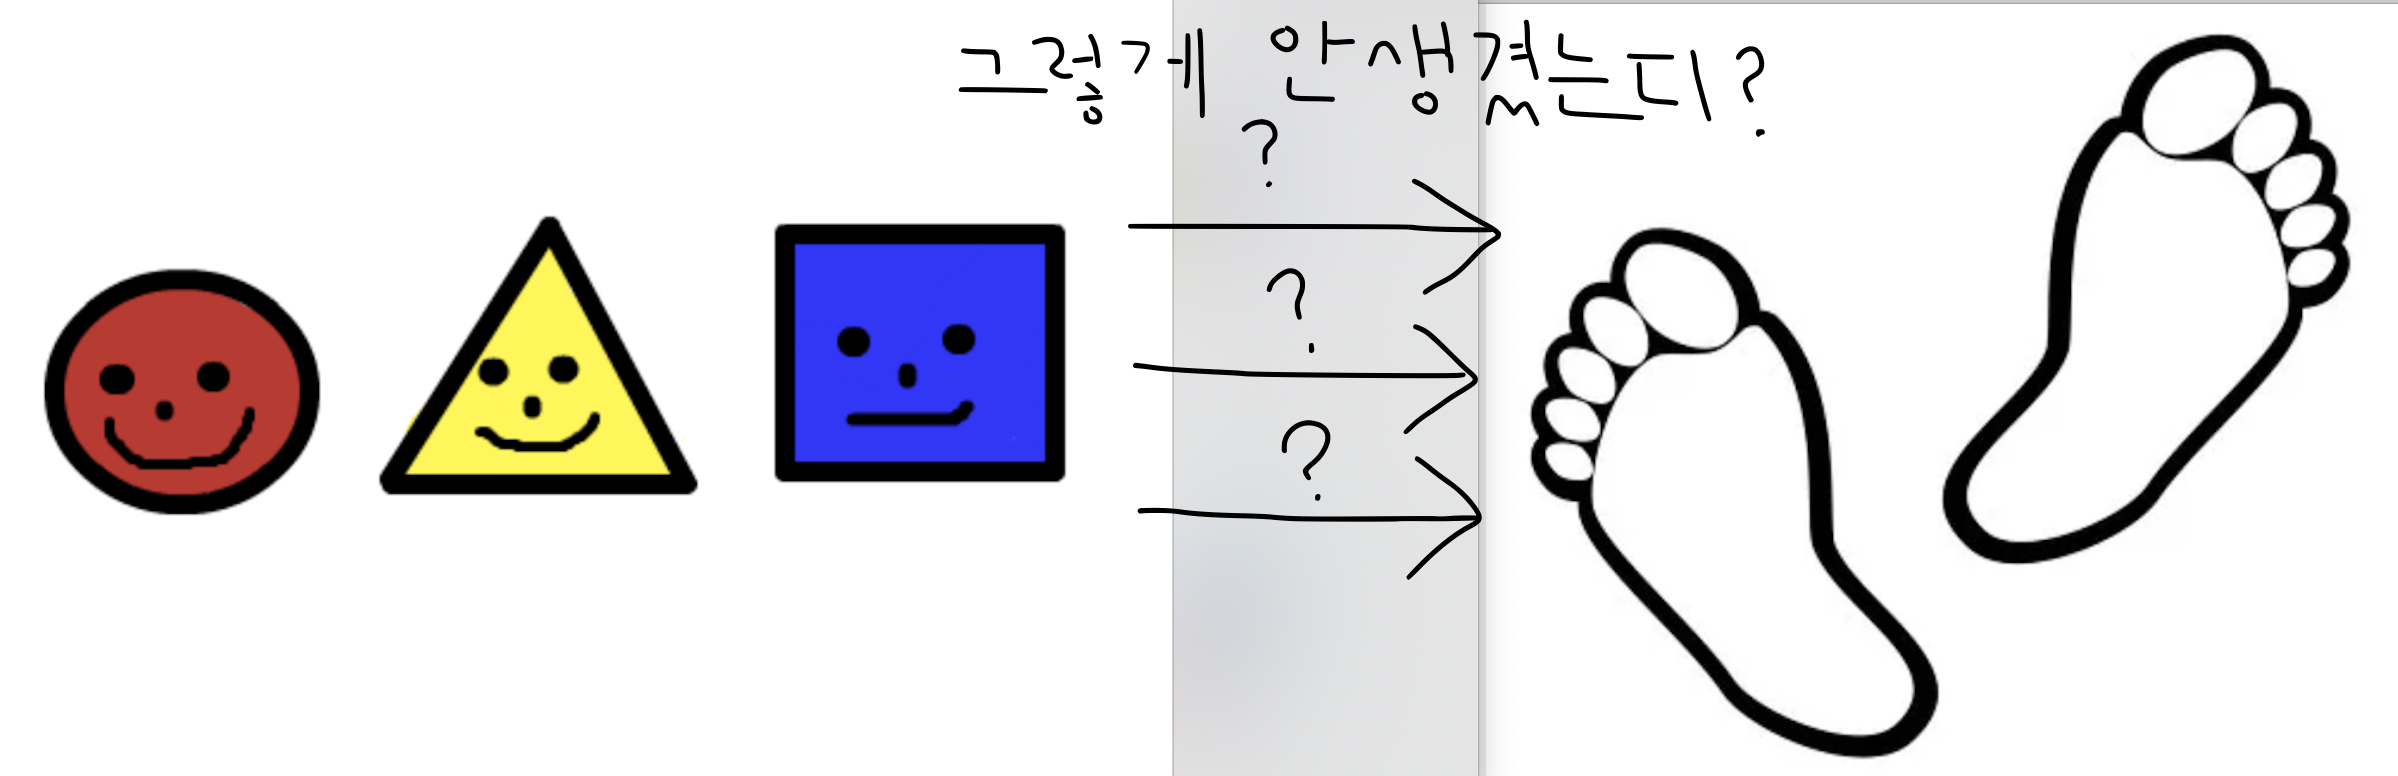
그렇다면 우리는 어떻게 동그라미, 세모, 네모에게 우리의 모습을 그들이 이해할 수 있는 정도에서 잘 설명해 줄수있을까? 이때 우리는 차원 축소를 쓸 수 있다!!!
차원축소 : 차원이라함은 보통, 물리학적인 개념에서의 공간을 의미합니다. 하지만 데이터를 설명할때의 차원은 "피쳐의 수"에 해당합니다. 즉, 차원축소는 피쳐의 수를 줄이는것을 의미합니다. 즉, **차원축소 = 피쳐의 수 줄이기.**
그렇다면 우리는 왜 차원축소를 해야할까요?
---
## why?
* 덜 중요한 피쳐 vs 중요한 피쳐 : 데이터 분석을 통해 우리는 결국 유의미한 결과를 만들어 내야합니다. 그런데 모든 피쳐가 동일하게 중요한것은 아니기때문에, 중요하지 않은 피쳐들을 데이터분석에 모두 포함하는것은 효율적인 분석에 방해가 될 수 있습니다. 그렇기에 우리는 그중에서 비교적으로 중요하다고 관찰되는 피쳐를 골라야합니다.
* 시각화 : 시각화는 데이터 분석에서 빼놓고 말할 수 없는 중요한 부분입니다. 데이터 분석가는 자신이 도출한 결과를 바탕으로 자신의 의견과 그 결과를 어필해야하는데, 이때 시각화는 분석가의 주장을 뒷받침 해주는 객관적인 지표입니다. 하지만 처음에 언급했던 동그라미, 세모, 네모이야기처럼 우리는 우리가 존재하는 차원을 초월하는것은 직관적으로 이해하기 힘들어합니다. 그렇기에, 시각화에서 차원축소는 불가피하다고 볼 수 있습니다.
* 다른 고차원의 문제 (Overfitting) : 고차원, 즉, 너무많은 피쳐들은 다른 문제들도 야기하는데, 그 중 하나는 Overfitting입니다. Overfitting은 현재 가지고있는 학습용 데이터에 대해선 문제가 없는데 새로운 데이터에 대해선 문제를 일으키는것을 의미합니다. 예를들어, 옷 디자이너가 모델들 (학습용 데이터) 만을 상대로 스키니진을 만들어서 그 모델들에겐 그 스키니진이 잘 맞았고, 패션쇼도 성공적으로 끝냈지만, 그 후 그 스키니진을 양산했을때 실제 고객들 (새로운 데이터) 에게는 맞지않는 문제 발생.
---
## 고차원(피쳐가 많음)" 의 기준
정해진 기준이 있는 건 아니지만, 일반적으로 **feature의 수 >= sample의 수** 인 경우에 Overfitting문제가 일어날 수 있습니다.
**데이터가 고차원인지 알 수 있는 일반적인 기준**
* feature의 수 >= sample의 수 일 경우
* 최소 N = 5P 의 조건을 만족시키는게 좋다
* sample의 수는 많으면 많을 수록 좋습니다
* feature의 수는 무조건 많은 것이 좋지는 않습니다
---
## How to do it? **PCA (Principal Component Analysis)**
여기선 우리가 배웠던 PCA를 어떻게 쓰는지를 다뤄보겠습니다!
### **PCA steps**
(숫자형 데이터만 가능하니, 전처리를 통해 범주형 데이터는 제거하세요~)
1. 표준화(Standardizing)
* 변수별로 값의 스케일이 다르기 때문에, 유의미한 분산을 찾기위해 표준화를 통해서 데이터의 스케일을 같게 해준다. 이때 각 행에 대해서 평균을 빼고, 또 거기서 표준편차로 나누는 작업을 한다. 이로인해 데이터셋의 모든행은 평균 0, 표준편차 1을 가진다.
2. Z의 분산-공분산 매트릭스를 계산함
* 표준화의 결과로 나온 매트릭스를 Z라고 할때, 이것의 분산-공분산 매트릭스는 Z.T * Z을 이용해 구할 수 있다.
3. 분산-공분산 매트릭스의 고유벡터와 고유값을 계산함
* 위에서 구한 분산-공분산 매트릭스의 고윳값과 고유벡터를 구한다. 이때 나오는 고윳값과 고유벡터의 수는 데이터의 피쳐수와 같은데, 그 중 가장 높은 값에 해당하는 고유벡터는 가장 높은 분산을 가진다(PC1).
4. 구해진 고유 벡터에 1번에서 구한 Z의 데이터를 투영(Projection)시킨다.
* 결과로 나온값은 원래의 데이터를 최대한 보존하면서 차원을 줄인 결과이다.
```py
# 라이브러리
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
```
```py
# 우선 숫자형태의 데이터만 남김
df_nums = df.select_dtypes(include=['int64']).copy()
```
```py
# 1. 표준화
df_std = StandardScaler().fit_transform(df_nums)
```
```py
# 데이터가 mean = 0, standard deviation = 1 값을 가지는지 확인
print(df_std.mean().round())
print(df_std.std(ddof=1))
```
```py
# 2. 표준화된 데이터를 가지고 공분산 매트릭스 구하기
covariance_matrix = cov(df_std.T)
```
```py
# 3. 분산-공분산 매트릭스의 고유벡터와 고유값을 계산함
# PCA(2)를 사용해서 2차원으로 축소 (PC1과 PC2를 쓸것임) -> 이 결과로 2개의 pca.explained_variance_ (고윳값)과 2개의 pca.components_ (고유벡터) 를 구할 수 있다.
pca = PCA(2)
pca.fit(df_std)
```
```py
# 4. 구해진 고유 벡터에 1번에서 구한 Z의 데이터를 투영(Projection)시킨다.
projected = pca.transform(df_std)
```
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.