codestates / codestates/ds-blog
리그오브레전드 챔피언 데이터 K-means Clustering
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
# Introduction
K-means Clustering이란 무엇일까? 간단히 말하면 k개의 cluster를 구성하는 기준을 mean으로 해서 clustering을 한다는 뜻이다. 머신러닝의 비지도 학습 중의 하나이며, 이를 통해서 우리는 임의의 데이터 세트를 주어진 feature에 맞는 특성을 컴퓨터가 알아서 k개의 군집으로 분류할 수 있다. 가장 잘 알려진 방법중의 하나며, 다양하게 쓰일 수 있으니 확실히 알아보도록 하자. 나는 내가 좋아하는 게임 중의 하나인 League of Legend의 데이터 세트를 가지고 왔다. 간단하게 League of Legend에서는 여러 가지의 챔피언이 존재하며, 이 챔피언들의 특성으로 주 역할 군에 따라 나누었다.[나무 위키](https://namu.wiki/w/%EB%A6%AC%EA%B7%B8%20%EC%98%A4%EB%B8%8C%20%EB%A0%88%EC%A0%84%EB%93%9C/%EC%B1%94%ED%94%BC%EC%96%B8#s-4)에 따르면 역할 군은 다음과 같이 6개로 나뉘어진다.
1. 암살자(Slayer)
2. 전사(Fighter)
3. 마법사(Mage)
4. 원거리 딜러(Marksman)
5. 서포터(Controller)
6. 탱커(Tank)
우리도 챔피언의 특성을 담은 데이터 세트를 K-means Clustering을 하여 결과를 확인하고, 이를 비교해보자.
# Libraries
```py
import pickle # 리스트 안의 데이터프레임 형태 저장
import requests # api 요청
import json
import pandas as pd
import numpy as np
import matplotlib as mlp
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.decomposition import PCA
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler
%matplotlib inline
sns.set()
```
# Dataset
데이터셋트를 불러오는 과정은 [다음의 글](https://gist.github.com/Berkodev/a629dfe3b4f112c5f866eb01f916027e)을 참조하였다.
원문의 글에서 챔피언의 데이터를 불러와서 저장하는 방법을 그대로 사용하였다.
```py
api_key = 'Key' # Key를 갱신하여야 한다
r = requests.get('https://ddragon.leagueoflegends.com/api/versions.json') # version data 확인
current_version = r.json()[0] # 가장 최신 버전 확인
current_version
```
가장 최신의 patch 버전의 데이터 세트를 구하기 위해서, 가장 최신 버전을 확인한다. League of Legends에서는 patch 버전에 따라 챔피언의 특징을 조금씩 수정하는 경우가 있으므로, 버전을 다시 한 번 확인했다.
```py
r = requests.get('http://ddragon.leagueoflegends.com/cdn/{}/data/ko_KR/champion.json'.format(current_version))
parsed_data = r.json() # 파싱
info_df = pd.DataFrame(parsed_data)
info_df.head()
```
>
type | format | version | data
| -- | -- | -- | --
champion | standAloneComplex | 10.19.1 | {'version': '10.19.1', 'id': 'Aatrox', 'key': ...
champion | standAloneComplex | 10.19.1 | {'version': '10.19.1', 'id': 'Ahri', 'key': '1...
champion | standAloneComplex | 10.19.1 | {'version': '10.19.1', 'id': 'Akali', 'key': '...
champion | standAloneComplex | 10.19.1 | {'version': '10.19.1', 'id': 'Alistar', 'key':...
champion | standAloneComplex | 10.19.1 | {'version': '10.19.1', 'id': 'Amumu', 'key': '...
```py
champ_dic = {}
for i, champ in enumerate(info_df.data):
champ_dic[i] = pd.Series(champ)
```
data 부분에 모든 챔피언에 관한 정보가 있음을 확인하고, Dictionary 형태로 Series가 되도록 저장하였다.
```py
champ_df = pd.DataFrame(champ_dic).T
champ_df
```
>
version | id | key | name | title | blurb | info | image | tags | partype | stats
| -- | -- | -- | -- | -- | -- | -- | -- | -- | -- | --
10.19.1 | Aatrox | 266 | 아트록스 | 다르킨의 검 | 한때는 공허에 맞서 싸웠던 | {'attack': 8, 'defense': 4, 'magic': 3, 'diffi... | {'full': 'Aatrox.png', 'sprite': 'champion0.pn... | [Fighter, Tank] | 피의 샘 | {'hp': 580, 'hpperlevel': 90, 'mp': 0, 'mpperl...
10.19.1 | Ahri | 103 | 아리 | 구미호 | 룬테라가 가진 잠재력| {'attack': 3, 'defense': 4, 'magic': 8, 'diffi... | {'full': 'Ahri.png', 'sprite': 'champion0.png'... | [Mage, Assassin] | 마나 | {'hp': 526, 'hpperlevel': 92, 'mp': 418, 'mppe...
```py
champ_df = champ_df.drop(['version', 'image', 'info', 'stats','key', 'id', 'title', 'tags', 'partype','blurb'], axis=1)
```
다음으로 우리는 각 챔피언의 feature와 이름만 저장했다.
```py
# 6 cluster
kmeans = KMeans(n_clusters=6)
kmeans.fit(champ_df.iloc[:,1:])
champ_df['label'] = kmeans.labels_
plt.scatter(champ_df.hp, champ_df.hpperlevel, c=champ_df.label)
```
>
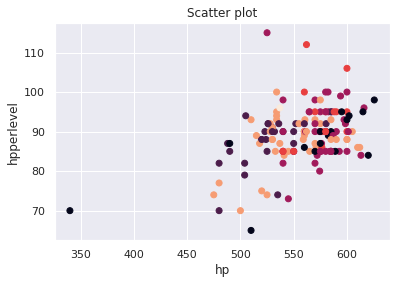
우리는 이미 6개의 역할 군으로 나눌 수 있음을 알고 있기 때문에, 6개를 지정하였지만 이 또한 나중에 테스트할 것이다. 위의 그래프는 챔피언의 hp vs hp-per-level을 scatter plot으로 그려보았다. feature가 다양하여서 2차원 그래프를 통해서 한눈에 알아보기는 힘들다.
```py
cluster_1 = champ_df.loc[champ_df.label == 1]
cluster_1.name[:5]
```
>7 아펠리오스
8 애쉬
9 아우렐리온 솔
11 바드
15 케이틀린
Name: name, dtype: object
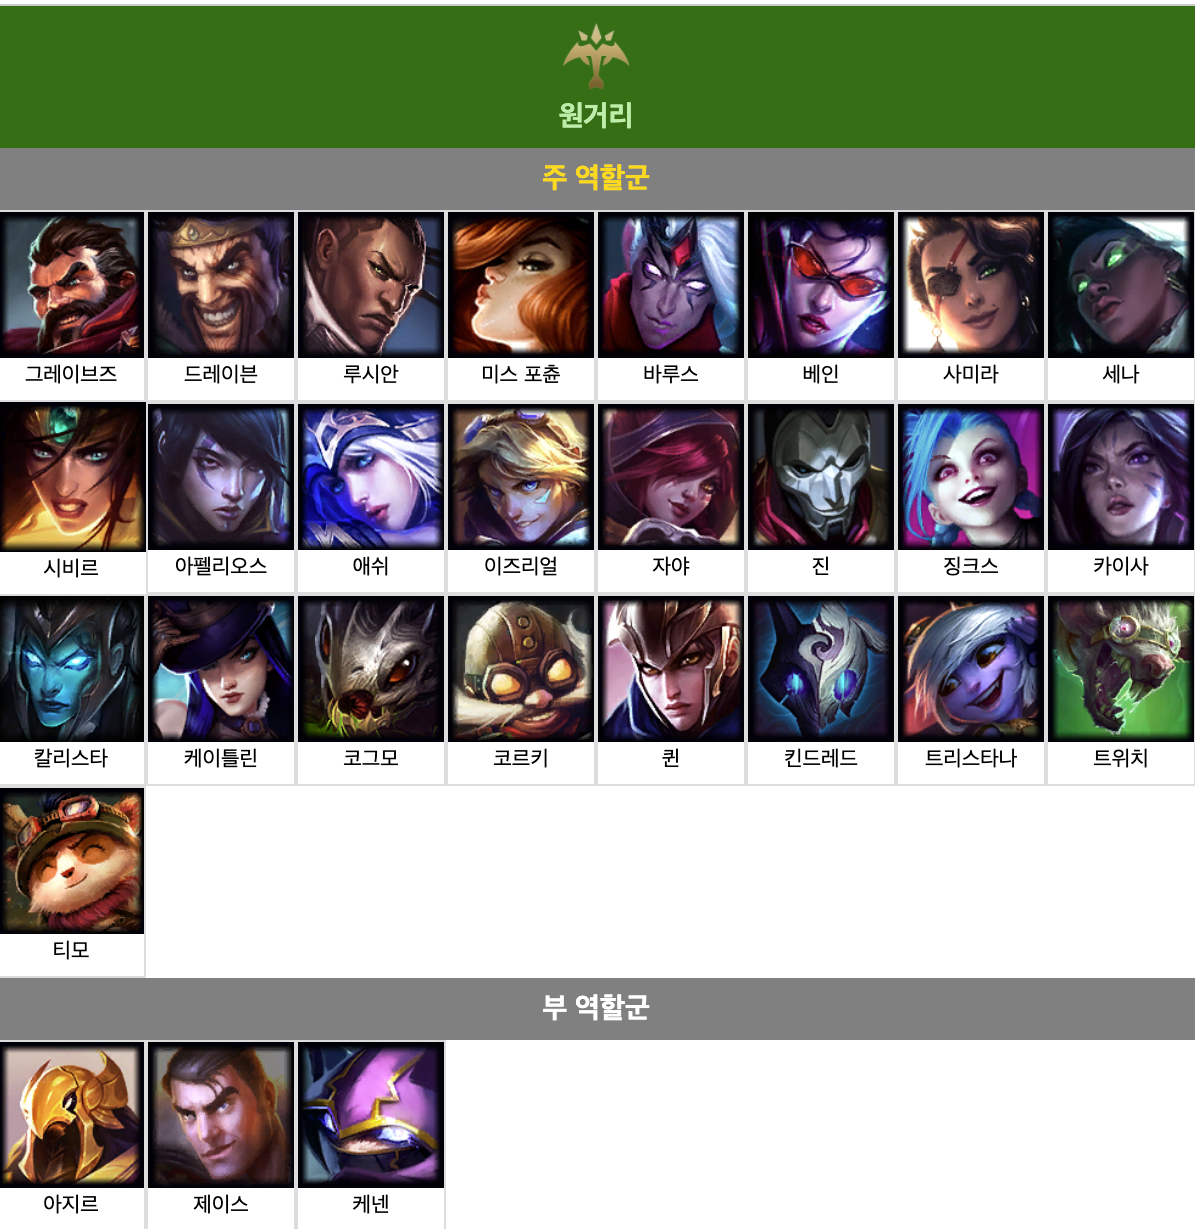
따라서 우리는 하나의 cluster를 선택해서 가장 유사한 주 역할 군과 비교를 해보기로 했다.
```py
marksman =['그레이브즈', '드레이븐', '루시안', '미스 포츈', '바루스', '베인', '사미라', '세나',
'시비르', '아펠리오스', '애쉬', '이즈리얼', '자야', '진', '징크스', '카이사', '칼리스타',
'케이틀린', '코그모', '코르키', '퀸', '킨드레드', '트리스타나', '트위치', '티모', '아지르',
'제이스', '케넨']
print('정확도 :', len(cluster_1.name.loc[cluster_1.name.isin(marksman)])/len(cluster_1.name))
```
>정확도 : 0.5555555555555556
우리는 주 역할 군중의 하나인 원거리 딜러와 비교를 했을 때, 우리가 얻은 결과의 정확도는 약 56%이다. 아직 정확도가 많이 약함을 알 수 있다. 여기서 말하는 정확도는 우리의 cluster에 근접하는 주 역할 군을 비교해서 전체 중에 몇 %가 근접하는 주 역할 군에 포함되어 있는가이다.
# PCA
앞의 활용에서 우리가 바로 K-means clustering을 하면 56%의 정확도를 가짐을 알 수 있었다. 정확도를 좀 더 높이기 위해 데이터 세트를 먼저 PCA를 적용한 후 다시 K-means clustering을 적용해볼 것이다.
```py
scaler = StandardScaler()
z = scaler.fit_transform(champ_df.iloc[:,1:])
pca = PCA(0.9)
pca.fit(z)
n = len(pca.explained_variance_ratio_)
res = pca.transform(z)
res_df = pd.DataFrame(data = res, columns = ['PC'+str(i) for i in range(1, n+1)])
res_df.head(2)
```
>
PC1 | PC2 | PC3 | PC4 | PC5 | PC6 | PC7 | PC8 | PC9 | PC10 | PC11 | PC12 | PC13 | PC14
| -- | -- | -- | -- | -- | -- | -- | -- | -- | -- | -- | -- | -- | --
3.607014 | 2.393501 | 1.379647 | -1.714294 | 1.253145 | -1.777460 | 0.111031 | -0.475678 | 1.605012 | -0.327711 | 1.227450 | 0.671031 | -0.515608 | -0.130215
-2.835966 | -1.191510 | 0.712272 | -0.495812 | -0.010395 | 0.084475 | -0.580608 | -0.231774 | 0.551636 | -1.272719 | -0.513723 | -0.013329 | -0.371699 | -0.684089
우리는 PCA를 통해서 차원을 축소하더라도, 90%의 데이터를 보존하도록 PCA를 설정 했으며, 결과적으로 총 14개의 PCA를 사용하였다.
```py
kmeans = KMeans(n_clusters=6)
kmeans.fit(res_df)
res_df['label'] = kmeans.labels_
plt.scatter(res_df.PC1, res_df.PC2, c=res_df.label)
plt.title('PCA')
plt.xlabel('PC1')
plt.ylabel('PC2')
```
>
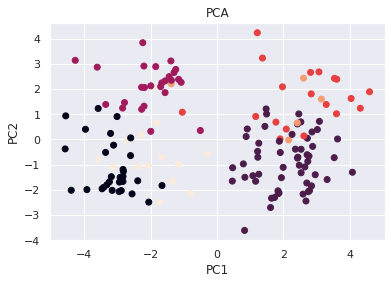
맨 처음의 scatter plot과 달리 좀 더 직관적인 결과를 그래프를 통해 확인 할 수 있었다.
```py
champ_df['label'] = kmeans.labels_
champ_df.name.loc[champ_df.label == 1]
```
>7 아펠리오스
8 애쉬
15 케이틀린
19 코르키
23 드레이븐
27 이즈리얼
45 제이스
46 진
47 징크스
48 카이사
49 칼리스타
58 킨드레드
60 코그모
66 루시안
73 미스 포츈
91 퀸
100 사미라
102 세나
109 시비르
120 티모
122 트리스타나
125 트위스티드 페이트
126 트위치
129 바루스
130 베인
138 자야
Name: name, dtype: object
다음은 PCA를 거친 데이터셋을 가지고 K-means clustering 한 label을 적용시켜 어떤 결과가 있는지 확인하였다.
```py
cluster_1 = champ_df.loc[champ_df.label == 1]
cluster_1.name
print('정확도 : ', len(cluster_1.name.loc[cluster_1.name.isin(answer)])/len(cluster_1.name))
```
> 정확도 : 0.9615384615384616
정확도가 96%로 상승함을 알 수 있었다. PCA를 하기 전과 엄청난 차이를 확인할 수 있다.
같은 방식으로 모든 역할 군에 대해서 정확도를 구하면 다음과 같다.
-- | 정확도
-- | --
원거리|0.961538
마법사|1.000000
탱커|0.589286
전사|0.894737
암살자|0.600000
서포터|0.466667
# Elbow Plot
```py
#Elbow plot
distortions = []
K = range(1,10)
for k in K:
kmeanModel = KMeans(n_clusters=k)
kmeanModel.fit(champ_df.iloc[:,1:])
distortions.append(kmeanModel.inertia_)
plt.figure(figsize=(16,8))
plt.plot(K, distortions, 'bx-')
plt.xlabel('k')
plt.ylabel('Distortion')
plt.title('The Elbow Method showing the optimal k')
plt.show()
```
>
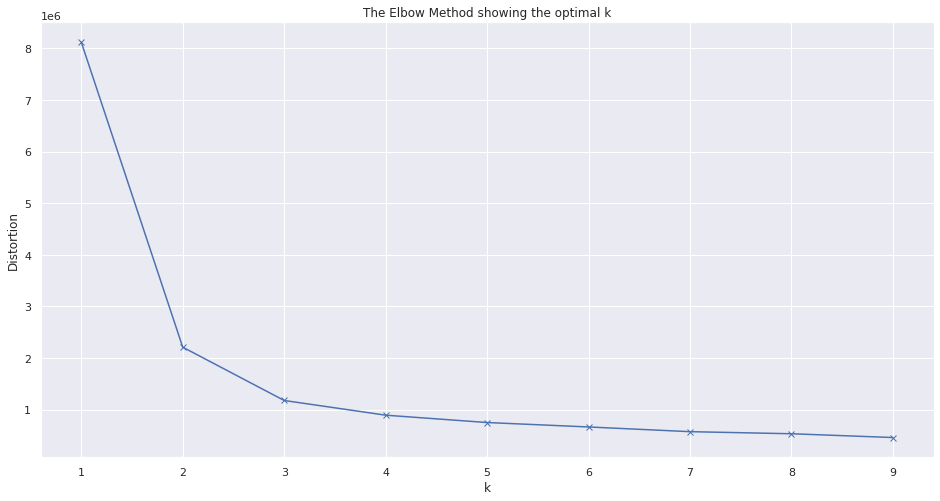
위의 그래프는 Elbow plot으로 K-means clustering을 적용할 때 k를 몇개로 정해야하는가에 대한 insight를 준다. 그래프를 보면, 3개의 cluster를 통해서도 충분히 의미있는 결과를 도출할 수 있음을 알 수있다. 만약 K-means clustering을 통해 League of Legend의 챔피언을 분류를 했다면 3개가 적당했을 수도 있다. 하지만, 위의 정확도를 통해서 League of Legend의 챔피언은 좀 더 세밀하게 분류가 되었고 6개로 분류했다.
# Conclusion
지금까지 League of Legends 챔피언의 feature를 가지고 K-means Clustering을 활용하여, 역할 군에 따라 분류해보았다. 여기서 중요하게 볼 수 있는 점은, PCA의 여부이다. PCA를 하기 전에는, 60%도 안 되는 정확도를 하고 있었지만, PCA를 통해서 그 정확도를 약 97%까지 올림을 확인할 수 있었다. 게다가 몇몇 역할 군에대해서는 특히, 원거리와 마법사 부분에서는 엄청나게 정확한 결과를 확인할 수 있었다.
반면에, K-means clustering을 통해서 다른 군집들은 안 좋은 결과를 나타냄을 알 수 있다. 이의 가장 큰 원인은, K-means clustering은 하나의 챔피언은 무조건 하나의 군집에 속해야 한다. [나무 위키](https://namu.wiki/w/%EB%A6%AC%EA%B7%B8%20%EC%98%A4%EB%B8%8C%20%EB%A0%88%EC%A0%84%EB%93%9C/%EC%B1%94%ED%94%BC%EC%96%B8#s-4) 에서는, 하나의 챔피언이 여러 역할 군에 속하는 것을 확인할 수 있다. 따라서 K-means clustering을 통해서는 정확하게 clustering을 할 수가 없다. 대안으로는, Fuzzy clustering을 활용할 수 있다. Fuzzy clustering은 K-means clustering과는 다르게 하나의 데이터 포인트가 여러 군집에 속할 수 있다.
다음으로, 몇몇 챔피언들은 어느 역할 군에도 속하지 않는 챔피언도 있어 K-means clustering을 통해서 이를 처리할 수가 없다. 대안으로는, Density-based Spatial Clustering of Applications with Noise (DBSCAN) 방법이 있다. 이 clustering 방법은 몇몇 의미 없는 포인트를 배제하고 clustering을 진행한다. 마지막으로, 우리가 흔히 지나칠 수 있는 부분에서도 당연하게 여기는곳에서도 머신들은 우리의 편의를 위해서 많은 작업들을 배워 우리에게 보여준다. 내가 만약 챔피언을 설계를 한다고하면, 이미 가지고 있는 이 역할 군에 맞춰서 챔피언을 설계를 하면 너무 이미 정해진 비슷한 챔피언들만 설계될 것이고, 벗어나는 설계를 하자니 너무 다른 캐릭터를 설계해 게임의 플레이에 지장이 생길 수도 있고 어렵다. 하지만, 이 데이터들을 통해서 앞으로 이 고민들에 대한 해답을 제시할 수 있지 않을까 생각한다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.