codestates / codestates/ds-blog
[김지연] clustering으로 갓겜 찾아보기 실패 후기
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
당신이 메타크리틱 스코어에 집착하는 게이머라면 그리고 할 게임이 없다면 한 번쯤은 비평가 점수와 유저 점수가 모두 높은 게임을 모아서 보고 싶다는 생각을 했을 수 있다.(나는 종종 한다) 하지만 아쉽게도 메타크리틱 홈페이지에선 비평가 점수인 metascore와 유저 점수인 user score 순위를 각각 보여줘서 두 점수를 합친 그런 순위는 (내가 알기론) 찾을 수 없다. 그래서 결심했다. 이번 주에 배운 clustering을 이용해 metascore와 user score가 모두 높은 그런 게임들을 모아보기로 말이다.(이 아이디어는 김진환 코치님의 lol 챔피언 클러스터링에서 얻었습니다.)
캐글에서 비디오게임 평점이 포함된 데이터를 검색하다 KendallGillies라는 아이디의 멋진 유저가 올려놓은 [Video Game Sales and Ratings](https://www.kaggle.com/kendallgillies/video-game-sales-and-ratings) 데이터를 발견했다. 마침 이 데이터는 메타크리틱의 두 점수가 포함되어 있는 비교적 최신인 2017년의 1월 데이터였다. 2017년 1월 이후로 수많은 재밌는 게임들이 출시했지만 2017년 이후의 기억은 비교적 선명하여 우리는 그 이후의 갓겜들을 줄줄 말할 수 있으니 굳이 2020년의 최신 데이터를 찾아 고생을 하지 않기로 했다.
그래서 내가 유일하게 할 줄 아는 언어인 python으로 이 데이터의 클러스터링을 해보았다. 그리고 수많은 난관과 에러메세지를 거쳐 이 글을 쓸 수 있게 되었다. 그렇다고 내가 클러스터링에 성공한 것은 아니기 때문에 이 글이 좋은 가이드는 되지 못 할 것 같고 반면교사는 될 수 있을 것 같다.
데이터 전처리를 하지 않은 데이터프레임의 모습은 아래와 같다.
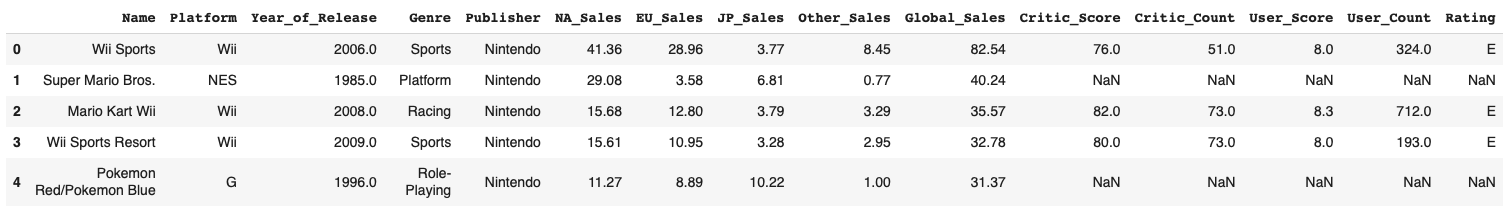
우리가 필요한 데이터는 Critic_Score와 User_Score로 이 두 컬럼과 Name 컬럼을 사용해 Global Sales가 1 이상인 게임만을 선택하여 새로운 데이터 프레임을 만들었다. 이 과정에서 스코어 값이 NaN인 게임들은 빠졌고 df_subset.isnull().sum() 을 이용해 NaN 값이 더 있는지 확인했다.
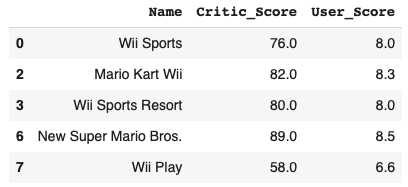
이 데이터 프레임을 바탕으로 평균이 0과 표준편차가 1이 되도록 변환해주는 StandardScaler()를 사용하였다.
```
scaled_features = df_subset.copy()
col_names = ['Critic_Score', 'User_Score']
features = scaled_features[col_names]
scaler = StandardScaler().fit(features.values)
features = scaler.transform(features.values)
# fit, transform 메소드는 fit_transform 하나로도 사용하여 객체 내 저장과 변환을 함께 할 수 있다.
scaled_features[col_names] = features
# 클러스터는 네 개로 하였다. (유저 고/저평가 & 비평가 고/저평가군)
kmeans = KMeans(init="random",n_clusters=4)
k = kmeans.fit(features)
y_kmeans = kmeans.predict(features)
clusters = pd.DataFrame(k.predict(features))
clusters.columns=['clusters']
scaled_df = pd.concat([scaled_features, clusters], axis=1)
scaled_df = scaled_df.dropna()
import seaborn as sns
# seaborn scatter plot으로 네 클러스터를 시각화
plt.figure(figsize=(15, 15))
plt.scatter(features[:, 0], features[:, 1], c=y_kmeans, s=50, cmap='viridis')
centers = kmeans.cluster_centers_
plt.scatter(centers[:, 0], centers[:, 1], c='black', s=200, alpha=0.5);
```
이러한 코드를 통한 결과물은 아래와 같다.
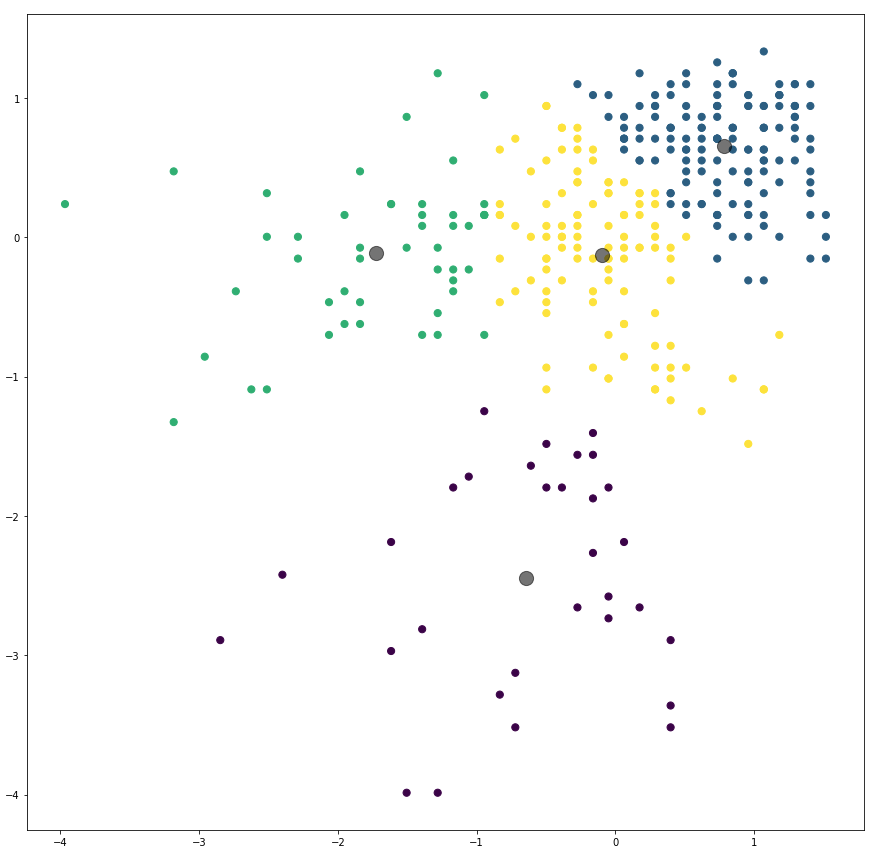
여기까지 시각화를 잘 한 것 같다. 하지만 치명적인 문제로는 각 점들이 어떠한 게임을 나타내는지 라벨링을 하지 못해서 어떤 게임이 '갓겜'인지 알 수 없다는 것이다. 라벨링에 실패한 이유로는 게임 타이틀이 들어간 데이터프레임을 kmeans에 사용하면 string 값으로 인해 에러 메세지를 띄운다. 그리고 아직 해결 방법을 찾지 못해 갓겜을 찾는 여정은 계속될 예정이다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.