codestates / codestates/ds-blog
[오예은] 베이지안 통계 훑어보기
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
[Medium에서 보기](https://medium.com/@dsdoris/%EB%B2%A0%EC%9D%B4%EC%A7%80%EC%95%88-%ED%86%B5%EA%B3%84-%ED%9B%91%EC%96%B4%EB%B3%B4%EA%B8%B0-6d23ad98ab83)
---
오늘은 하늘도 높고 바람도 솔솔 부니 가을을 맞이하여 가을 하면 떠오르는 색깔, 베이지 안으로 빠져보겠다!
이미지출처 http://blog.naver.com/cbh3cbh3
---
## 베이지안(베이즈 추론)이란?
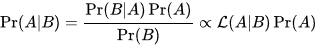
베이즈 정리 공식
**베이즈 추론(Bayesian inference)**은 통계적 추론의 한 방법으로,
추론 대상의 사전 확률과 추가적인 정보를 통해 해당 대상의 사후 확률을 추론하는 방법이다.
베이즈 추론은 베이즈 확률론을 기반으로 하며, 이는 추론하는 대상을 확률변수로 보아
그 변수의 확률분포를 추정하는 것을 의미한다. (위키백과)
>`여기서 잠깐! 단어가 너무 어려우니 잠깐 설명을 보자.
>(본문은 개념을 짚기 위한 목적으로 공식 유도 과정은 생략한다.)`
>
>사전확률(H): 설계자가 알고 합리적으로 추정하고 있는 확률을 의미한다.
>
>사후확률(H|E): 사전 확률이 어떤 조건 하에서 일어날 수 있는 가능성
>(계산을 통해 '사후적으로' 알 수 있다는 의미)
즉, 정리해보자면 H라는 일이 일어날 확률을 아는 상태에서
다른 어떤 조건/상황(E)이 일어났을 경우에 H라는 일이 일어날 가능성을 구하는 것이다.
여기에서 계산된 사후확률을 가지고 다시 어떤 조건(E) 하에서 일어날 수 있는 가능성을 구하는 과정을 거듭하다 보면
어떤 조건(E)이 일어났을 때 어떤 일(H)이 일어났을 것이라는 확률을 높일 수 있다.
## '베이즈 정리'가 생겨나게 된 배경
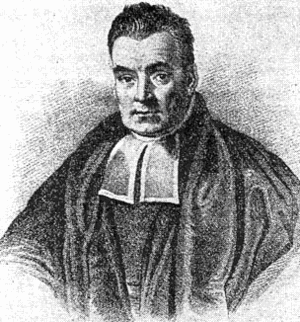 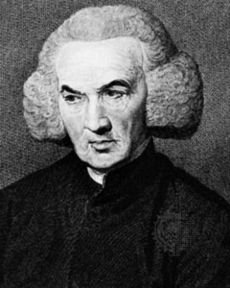 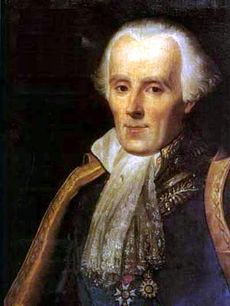
베이즈 정리를 확립시킨 인물: 왼쪽부터 토머스 베이즈, 리처드 프라이스, 피에르시몽 라플라스
베이즈 정리는 영국의 목사 토머스 베이즈에 의해 처음 주장되었다.
당시 유럽사회에서는 신본주의가 일반적이었으나 신본주의에서 인본주의로 전환하려는 움직임으로 경험주의가 생겨났다.
베이즈는 이러한 상황에 반기를 들고, 주어진 자료를 통해 믿음의 범위를 점차 조정할 수 있다는 '역확률'의 개념을 제안했다고
한다. 추후 리처드 프라이스와 피에르시몽 라플라스가 이를 발전시켜서 현재의 베이즈 정리로 사용되게 되었다.
## 빈도주의 vs. 베이지안 주의
베이지안주의는 기존의 통계학과는 확률을 바라보는 관점 자체가 다르다.
기존의 학문을 '빈도' ,즉 사실에 기반한 엄격한 확률을 예측하는 학문이라고 한다면,
베이지안주의는 '경험', 즉 불확실성에 기반한 신뢰도를 추론하는 학문이라 할 수 있다.
앞서 언급했던 베이지안 추론이 생겨난 과정에서도 추측할 수 있듯이 처음에 베이즈 정리가 생길 때부터
'확률'이라는 개념을 '어떤 일에 대한 믿음'으로 보기 때문에 이 관점에서는 데이터(자료)가 추가될 때 마다
확률(주장,믿음)이 계속 변화하며 진실에 가까워진다고 본다.
그래서 '확률'을 많은 시도 후의 사건의 상대적 빈도의 극한으로 보는 빈도주의자와 많이 비교 된다.
### 베이지안 추론이 주목받는 이유
베이지안 추론법은 오랜 시간 통계학의 전통 빈도주의에 많이 밀려있었다.
하지만 컴퓨팅 환경이 좋아지고 빅데이터의 시대가 도래하면서
데이터(자료)가 많을 수록 신뢰도가 높아지는 베이지안 이론의 장점이 머신러닝, 인공지능 등의 분야에 활용되었고,
앞으로도 이러한 환경적인 발달에 힘입어 데이터 기반의 통계 모델이 필요한 분야에 널리 적용될 것으로 보인다.
## 베이지안 추론의 적용
베이지안 추론은 여러 분야에 이용될 수 있다.
머신러닝을 적용한 음성인식 기술, 사진(인물, 물체) 인식, 부동산 예측 모델, 약품 개발/테스트 및 병에 대한 진단 등
데이터가 존재하는 곳이라면 어디든 우리 생활 속 곳곳에서 활용될 수 있을 것이다.
위의 사례처럼 음성인식, 이미지 인식과 같은 머신러닝에서는 복잡한 모델링을 거치겠지만
이번엔 간단하게 파이썬으로 베이지안 추론을 음주운전 검사에 적용해보자.
1. 우리가 경찰관이 되어 지금 길에서 음주운전 검사를 하고 있다고 하자. 우리에게 주어진 임무는 음주운전을 해서 테스트 결과가 양성인 사람을 걸러내는 것이다. (100번 검사했을 때 95번은 결과를 신뢰할 수 있도록!)
2. 이를 위해서 필요한 조건에 대해 아래의 확률을 적용할 예정이다.
> prob_drunk_prior: 음주운전했을 확률 = 0.001
> false_positive_rate: 음주운전하지 않았지만 테스트 양성 = 0.08
> true_positive_rate: 음주운전하여 테스트 양성 = 0.97
> result: 실제로 음주를 하여 음주운전 테스트에서 양성이 나올 확률
3. 베이지안 공식을 함수로 코딩해보았다.
``` py
def prob_drunk_given_positive(prob_drunk_prior, false_positive_rate, true_positive_rate):
# 음주운전할 확률 * 음주운전했을 때 양성일 확률
numerator = prob_drunk_prior * true_positive_rate
# 음주 테스트 결과가 양성일 확률 (음주를 했을 때 양성일 확률 + 음주를 안했을 때 양성일 확률)
denominator = (prob_drunk_prior*true_positive_rate) + ((1-prob_drunk_prior) * false_positive_rate)
result = numerator / denominator
return result
```
4. 위의 함수(공식)를 적용하여 1~5회 테스트를 했을 때 음주운전 한 사람의 결과가 양성일 확률을 구하면 다음과 같다.
``` py
# 한번의 음주 테스트에서 양성이 나온 경우 실제로 음주를 했을 확률
result1 = prob_drunk_given_positive(0.001, 0.08, 0.97)
print("테스트 1회:", result1)
# 두번의 음주 테스트에서 양성이 나온 경우 실제로 음주를 했을 확률
result2 = prob_drunk_given_positive(result1, 0.08, 0.97)
print("테스트 2회:", result2)
# 세번의 음주 테스트에서 양성이 나온 경우 실제로 음주를 했을 확률
result3 = prob_drunk_given_positive(result2, 0.08, 0.97)
print("테스트 3회:", result3)
result4 = prob_drunk_given_positive(result3, 0.08, 0.97)
print("테스트 4회:", result4)
result5 = prob_drunk_given_positive(result4, 0.08, 0.97)
print("테스트 5회:", result5)
```
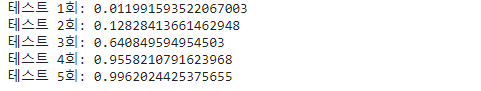
5. 위의 코드를 실행한 결과를 보면 음주운전 검사를 한 번 했을 때 진짜 술을 마신 사람이 양성이 나올 확률은 1% 남짓이다. 그러나 여러번 검사를 할 수록 그 확률이 높아진다는 것을 알 수 있다.
6. 따라서, 우리가 임무를 받은 대로 95%의 신뢰도(정확성)을 가지고 술을 마시고 음주운전 한 사람을 잡으려면 테스트를 적어도 4회 이상은 실시해야한다. (오메 피곤한것~~ 민원들어오면 우짠댜…)
이렇게 베이지안 정리가 실 생활에서 충분히 적용될 수 있다는 것을 확인했다. '통계'라는 학문이 공식과 숫자들로 꽉꽉 채워져있어 어렵고 딱딱하다고 느껴지지만 우리가 '감(feeling)'으로만 해결할 수 없는 것들을 효율적으로 해결해주니 우리 삶에서 필요하다는 것은 부정할 수 없는 일이다.
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.