codestates / codestates/ds-blog
[윤형준] Population Distribution vs. Sampling Distribution
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
안녕하세요 여러분^^
오늘은 통계에 대해서 알아보려고 해요.
통계에는 여러 비슷한 용어가 많고 복잡하여 헷갈리는 경우가 많은데요, 오늘 그것을 한번 정리해보려고 합니다.
자! 우선, 모집단에서의 평균과 분산은 우리가 알수 없습니다.
따라서 우리는 표본을 추출해서 그 모집단의 평균과 분산을 추측하는 것이죠.
****
모집단의 분포를 뜻합니다. 우리는 모집단의 분포가 어떻게 생겼는지 알 수 없습니다. 하지만 가상의 모집단을 한번 만들어 보겠습니다.
모집단 분포를 생성하고 시각화하는 코드를 보려면 여기를 눌러주세요
```py
import pandas as pd
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as ss
import random
# population distribution
mu_1, mu_2 = 100, 110
sigma_1, sigma_2 = 2, 10
size_1, size_2 = 10000, 20000
norm_dist_1 = np.random.normal(mu_1, sigma_1, size_1).tolist()
norm_dist_2 = np.random.normal(mu_2, sigma_2, size_2).tolist()
pop_dist = norm_dist_1 + norm_dist_2
# population distribution visualization
plt.hist(pop_dist, bins=200)
plt.title("Population Distribution")
plt.xlabel('x')
plt.ylabel('Frequency')
plt.vlines(np.mean(pop_dist),0,1000, colors='red', linestyles='solid')
plt.show()
```
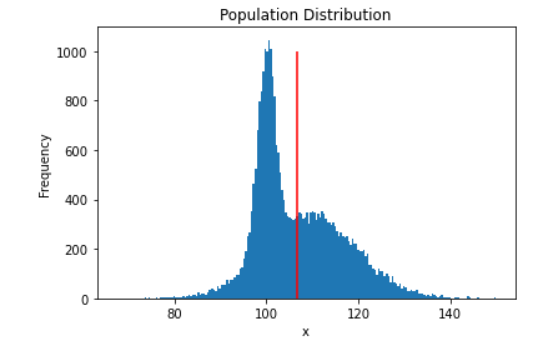
****
그렇다면 sampling Distribution이란 무엇일까요? 이 분포 또한 가상의 분포입니다. Sampling Distribution은 특정 사이즈의 sample을 무한대로 sampling (표본추출) 하여 각 sample의 평균값을 분포로 나타낸 것입니다. 이 분포가 가상인 이유는 실제로 모집단으로 부터 sampling을 무한대로 하는 것이 불가능 하기 때문입니다.
****
만약에 sampling을 무한대로 할 수 있다고 가정해 봅시다. 그렇다면, 여러분들은 sampling distribution이 어떻게 생겼을 것이라고 생각하시나요? 답은 central limit theorem에 있습니다.
Central Limit Theorem에 의하면, sample size가 커질 수록 sampling distribution은 normal(정규분포) 해진다고 합니다. 이것을 시각화를 통해 확인을 해 봅시다. (컴퓨터에서도 sampling은 무한대로 할 수 없기 때문에, 10000번만 sampling을 하였습니다.)
Sampling Distribution을 생성하고 시각화하는 코드를 보려면 여기를 눌러주세요
```py
mean_set_2 = []
mean_set_500 = []
for i in range(10000):
mean_set_2.append(np.mean(random.sample(pop_dist, 2)))
mean_set_500.append(np.mean(random.sample(pop_dist, 500)))
f, (ax1, ax2) = plt.subplots(1, 2, figsize = (15,5), sharey=True)
ax1.hist(mean_set_2, bins=100)
ax2.hist(mean_set_500, bins=100)
ax1.set_title('Sampling Distribution of X_bar \n with sample size 2')
ax1.set_xlabel('x_bar', fontsize = 15)
ax1.set_ylabel('Frequency', fontsize = 15)
ax2.set_title('Sampling Distribution of X_bar \n with sample size 500')
ax2.set_xlabel('x_bar', fontsize = 15)
plt.show()
```
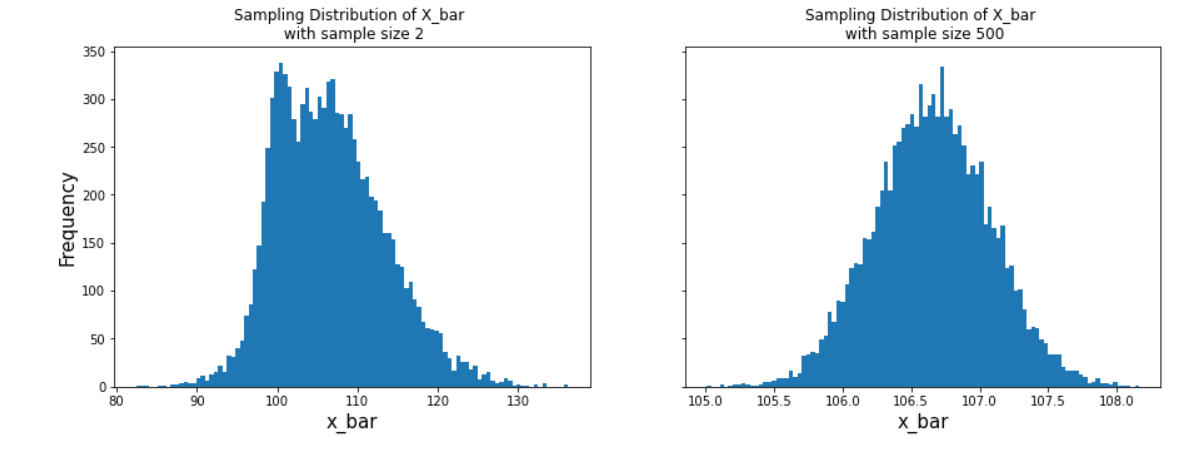
위의 그림에서, 왼쪽 그림은 sample size를 2로 두고 (이론상)무한대로 sampling을 하여, sample의 mean들의 분포를 시각화 한것이고, 오른쪽은 같은 condition으로 sample size를 500으로 둔것입니다. 보면 sample size가 클수록 sampling distribution이 더 normal distribution에 가까운것을 알 수있습니다.
****
자! 그렇다면 Sampling Distribution은 우리가 왜 만들어 본걸까요? Sampling Distribution은 앞서 말했듯이 가상의 분포입니다. 하지만 이것이 중요한 이유가 있습니다. 우리가 모집단 (population)의 평균을 알고자 할 때 하나의 표본(sample)을 추출하여, 평균을 구하고, 그것이 population의 평균을 대변하는 것이기 때문에 statistic이라고 합니다. 하지만 우리가 구한 sample mean(표본평균)이 얼마나 정확할지는 모르는 일이죠! 이 부분은 우리가 절대 알 수 없는 부분입니다. 다만 우리가 할수있는 일은, 모집단 평균이 어느정도이다 라는 가설을 설정하고 그 가설을 testing정도까지 밖에 못하는 제한사항이 있습니다.
이렇게 우리가 우선적으로 모집단 평균이 어느정도이다 라고 가설을 설정하고, 그 가설을 우리가 추출한 표본평균을 사용하여 testing을 하게 되는데, 여기서 사용되는 test는 t-test라고 합니다. 여기서 사용되는 것이 t-distribution인데,
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.