codestates / codestates/ds-blog
EDA가 헷갈리는 나에게
- Dominant language
- No language data
- Stars
- 2
- Forks
- 4
- PR merge metrics
- No merged PRs in 30d
Description
# EDA(Exploratary Data Analysis)는 뭘까?
데이터에 대해 공부하고 알아가면서 EDA라는 얘기를 종종 보게된다.
처음엔 EDA가 뭐야? 라고 생각했고 Exploratary Data Analisys의 약자로 EDA라는걸 알았을 때도, 우리 말로 '탐색적 데이터 분석'이라는걸 확인했을 때도 개념이 정확하게 잡히지 않았다.
새로운 분야와 지식에 대해 알아가고 공부할 때 한 번에 이해하고 알아갈 수 없는게 당연하다고 대신에 포기하지 말고 계속 자극을 주란다. 뉴런이 터지도록 해서 안되는 건 없다고 말이다.
매우 공감한다. 보고 들을 때마다 옳지! 싶지 않길래 계속 찾아보고 생각하고 실제로 EDA 과정을 조금씩 해나가며 체득해나가고 있다. EDA에 관해 글을 쓰는 이유도 한 번 더 새기기 위함이다.
서론이 길었다.
탐색적 데이터 분석이 뭔지 탐색해보자는 말이다.
이제 알아보자!
## 1. EDA ?
미국의 저명한 통계학자인 John W.Tukey가 EDA를 처음 소개했다.
이는 어떤 현상에 대해 데이터가 무엇을 알려줄 수 있는지 알아내기 위한 데이터 분석의 철학이다.
통계적 가설 검정, 신뢰 구간, 추정 등에 주로 관련된 데이터 분석 영역인 CDA(Confirmatory Data Analysis)와 대조되는 개념이다.
## 2. 왜 해야하나
| |1|2|3|4|5|6|7|8|9|10|11|12|
|-|-|-|-|-|-|-|-|-|-|-|-|-|
|매 출|34|26|56|10|35|10|76|93|13|26|34|63|
연구비|39|65|99|25|34|19|24|85|43|96|12|34|
디지털마케팅|5|26|60|23|55|1|25|7|8|4|6|21|
*이 데이터를 보자.
데이터가 무얼 의미하고 말하는지 쉽게 파악할 수 있을까?*
EDA를 하는 목적은 '탐색'하면서 데이터를 이해함으로써 데이터의 특징과 구조적인 면을 파악하기 위함이다.
## 3. 어떻게 하는가
- 데이터가 어떤 자료를 가지고 있는지 확인
- 데이터에 이상이 없는지 확인
- 구성요소와 특징 확인
- 데이터 크기 확인
아래 샘플 데이터로 기본적인 EDA를 해보도록 하자.
```py
# python으로 진행
# 라이브러리 불러오기
import pandas as pd
import seaborn as sns
# 예시로 사용할 샘플 데이터셋 'iris' 불러와서 변수에 담기
df = sns.load_dataset('iris')
# 데이터 크기를 확인
df.shape
```
`(150,5)`
이 데이터는 행이 150개, 열이 5개임을 알 수 있다.
```py
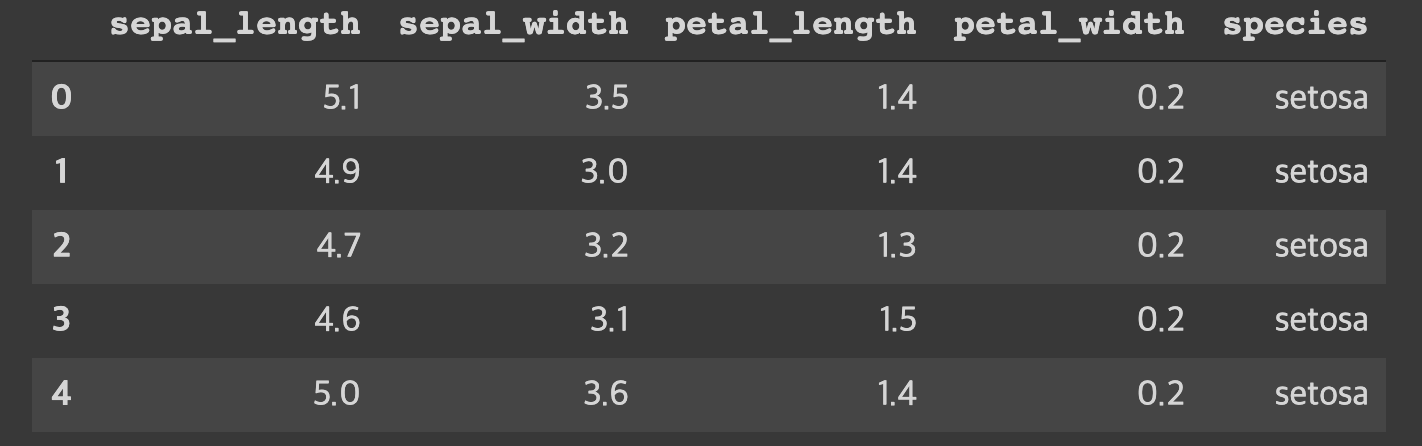
# .head()와 .tail()을 사용해서 문제가 없는지 확인 가능
# 또 데이터에 어떤 feature들이 있는지 확인 가능
df.head()
```
```py
df.tail()
```
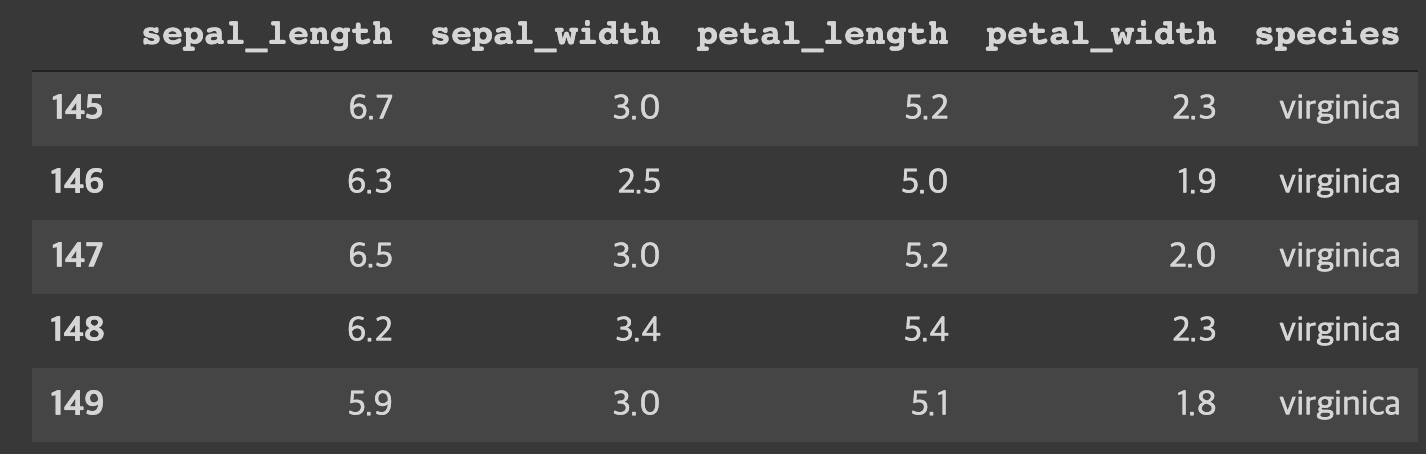
- iris 데이터 셋을 불러와서 보니 iris는 붓꽃이고 그에 대한 자료임을 알 수 있다.
- 각 열에 담겨 있는 feature들을 보니 이 데이터는 아래 정보를 가지고 있다.
* 꽃 받침 조각 너비와 길이
* 꽃잎 너비와 길이
* 붓꽃 종류
feature들을 보고 어떤 새로운 데이터를 만들 수 있을지 고민할 수 있고 데이터가 말하는 바에 대해 많은 아이디어를 낼 수도 있다.
- 처음, 끝 5줄씩 확인을 해보니 크게 문제가 없다.
```py
# 데이터에 결측값이 있는지 확인
## 결측값은 Na, Null, NaN를 말하는데 셋 모두 값이 없거나 미정값을 의미한다.
## 결측값이 있다면 어떻게 처리하느냐에 따라 이후 모델링이나 분석하는데 영향을 미치기 때문에 처음에 결측값이 있는지 먼저 확인하는게 좋다.
df.isna().sum()
```
```
sepal_length 0
sepal_width 0
petal_length 0
petal_width 0
species 0
dtype: int64
```
샘플 데이터라 그런지 결측값은 모두 없는 것으로 확인된다.
```py
# 데이터 값의 정보를 확인
df.describe(include = 'all')
```
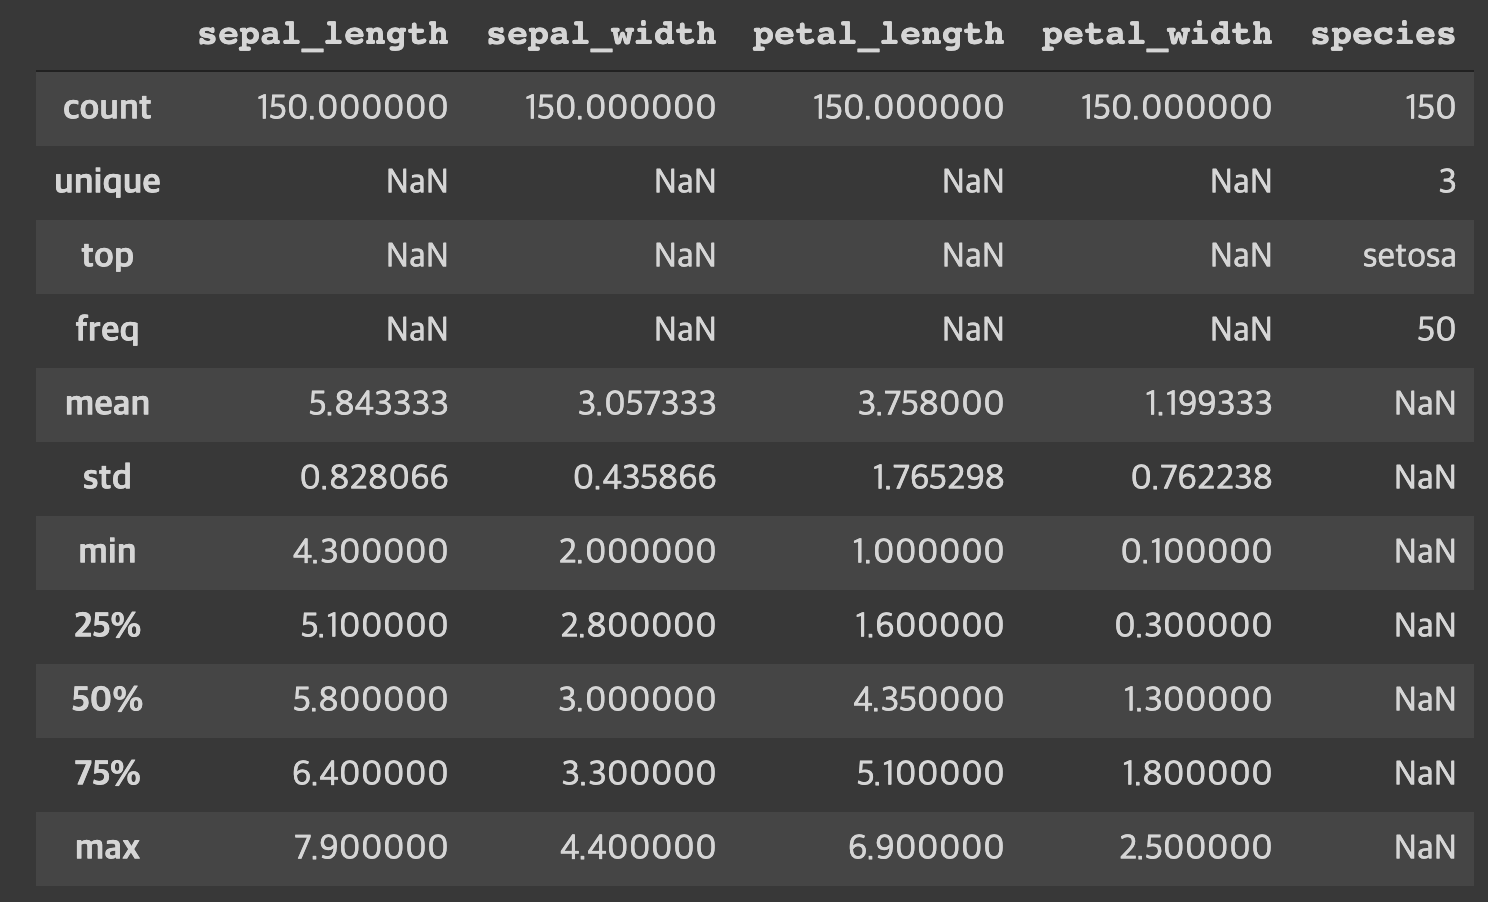
각 feature별로 요약 정보를 확인했다.
여기서 알 수 있는 내용은
* 길이와 너비의 평균, 중위값, 길이가 어디에 분포하는지 대략 알 수 있다.
* 붓꽃의 종류는 3가지다.
## 4. EDA 주제
EDA는 다음 4가지 주제를 가지고 있다.
* Resistance : 저항성
* Residual : 잔차
* Re-expression : 재표현
* Visualization : 시각화
### Resistance
저항성은 데이터에서 이상치로 인해 데이터에 변화가 발생해서 기존 가정에서 벗어나는데 얼마나 민감한지와 관련이 있다.
```py
# 2개 리스트를 생성
df = pd.DataFrame({'a' : [1,2,3,4,5,6,7,8,9,10],
'b' : [1,2,3,4,5,6,7,8,9,150]})
print(df.a.mean()) # 평균 구하기
print(df.a.median()) # 중위값 구하기
print('---')
print(df.b.mean())
print(df.b.median())
```
```
5.5
5.5
---
19.5
5.5
```
a는 데이터가 균일하고 따라서 평균과 중위값이 모두 같다.
b는 150이라는 숫자가 유일하게 하나 있는데, 이 때문에 평균값이 19.5이 되었다.
따라서 중위값은 저항적이라고 볼 수 있다.
### Residual
잔차는 다음 기회에..
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.