codestates / codestates/ds-TIL
[TIL]윤현태 201015
- Dominant language
- No language data
- Stars
- 2
- Forks
- 1
- PR merge metrics
- No merged PRs in 30d
Description
점점 가면 머리가 아파오는 것 같다. 분명 예전에 대학교에서 수업 들었을 때는 쉬워보였는데... 막상 데이터에 실제로 적용하려고 보니 기쁨보다는 걱정이 앞서는 거 같다. 내가 제대로 하고 있는게 맞나? 그나마 다행인 것은 채점을 통해서 내가 올바로 나아가고 있는지 아닌지 정도는 알 수 있다는 것이다.
오늘 배운 Logistic 회귀는 숫자형,연속형 데이터에 대한 회귀분석이 아니라 범주형 데이터에 대한 분석이 용이한데, 그 이유는 함수값에 따라서 0일 확률, 1일 확률을 정확하게 나타내주기 때문이다.
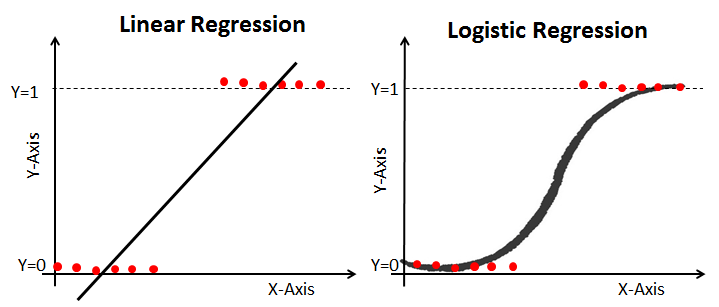
그래서 Linear regression에서 어떤 범주에 속하는지 쉽게 판별하지 못하는데, Logistic regression을 사용하면 바로 알 수 있다는 점이다. 그럼에도 불구하고 log를 취하면 Linear regression의 형태를 띄어서 언뜻보면 복잡해보이지만 의외로 분석하기가 어렵지는 않다.
그러나 일단 함수 자체가 비선형이고, 변수들이 지수 부분에 들어가 있기 때문에, 일반적 인 R^2 같은 걸로 하기 보다는
accuracy_score을 확인하는데, 이것은 다음과 같은 표를 이용해 알 수 있다.
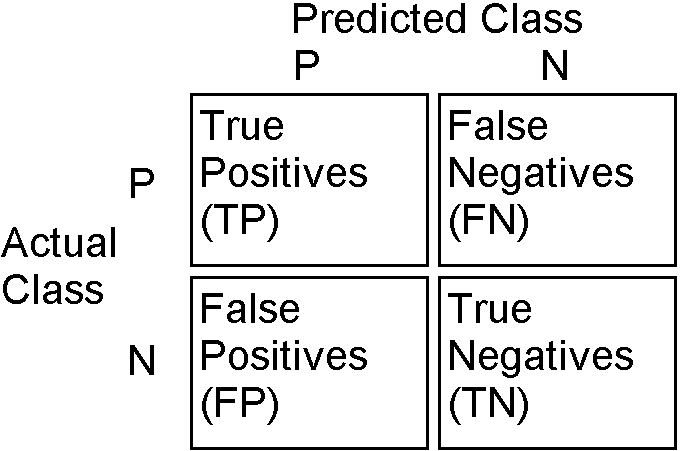
정확성, 즉 True positive와 True Negative를 얼마나 뽑아냈느냐가 관건인데,
이것은 TP+TN/Total 로 볼 수 있다. 전체 데이터중에 얼마나 제대로 맞췄는지를 보는 것이다.
물론 이것은 Logistic regression의 정확도를 나타내는 하나의 지표일 뿐이다.
데이터를 모델링 하기전에는 반드시 스케일링 과정을 거쳐야 하는데, 자료의 오버 플로우나 언더 플로우를 방지하고, 독립 변수의 공분산 행렬의 condition number을 감소시켜 최적화 과정에서의 안정성 및 수렴 속도를 향상 시키기 때문이다. 스케일링 종류는 다음과 같다.
1 StandardScaler 기본 스케일. 평균과 표준편차 사용
2 MinMaxScaler 최대/최소값이 각각 1, 0이 되도록 스케일링
3 MaxAbsScaler 최대절대값과 0이 각각 1, 0이 되도록 스케일링
4 RobustScaler 중앙값(median)과 IQR(interquartile range) 사용. 아웃라이어의 영향을 최소화
Contributor guide
No contributing guide indexed for this repository
Assessment
This issue has not been assessed yet.