QueryParserUtil, big query with wildcards -> runs endlessly and produces heavy load [LUCENE-5791]
- Dominant language
- Java
- Stars
- 3.6k
- Forks
- 1.4k
- Avg merge
- 2d 11h
- Merged PRs (30d)
- 88
Description
The following "testcase" runs endlessly and produces VERY heavy load.
...
String query = "Lorem ipsum dolor sit amet, consetetur sadipscing elitr, sed diam nonumy eirmod tempor invidunt ut "
+ "labore et dolore magna aliquyam erat, sed diam voluptua. At vero eos et accusam et justo duo dolores et "
+ "ea rebum. Stet clita kasd gubergren, no sea takimata sanctus est Lorem ipsum dolor sit amet. "
+ "Lorem ipsum dolor sit amet, consetetur sadipscing elitr, sed diam nonumy eirmod tempor invidunt "
+ "ut labore et dolore magna aliquyam erat, sed diam voluptua. At vero eos et accusam et justo duo dolores "
+ "et ea rebum. Stet clita kasd gubergren, no sea takimata sanctus est Lorem ipsum dolor sit amet"; String query = query.replaceAll( "
s+", "\*" ); try { QueryParserUtil.parse( query, new String[] { "test" }, new Occur[] { Occur.MUST }, new KeywordAnalyzer() ); } catch ( Exception e ) { Assert.fail( e.getMessage() ); } ...
I don't say this testcase makes "sense", nevertheless the question remains whether this is a bug or a "feature"?
99% the threaddump/stacktrace looks as follows:
BasicOperations.determinize(Automaton) line: 680
Automaton.determinize() line: 759
SpecialOperations.getCommonSuffixBytesRef(Automaton) line: 165
CompiledAutomaton.<init>(Automaton, Boolean, boolean) line: 168
CompiledAutomaton.<init>(Automaton) line: 91
WildcardQuery(AutomatonQuery).<init>(Term, Automaton) line: 67
WildcardQuery.<init>(Term) line: 57
WildcardQueryNodeBuilder.build(QueryNode) line: 42
WildcardQueryNodeBuilder.build(QueryNode) line: 32
StandardQueryTreeBuilder(QueryTreeBuilder).processNode(QueryNode, QueryBuilder) line: 186
StandardQueryTreeBuilder(QueryTreeBuilder).process(QueryNode) line: 125
StandardQueryTreeBuilder(QueryTreeBuilder).build(QueryNode) line: 218
StandardQueryTreeBuilder.build(QueryNode) line: 82
StandardQueryTreeBuilder.build(QueryNode) line: 53
StandardQueryParser(QueryParserHelper).parse(String, String) line: 258
StandardQueryParser.parse(String, String) line: 168
QueryParserUtil.parse(String, String[], BooleanClause$Occur[], Analyzer) line: 119
IndexingTest.queryParserUtilLimit() line: 1450
---
Migrated from [LUCENE-5791](https://issues.apache.org/jira/browse/LUCENE-5791) by Clemens Wyss, updated Jun 28 2014
Environment:
```
Lucene 4.7.2
Java 6
```
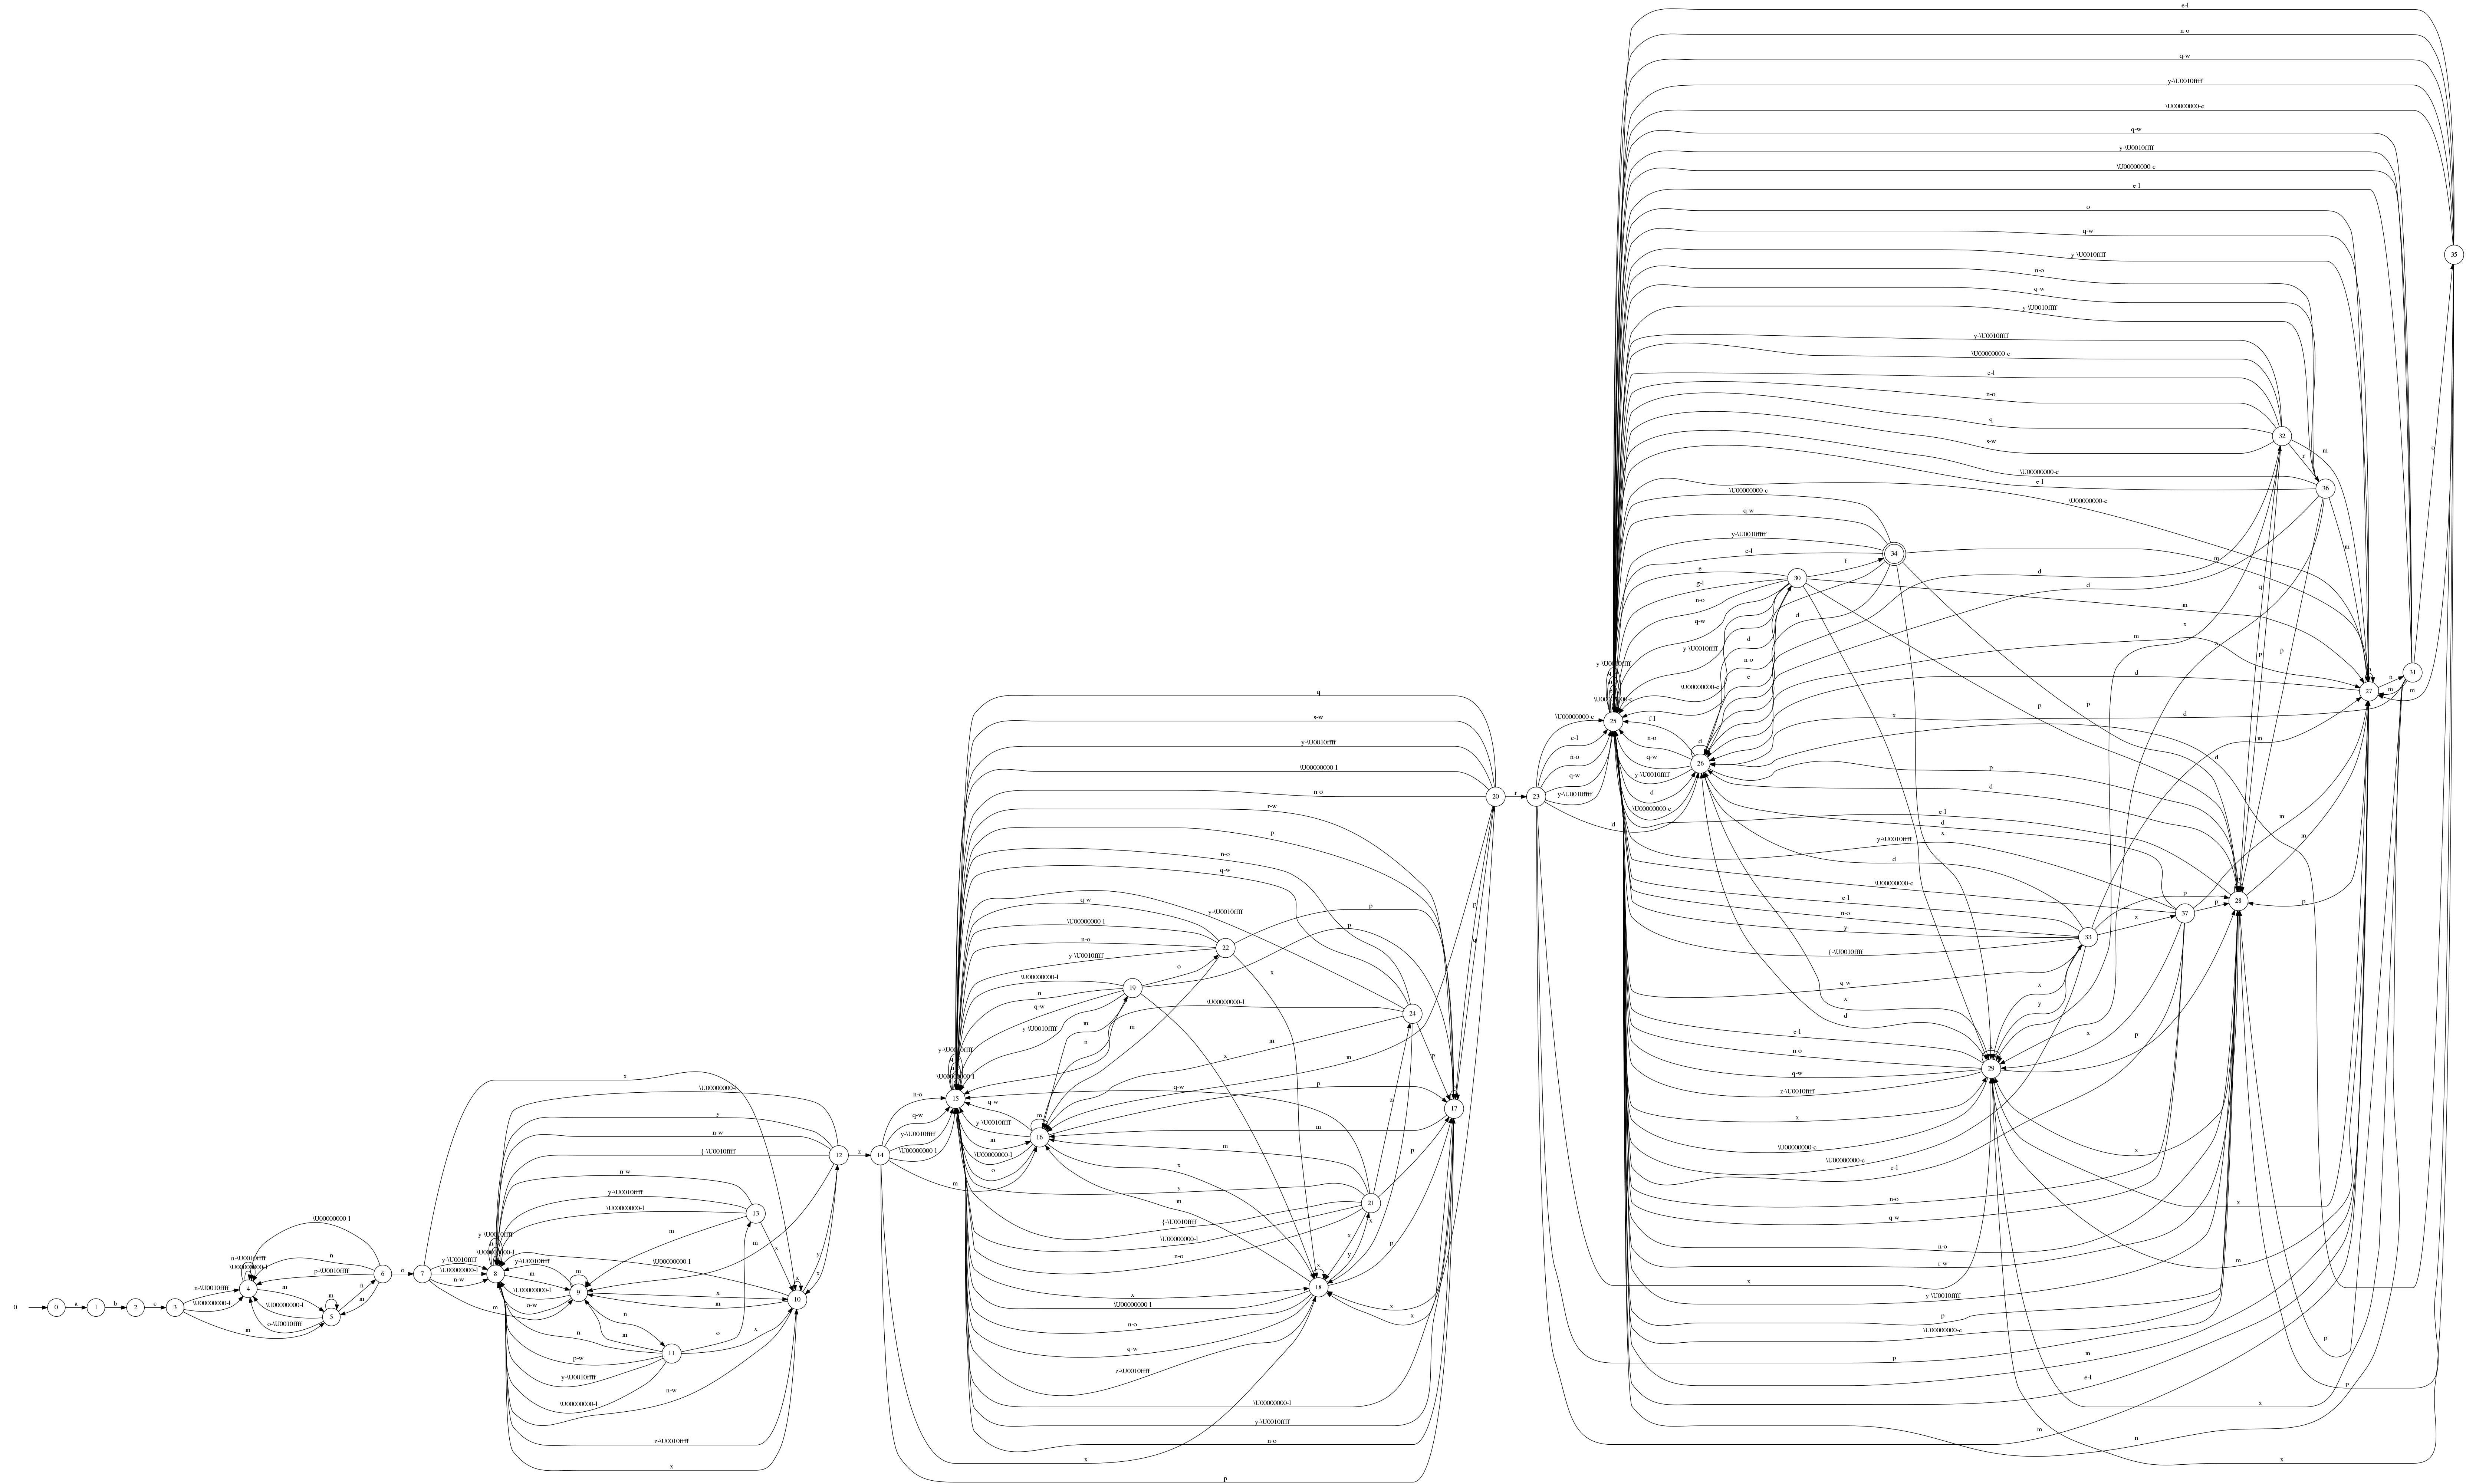
Attachments: [afterdet.png](https://apache.github.io/lucene-jira-archive/attachments/LUCENE-5791/afterdet.png)
Contributor guide
Research direction
Start with IndexingTest.queryParserUtilLimit at line 1450 and reproduce the wildcard query through QueryParserUtil.parse. Trace the reported path through WildcardQueryNodeBuilder, WildcardQuery, CompiledAutomaton, and Automaton.determinize to identify the source of the excessive work. Done means the behavior is characterized and the issue's expected handling is established, with a regression test if a fix is defined.
Written by the indexing model from the issue text.
Assessment
- Tech stack
- java
- Domain
- search
- Issue type
- Bug
- Difficulty
- 4/5
- Estimated time
- 3-5 days
- Activity status
- Stale
- Clarity
- Mostly clear
- Newbie friendliness
- 38/100